
19.通过MAPREDUCE 把收集数据进行清洗
在eclipse软件里创建一个maven项目
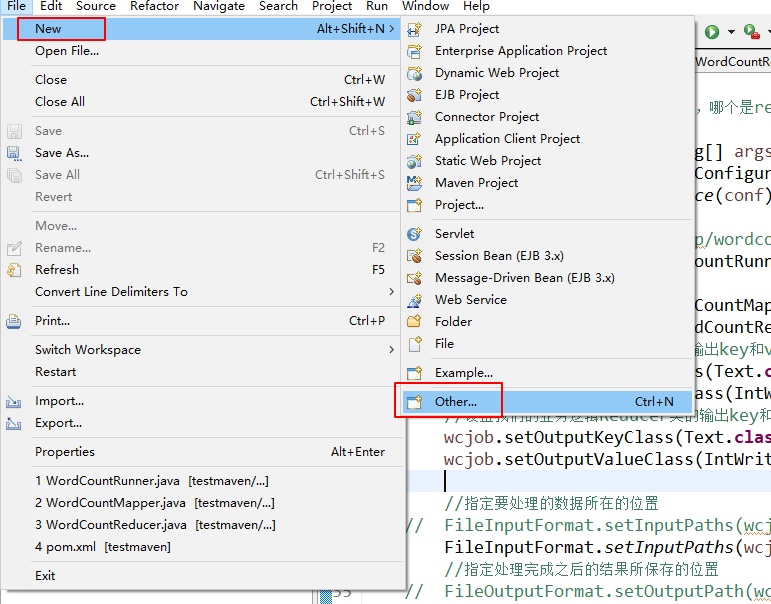
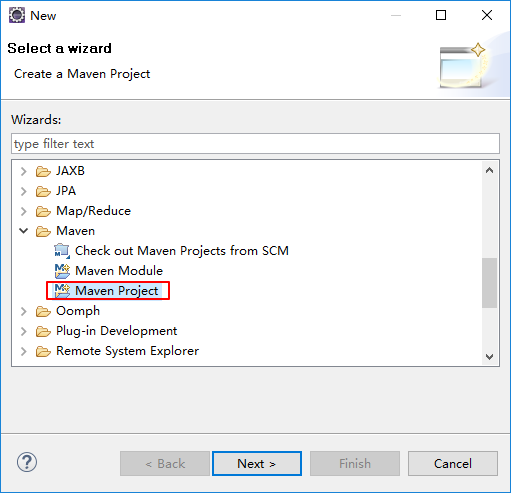
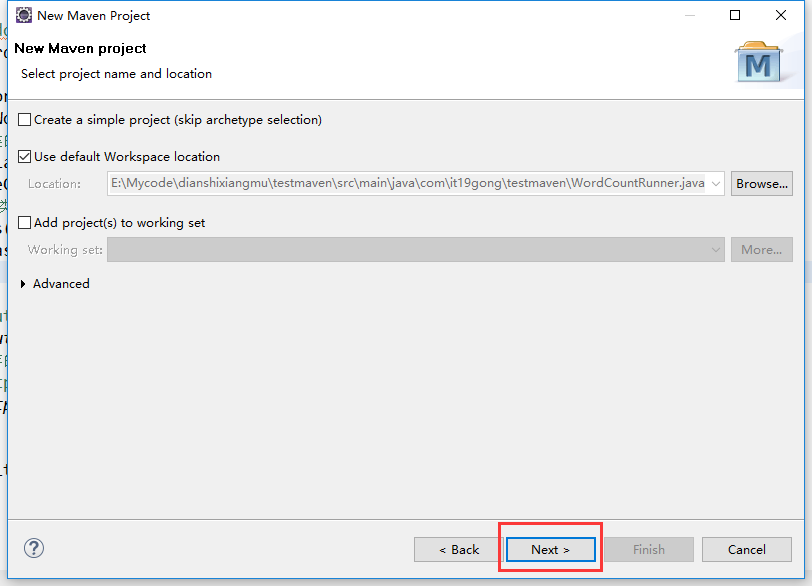
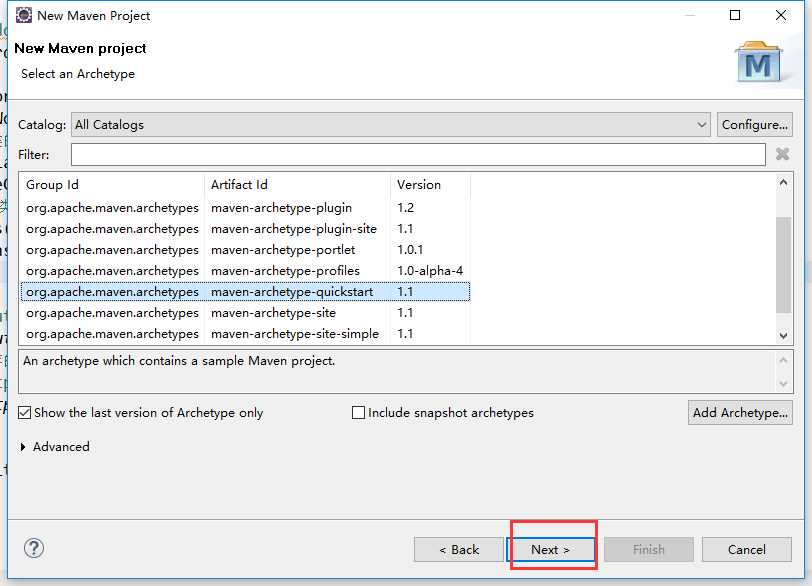
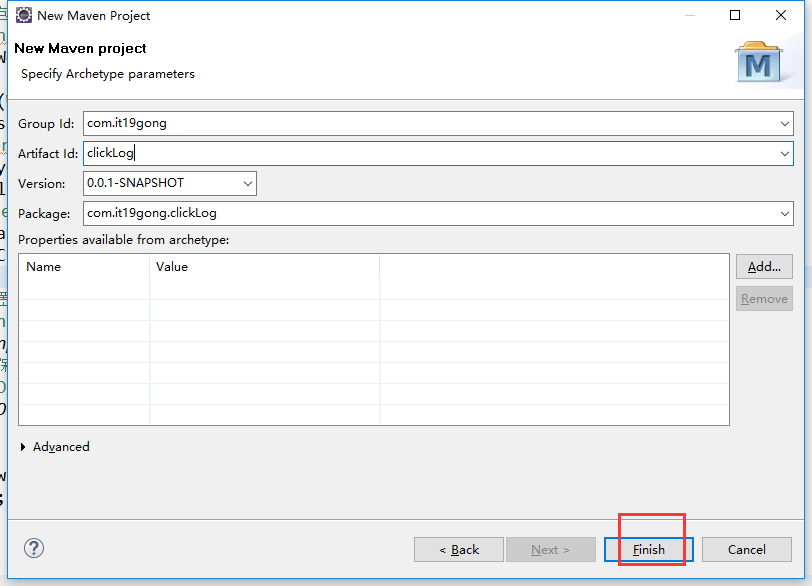
jdk要换成本地安装的1.8版本的
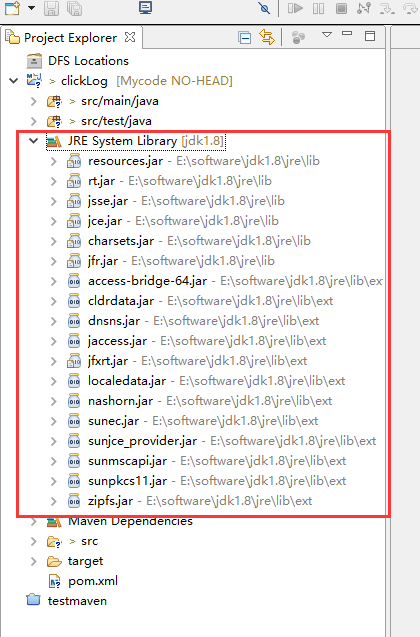
加载pom.xml文件
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

  xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

  <modelVersion>4.0.0</modelVersion>

  <groupId>com.it19gong</groupId>

  <artifactId>clickLog</artifactId>

  <version>0.0.1-SNAPSHOT</version>

  <packaging>jar</packaging>

  <name>clickLog</name>

  <url>http://maven.apache.org</url>

  <properties>

    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>

  </properties>

  <dependencies>

    <dependency>

      <groupId>junit</groupId>

      <artifactId>junit</artifactId>

      <version>3.8.1</version>

      <scope>test</scope>

    </dependency>

    <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>2.6.0</version>

        </dependency>

        <dependency>

            <groupId>jdk.tools</groupId>

            <artifactId>jdk.tools</artifactId>

            <version>1.8</version>

            <scope>system</scope>

            <systemPath>E:/software/jdk1.8/lib/tools.jar</systemPath>

        </dependency>

        <dependency>

            <groupId>org.apache.hive</groupId>

            <artifactId>hive-jdbc</artifactId>

            <version>2.1.0</version>

        </dependency>

        <dependency>

    <groupId>mysql</groupId>

    <artifactId>mysql-connector-java</artifactId>

    <version>5.1.33</version>

      </dependency>

  </dependencies>

</project>
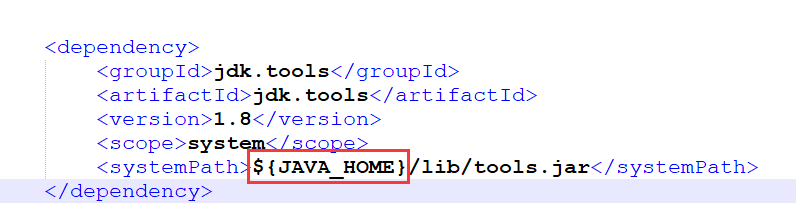
在加载依赖包的时候如果出现错误,在仓库里找不到1.8jdk.tools
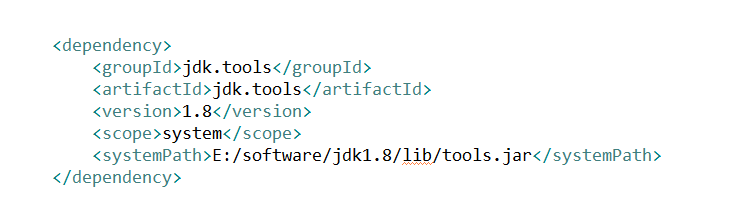
在这个地方改成本地的jdk绝对路径,再重新加载一次maven的依赖包
我这里修改成
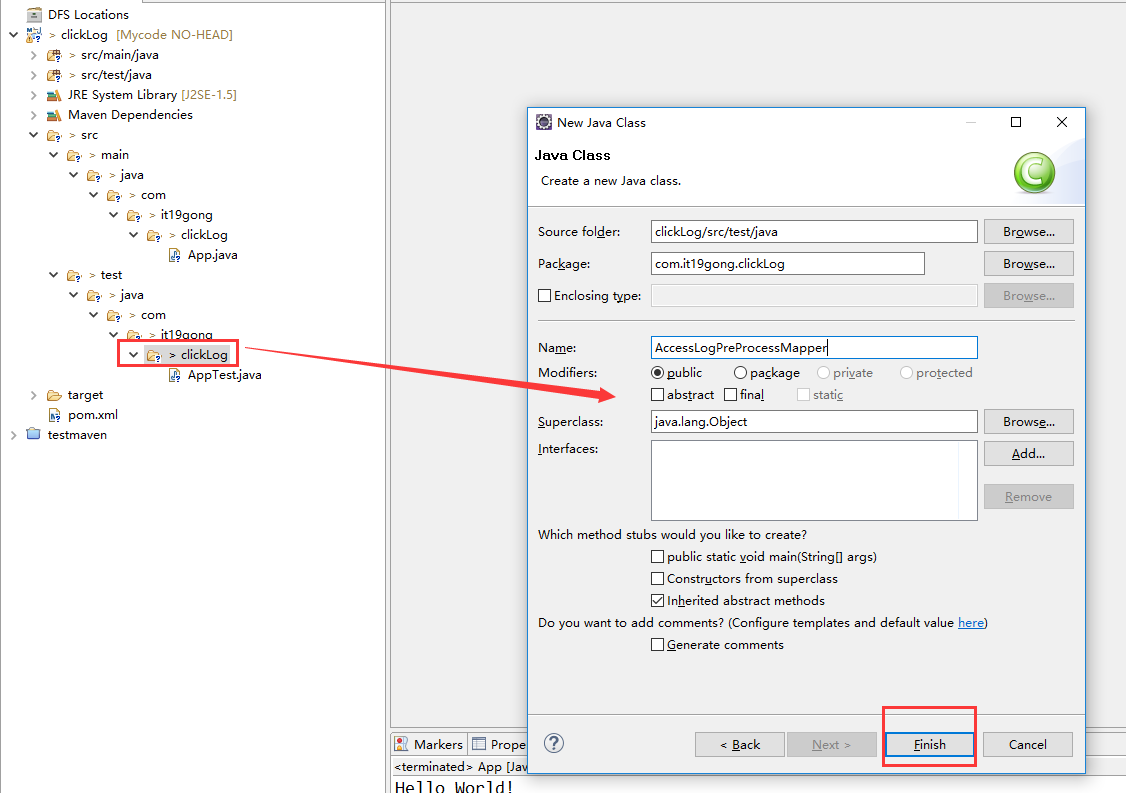
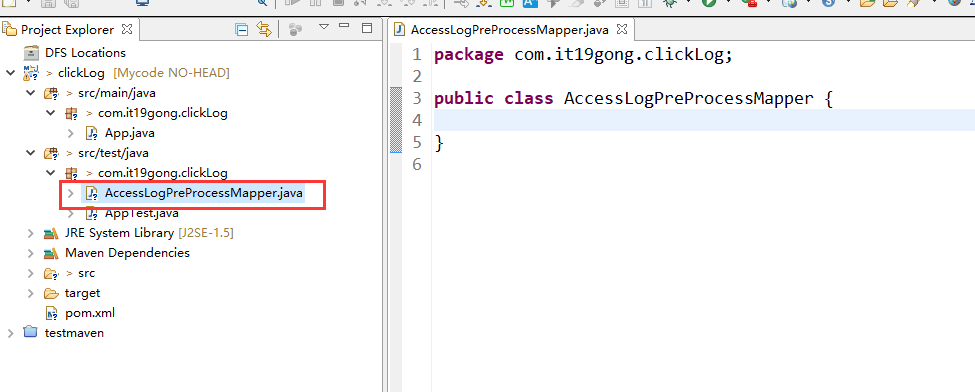
在项目下新建AccessLogPreProcessMapper类
package com.it19gong.clickLog;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

public class AccessLogPreProcessMapper extends Mapper<LongWritable, Text, Text, NullWritable> {

    Text text = new Text();

    @Override

protected void map(LongWritable key, Text value,Context context)

        throws IOException, InterruptedException {

       String itr[] = value.toString().split(" ");

       if (itr.length < 11)

        {

            return;

        }

        String ip = itr[0];

        String date = AnalysisNginxTool.nginxDateStmpToDate(itr[3]);

        String url = itr[6];

        String upFlow = itr[9];

        text.set(ip+","+date+","+url+","+upFlow);

        context.write(text, NullWritable.get());

}

}
创建AnalysisNginxTool类
package com.it19gong.clickLog;

import java.text.ParseException;

import java.text.SimpleDateFormat;

import java.util.Date;

import org.slf4j.Logger;

import org.slf4j.LoggerFactory;

public class AnalysisNginxTool

{

    private static Logger logger = LoggerFactory.getLogger(AnalysisNginxTool.class);

    public static String nginxDateStmpToDate(String date)

    {

        String res = "";

        try

        {

            SimpleDateFormat df = new SimpleDateFormat("[dd/MM/yyyy:HH:mm:ss");

            String datetmp = date.split(" ")[0].toUpperCase();

            String mtmp = datetmp.split("/")[1];

            DateToNUM.initMap();

            datetmp = datetmp.replaceAll(mtmp, (String) DateToNUM.map.get(mtmp));

            System.out.println(datetmp);

            Date d = df.parse(datetmp);

            SimpleDateFormat sdf = new SimpleDateFormat("yyyy/MM/dd");

            res = sdf.format(d);

        }

        catch (ParseException e)

        {

            logger.error("error:" + date, e);

        }

        return res;

    }

    public static long nginxDateStmpToDateTime(String date)

    {

        long l = 0;

        try

        {

            SimpleDateFormat df = new SimpleDateFormat("[dd/MM/yyyy:HH:mm:ss");

            String datetmp = date.split(" ")[0].toUpperCase();

            String mtmp = datetmp.split("/")[1];

            datetmp = datetmp.replaceAll(mtmp, (String) DateToNUM.map.get(mtmp));

            Date d = df.parse(datetmp);

            l = d.getTime();

        }

        catch (ParseException e)

        {

            logger.error("error:" + date, e);

        }

        return l;

    }

}
创建DateToNUM类
package com.it19gong.clickLog;

import java.util.HashMap;

public class DateToNUM

{

    public static HashMap map = new HashMap();

    public static void initMap()

    {

        map.put("JAN", "01");

        map.put("FEB", "02");

        map.put("MAR", "03");

        map.put("APR", "04");

        map.put("MAY", "05");

        map.put("JUN", "06");

        map.put("JUL", "07");

        map.put("AUG", "08");

        map.put("SEPT", "09");

        map.put("OCT", "10");

        map.put("NOV", "11");

        map.put("DEC", "12");

    }

}
新建AccessLogDriver类
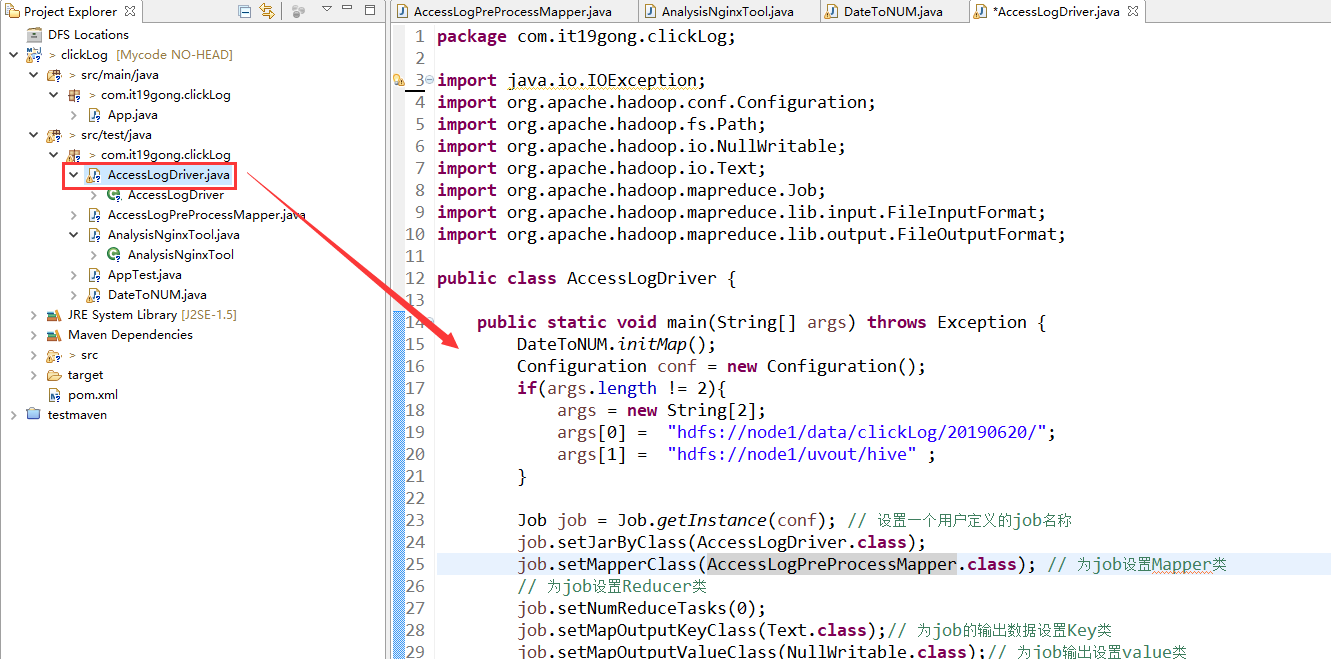
package com.it19gong.clickLog;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class AccessLogDriver {

    public static void main(String[] args) throws Exception {

        DateToNUM.initMap();

        Configuration conf = new Configuration();

        if(args.length != 2){

            args = new String[2];

            args[0] =  "hdfs://node1/data/clickLog/20190620/";

            args[1]    =  "hdfs://node1/uvout/hive" ;

        }

        Job job = Job.getInstance(conf); // 设置一个用户定义的job名称

        job.setJarByClass(AccessLogDriver.class);

        job.setMapperClass(AccessLogPreProcessMapper.class); // 为job设置Mapper类

        // 为job设置Reducer类

        job.setNumReduceTasks(0);

        job.setMapOutputKeyClass(Text.class);// 为job的输出数据设置Key类

        job.setMapOutputValueClass(NullWritable.class);// 为job输出设置value类

        FileInputFormat.addInputPath(job, new Path(args[0])); // 为job设置输入路径

        FileOutputFormat.setOutputPath(job, new Path(args[1]));// 为job设置输出路径

        System.exit(job.waitForCompletion(true) ? 0 : 1); // 运行job

    }

}
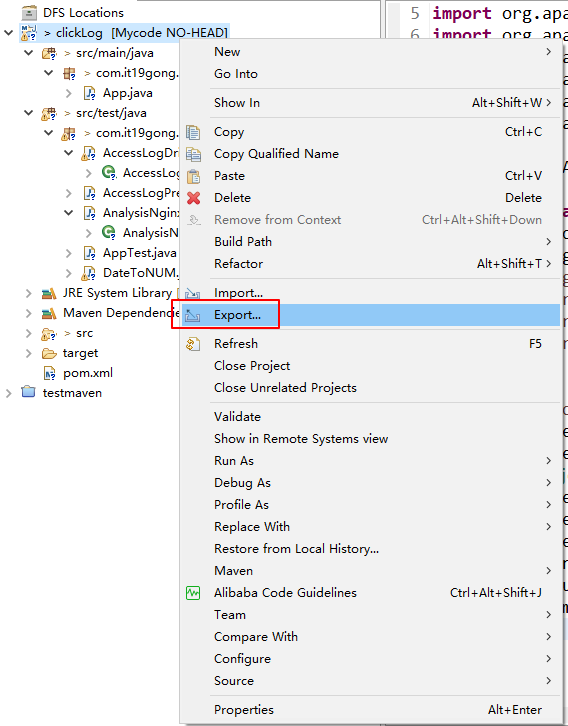
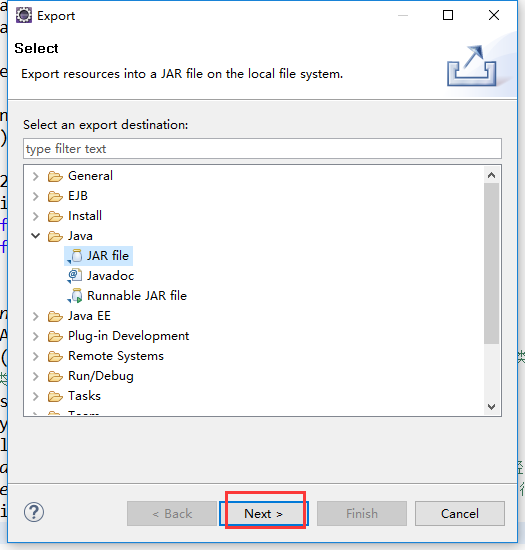
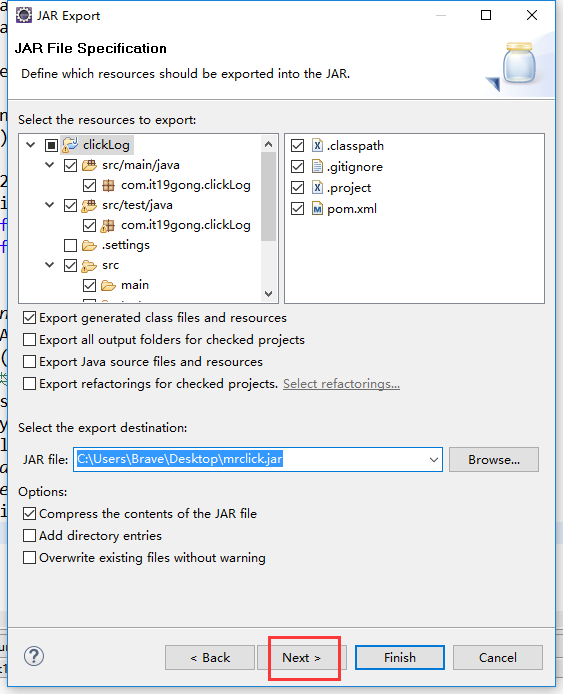
把工程打包成Jar包
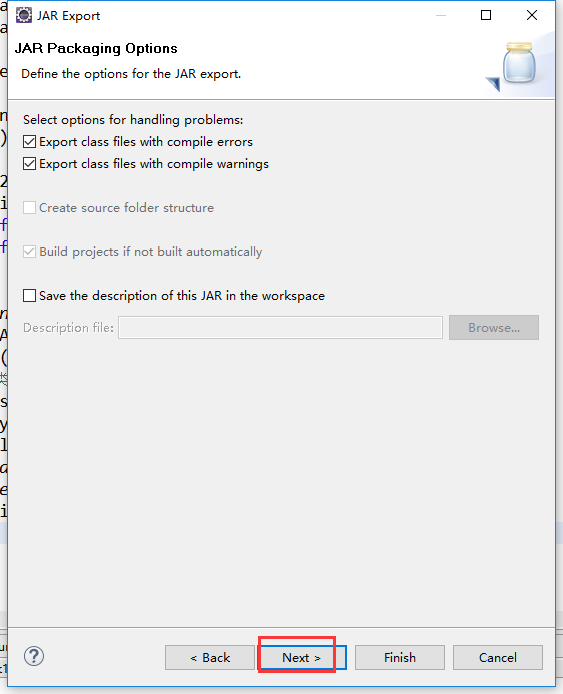
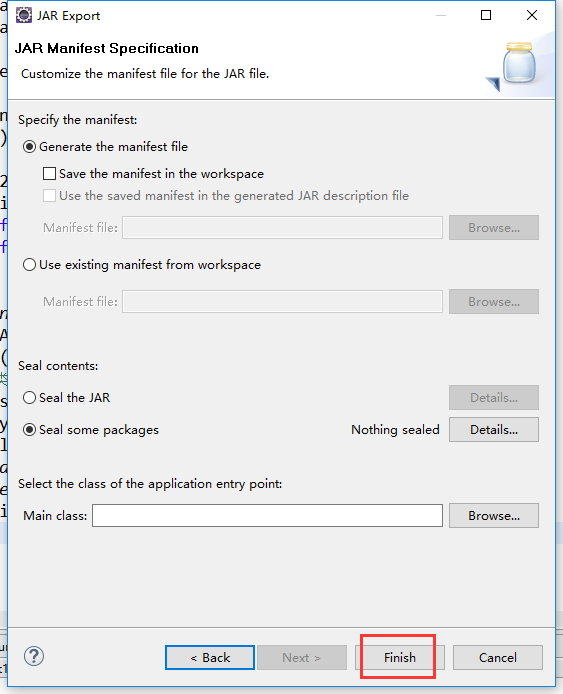
把jar包上传到集群

在集群上运行一下,先检查一下集群的启动进程
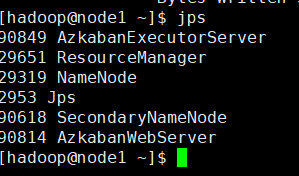
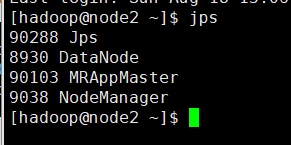

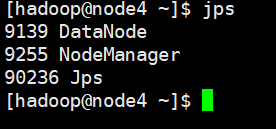
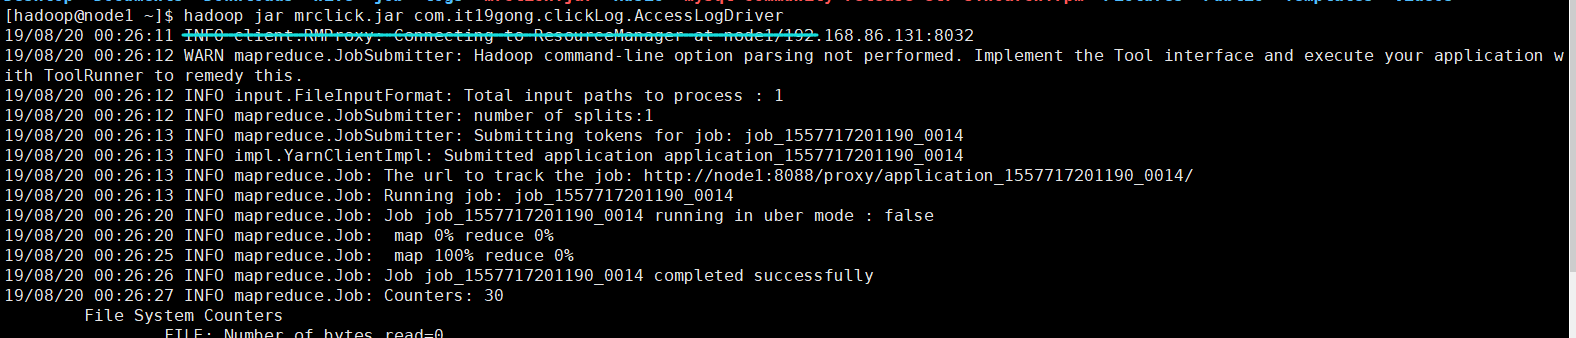
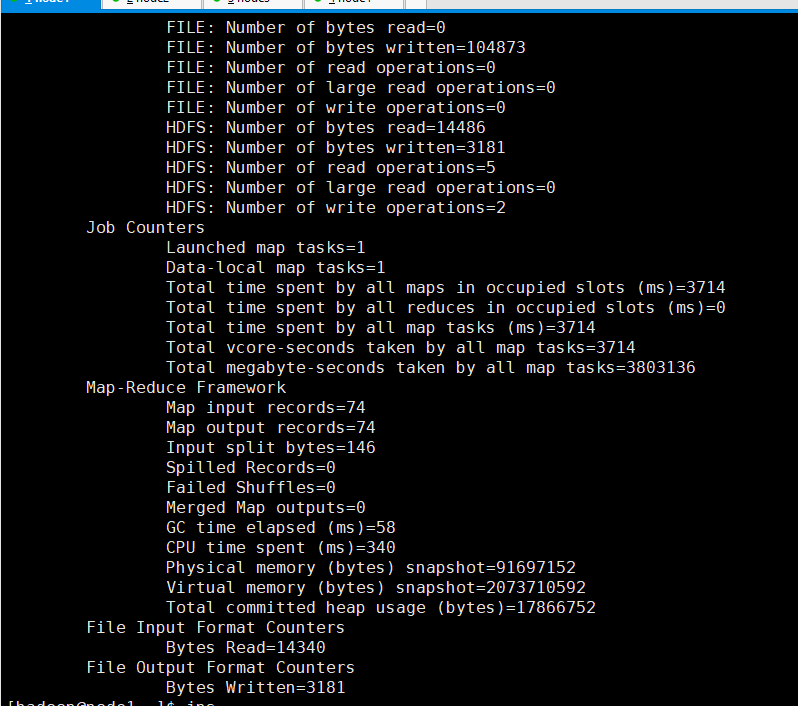
hadoop jar mrclick.jar com.it19gong.clickLog.AccessLogDriver
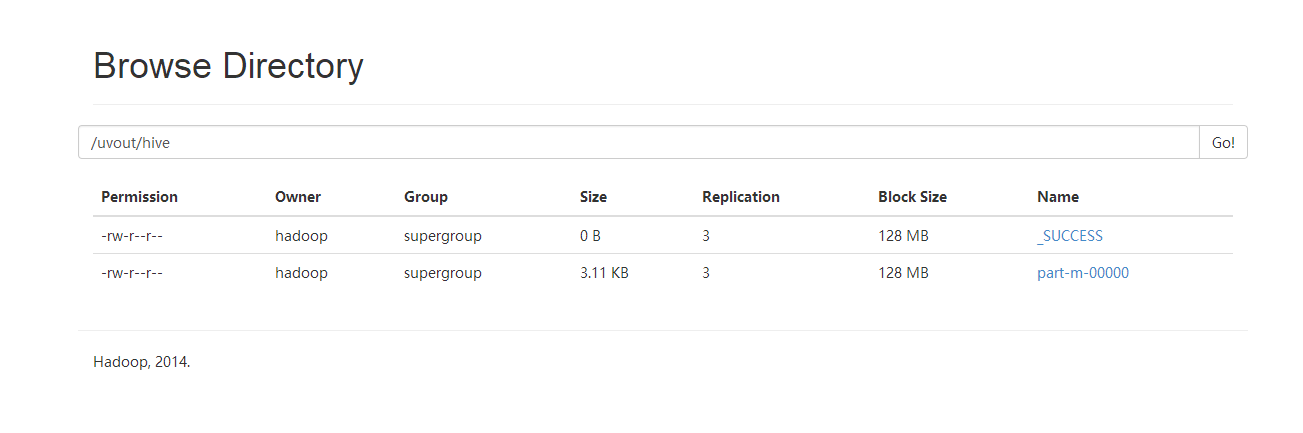
可以看到输出目录
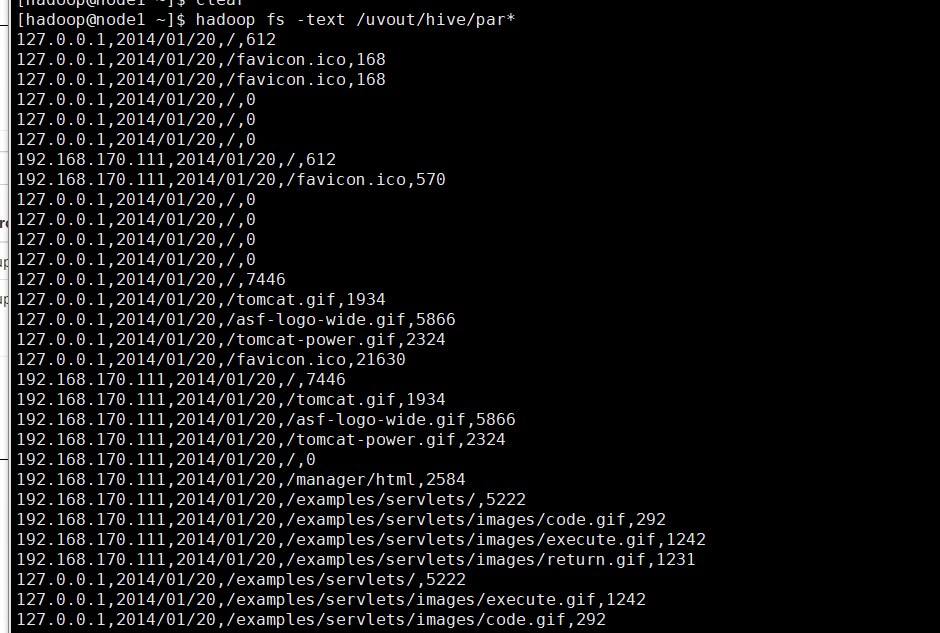
查看清洗后的数据
19.通过MAPREDUCE 把收集数据进行清洗的更多相关文章
- Hadoop 中利用 mapreduce 读写 mysql 数据
Hadoop 中利用 mapreduce 读写 mysql 数据 有时候我们在项目中会遇到输入结果集很大,但是输出结果很小,比如一些 pv.uv 数据,然后为了实时查询的需求,或者一些 OLAP ...
- Hadoop生态圈-使用MapReduce处理HBase数据
Hadoop生态圈-使用MapReduce处理HBase数据 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.对HBase表中数据进行单词统计(TableInputFormat) ...
- 使用MapReduce将HDFS数据导入Mysql
使用MapReduce将Mysql数据导入HDFS代码链接 将HDFS数据导入Mysql,代码示例 package com.zhen.mysqlToHDFS; import java.io.DataI ...
- 使用MapReduce将mysql数据导入HDFS
package com.zhen.mysqlToHDFS; import java.io.DataInput; import java.io.DataOutput; import java.io.IO ...
- 使用hadoop mapreduce分析mongodb数据
使用hadoop mapreduce分析mongodb数据 (现在很多互联网爬虫将数据存入mongdb中,所以研究了一下,写此文档) 版权声明:本文为yunshuxueyuan原创文章.如需转载请标明 ...
- 【原创】MapReduce备份Elasticsearch数据到HDFS(JAVA)
一.环境:JAVA8,Elasticsearch-5.6.2,Hadoop-2.8.1二.实现功能:mapreduce读elasticsearch数据.输出parquet文件.多输出路径三.主要依赖 ...
- Java 8 (5) Stream 流 - 收集数据
在前面已经使用过collect终端操作了,主要是用来把Stream中的所有元素结合成一个List,在本章中,你会发现collect是一个归约操作,就像reduce一样可以接受各种做法作为参数,将流中的 ...
- java8中用流收集数据
用流收集数据 汇总 long howManyDishes = menu.stream().collect(Collectors.counting()); int totalCalories = men ...
- 《Java 8 in Action》Chapter 6:用流收集数据
1. 收集器简介 collect() 接收一个类型为 Collector 的参数,这个参数决定了如何把流中的元素聚合到其它数据结构中.Collectors 类包含了大量常用收集器的工厂方法,toLis ...
随机推荐
- react-native-page-scrollview 的使用方法(实现酷炫的分页轮播效果,还支持自定义View)
react-native-page-scrollview 对ScrollView的封装,可以很方便的实现水平,垂直分页轮播效果.而且可以自定义分页宽高,和侧边View的旋转,透明度,大小等. 对于原生 ...
- HydroCMS-用ueditor无法实现word中图片转存的问题
图片的复制无非有两种方法,一种是图片直接上传到服务器,另外一种转换成二进制流的base64码目前限chrome浏览器使用首先以um-editor的二进制流保存为例:打开umeditor.js,找到UM ...
- Web上传大文件的解决方案
需求:项目要支持大文件上传功能,经过讨论,初步将文件上传大小控制在500M内,因此自己需要在项目中进行文件上传部分的调整和配置,自己将大小都以501M来进行限制. 第一步: 前端修改 由于项目使用的是 ...
- 【原创】洛谷 LUOGU P3379 【模板】最近公共祖先(LCA) -> 倍增
P3379 [模板]最近公共祖先(LCA) 题目描述 如题,给定一棵有根多叉树,请求出指定两个点直接最近的公共祖先. 输入输出格式 输入格式: 第一行包含三个正整数N.M.S,分别表示树的结点个数.询 ...
- a a[0] &a &a[0]的理解
数组中几个关键符号(a a[0] &a &a[0])的理解(前提是 int a[10])(1)这4个符号搞清楚了,数组相关的很多问题都有答案了.理解这些符号的时候要和左值右值结合起来, ...
- Java获取当前时间及String、datetime、date相互转化
一.获取当前系统时间和日期并格式化输出: import java.util.Date; import java.text.SimpleDateFormat; public class NowStrin ...
- 对 Python 迭代的深入研究
在程序设计中,通常会有 loop.iterate.traversal 和 recursion 等概念,他们各自的含义如下: 循环(loop),指的是在满足条件的情况下,重复执行同一段代码.比如 Pyt ...
- UML 2.5版本与UML分类概述
UML 2.5版本与UML分类概述 转 http://www.umlstudy.com/uml-25-diagrams.html UML简述 UML图是设计.实现或已经存在的系统模型的部分图形表示(视 ...
- egg源码浅析一npm init egg --type=simple
要egg文档最开始的时候,有这样的几条命令: 我们推荐直接使用脚手架,只需几条简单指令,即可快速生成项目: $ mkdir egg-example && cd egg-example ...
- python写入csv方法总结
最常用的一种方法,利用pandas包 import pandas as pd #任意的多组列表 a = [1,2,3] b = [4,5,6] #字典中的key值即为csv中列名 dataframe ...