
Hadoop---HDFS读写流程
Hadoop---HDFS
HDFS 性能详解
HDFS 天生是为大规模数据存储与计算服务的,而对大规模数据的处理目前还有没比较稳妥的解决方案。 HDFS 将将要存储的大文件进行分割,分割到既定的存储块(Block)中进行了存储,并通过本地设定的任务节点进行预处理,从而解决对大文件存储与计算的需求。在实际工作中,除了某些尺寸较大的文件要求进行存储及计算,更多时候是会产生并存储无数的小尺寸文件。而对于小尺寸文件的处理, HDFS 没有要求使用者进行特殊的优化,也就是说可以通过普通的编程与压缩方式进行解决。对于大部分的文件来说,一旦文件生成完毕,更多的是对文件进行读取而非频繁的修改。 HDFS 对于普通文件的读取操作来说,一般情况下主要分成两种。大规模的持续性读取与小型化随机读取。针对这两种读取方式, HFDS 分别采取了不同的对应策略。对于大规模的数据读取, HDFS 采用的是在存储时进行优化,也就是说在文件进入 HDFS 系统时候,就对较大体积的文件存储时就采用集中式存储的方式,使得未来的读取能够在一个文件一个连续的区域进行,从而节省寻址及复制时间。而对于小数据的读取, HDFS更多的做法是在把小规模的随机读取操作合并并对读取顺序进行排序,这样可以在一定程度上实现按序读取,提高读取效率。因此可以说, HDFS 更多是考虑到数据读取的批处理,而不是对单独命令的执行。
架构与基本存储单元
对于 HDFS 架构来说,一个 HDFS 基本集群包括两大部分,即 NameNode 与 DataNode节点,其作用是将管理与工作进行分离。
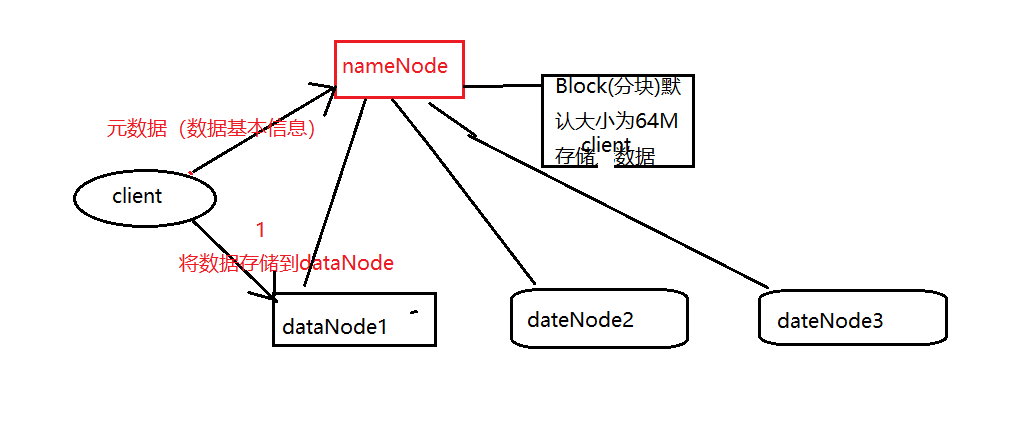
通常来说,一个集群中会有一个 NameNode 与若干个 DataNode。 NameNode 是一个集群的主服务器,主要是用于对 HDFS 中所有的文件及内容数据进行维护,并不断读取记录集群中 DataNode 主机情况与工作状态,并通过读取与写入镜像日志文件的方式进行存储。而 DataNode 是在 HDFS 集群中担任任务具体执行,是整个集群的工作节点,文件被分成若干个相同大小的数据块,分别存储在若干个 DataNode 上,DataNode 定时定期向集群内 NameNode 发送自己的运行状态与存储内容,并根据 NameNode发送的指令进行工作。

NameNode 负责接受客户端发送过来的信息,然后将文件存储信息位置发送给提交请求的客户端,由客户端直接与 DataNode 进行联系,进行部分文件的运算与操作。对于文件存储来说, HDFS 使用 Block(分块)来对文件的存储进行操作。对于传统磁盘存储来说,磁盘都有默认的存储单元,通常使用的是数据定义中的最小存储单元。 Block 是HDFS 的基本存储单元,默认大小是 64M,这个大小远远大于一般系统文件的默认存储大小。这样做的一个最大好处减少文件寻址时间。除此之外,采用 Block 对文件进行存储,大大提高了文件的灾难生存与恢复能力, HDFS还对已经存储的 Block 进行多副本备份,将每个 Block 至少复制到 3 个相互独立的硬件上。这样做的好处就是确保在发生硬件故障的时候,能够迅速的从其他硬件中读取相应的文件数据。而具体复制到多少个独立硬件上也是可以设置的。
数据存储位置与复制详解
同一节点上的存储数据
同一机架上不同节点上的存储数据
同一数据中心不同机架上的存储数据
不同数据中心的节点
HDFS 数据存放策略就是采用同节点与同机架并行的存储方式。在运行客户端的当前节点上存放第一个副本,第二个副本存放在于第一个副本不同的机架上的节点,第三个副本放置的位置与第二个副本在同一个机架上而非同一个节点。
运行时:

HDFS的读写流程:
读:
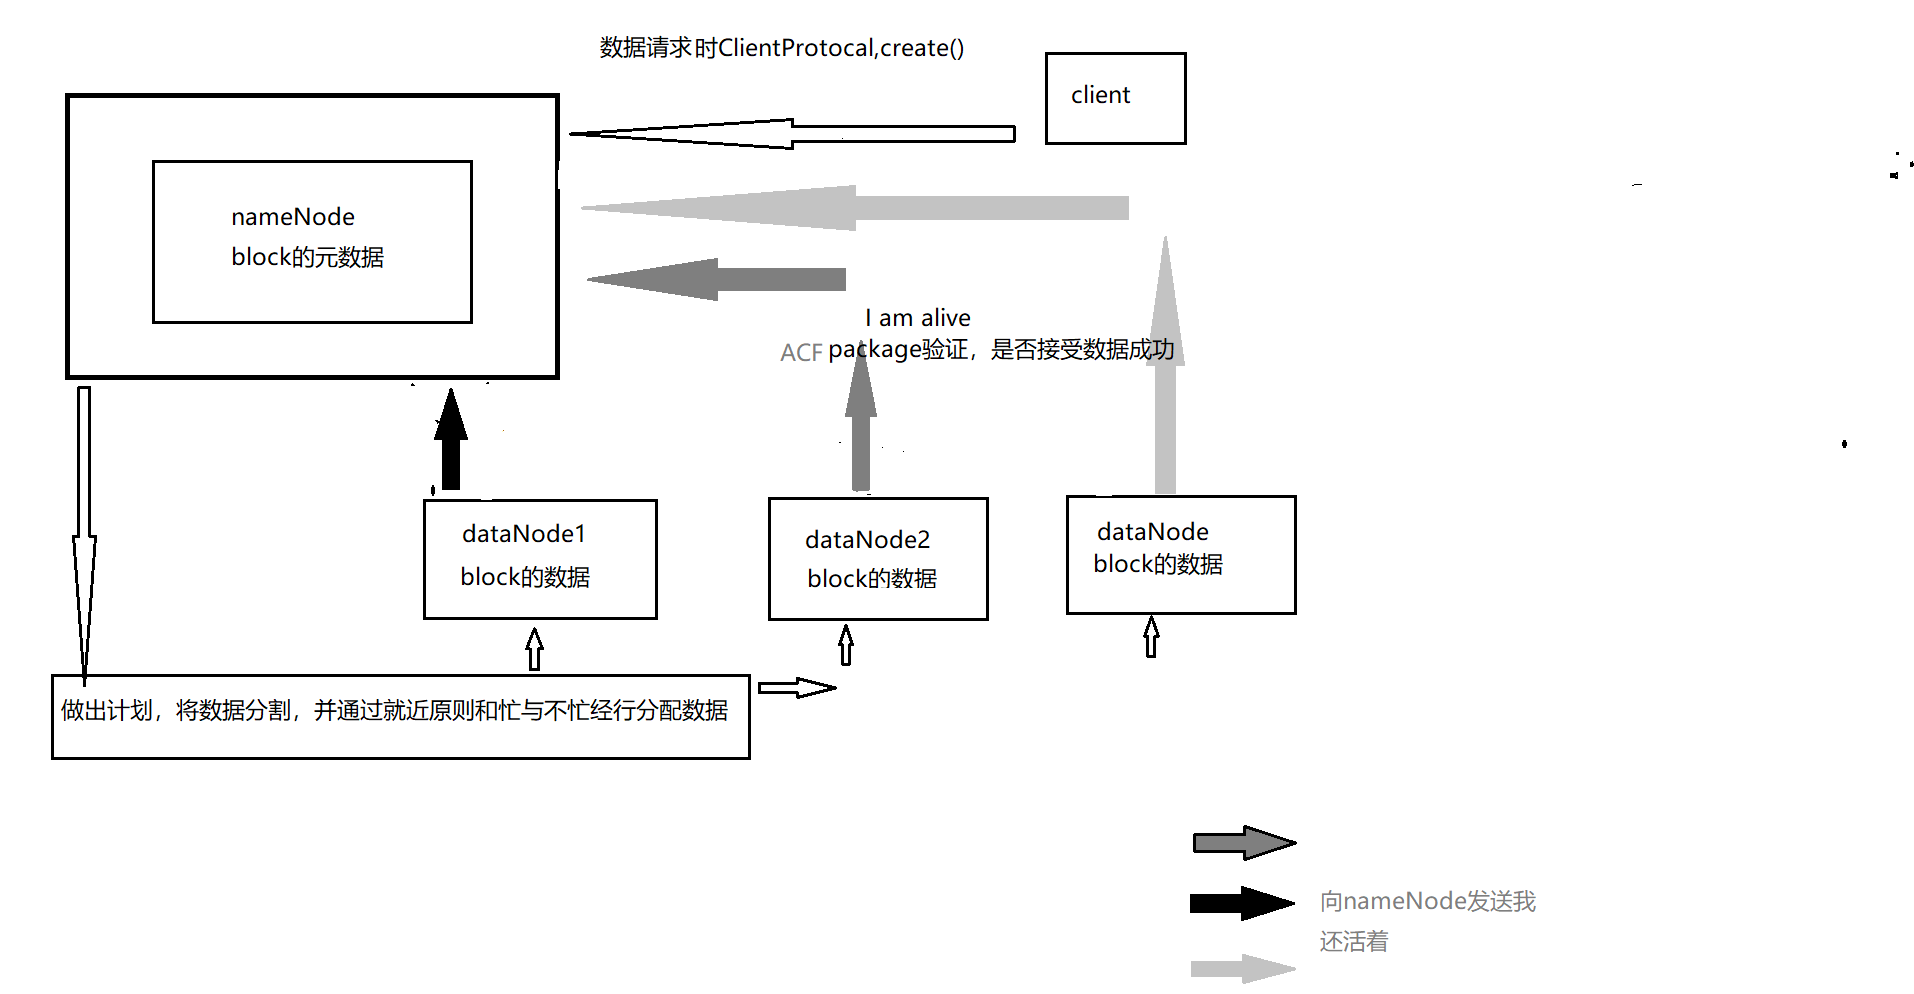
1.client客户端调用DistributedFileSystem.create()方法。
2.底层调用ClientProtical.create()方法,并创建文件的操作记录到editlog中,返回一个HDFSDateOutPutStream对象,底层时对DFSOutStream进行包装。
3.nameNode收到数据元(默认为128M),NameNode返回一个LocalBlock对象,建立数据流管道写数据块
4.建立管道后,HDFS客户端可以向管道流内写数据,它将数据切为一个个packet,然后按dataNode就近原则和,忙与不忙进行发送,dataNode。
5.dataNode成功接受后,通过ACK验证后向nameNode汇报,nameNode会更新数据节点的对应关系,以及I am alive
6.完成操作后,客户端关闭输出流
写:
写流程则相反。
Hadoop---HDFS读写流程的更多相关文章
- 大数据系列文章-Hadoop的HDFS读写流程(二)
在介绍HDFS读写流程时,先介绍下Block副本放置策略. Block副本放置策略 第一个副本:放置在上传文件的DataNode:如果是集群外提交,则随机挑选一台磁盘不太满,CPU不太忙的节点. 第二 ...
- 【转】HDFS读写流程
概述开始之前先看看其基本属性,HDFS(Hadoop Distributed File System)是GFS的开源实现. 特点如下: 能够运行在廉价机器上,硬件出错常态,需要具备高容错性流式数据访问 ...
- HDFS读写流程(转载)
概述开始之前先看看其基本属性,HDFS(Hadoop Distributed File System)是GFS的开源实现.特点如下: 能够运行在廉价机器上,硬件出错常态,需要具备高容错性 ...
- Hadoop之HDFS读写流程
hadoophdfs 1. HDFS写流程 2. HDFS写流程 1. HDFS写流程 HDFS写流程 副本存放策略: 上传的数据块后,触发一个新的线程,进行存放. 第一个副本:与client最近的机 ...
- 超详细的HDFS读写流程详解(最容易理解的方式)
HDFS采用的是master/slaves这种主从的结构模型管理数据,这种结构模型主要由四个部分组成,分别是Client(客户端).Namenode(名称节点).Datanode(数据节点)和Seco ...
- Hadoop -- HDFS 读写数据
一.HDFS读写文件过程 1.读取文件过程 1) 初始化FileSystem,然后客户端(client)用FileSystem的open()函数打开文件 2) FileSyst ...
- HDFS 读写流程-译
HDFS 文件读取流程 Client 端调用 DistributedFileSystem 对象的 open() 方法. 由 DistributedFileSystem 通过 RPC 向 NameNod ...
- 【大数据系列】Hadoop DataNode读写流程
DataNode的写操作流程 DataNode的写操作流程可以分为两部分,第一部分是写操作之前的准备工作,包括与NameNode的通信等:第二部分是真正的写操作. 一.准备工作 1.首先,HDFS c ...
- HDFS 读写流程-英
HDFS 文件读取流程 The client opens the file it wishes to read by calling open() on the FileSystem object, ...
- HDFS读写流程(重点)
@ 目录 一.写数据流程 举例: 二.异常写流程 读数据流程 一.写数据流程 ①服务端启动HDFS中的NN和DN进程 ②客户端创建一个分布式文件系统客户端,由客户端向NN发送请求,请求上传文件 ③NN ...
随机推荐
- EM算法——Expectation-Maximization
最大似然估计 一个栗子:假如去赌场,但是不知道能不能赚钱,你就在门口堵着出来一个人就问一个赚了还是赔了,如果问了5个人都说赚了,那么你就会认为,赚钱的概率肯定是非常大的. 已知:(1)样本服从分部的模 ...
- 【Mysql】key 、primary key 、unique key 与index区别
参考:https://blog.csdn.net/nanamasuda/article/details/52543177 总的来说,primary key .unique key 这些key建立的同时 ...
- _itemmod_creation_enchant
该表控制物品产生时自动获得随机附魔效果 comment 备注 entry 物品entry slot 附魔位置1-5,这些位置都可以用来产生自带附魔效果 groupId 附魔组Id 对就_ ...
- 【BZOJ】1798: [Ahoi2009]Seq 维护序列seq
题目链接:http://www.lydsy.com/JudgeOnline/problem.php?id=1798 大概就是维护两个标记的线段树模板题. 设定优先级,先乘后加(只是相对的),$push ...
- win 10 安装visual studio 2010
链接: https://pan.baidu.com/s/1JzA2Ei8NEGRPck253NUM9g 提取码: 52pt 点击下一步即可.
- "不是内部或外部命令"
问题描述: 使用cmd 运行某个路径下(一般是C:PROGRAM FILES\...或者E:\program files\....或者D:\program files\......下面的某个)的exe ...
- Cocos Creator 智能提示 for WebStorm
0.首先下载安装Node.js,否则下面将找不到关于Node.js的设置选项. 1.智能提示设置File->Settings ①设置为最新的ECMAScript版本 ②Enable Node.j ...
- css各种练习
2017年10月22日 <!DOCTYPE html> <html lang="en"> <head> <meta charset=&qu ...
- 最大频率栈 Maximum Frequency Stack
2018-10-06 22:01:11 问题描述: 问题求解: 为每个频率创建一个栈即可. class FreqStack { Map<Integer, Integer> map; Lis ...
- Java原子操作类AtomicInteger应用场景
Java中有那么一些类,是以Atomic开头的.这一系列的类我们称之为原子操作类.以最简单的类AtomicInteger为例.它相当于一个int变量,我们执行Int的 i++ 的时候并不是一个原子操作 ...