
爬虫_古诗文网(队列,多线程,锁,正则,xpath)
 import requests

 from queue import Queue

 import threading

 from lxml import etree

 import re

 import csv

 class Producer(threading.Thread):

     headers = {'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.75 Safari/537.36'}

     def __init__(self, page_queue, poem_queue, *args, **kwargs):

         super(Producer, self).__init__(*args, **kwargs)

         self.page_queue = page_queue

         self.poem_queue = poem_queue

     def run(self):

         while True:

             if self.page_queue.empty():

                 break

             url = self.page_queue.get()

             self.parse_html(url)

     def parse_html(self, url):

         # poems = []

         headers = {'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.75 Safari/537.36'}

         response = requests.get(url, headers=headers)

         response.raise_for_status()

         html = response.text

         html_element = etree.HTML(html)

         titles = html_element.xpath('//div[@class="cont"]//b/text()')

         contents = html_element.xpath('//div[@class="contson"]')

         hrefs = html_element.xpath('//div[@class="cont"]/p[1]/a/@href')

         for index, content in enumerate(contents):

             title = titles[index]

             content = etree.tostring(content, encoding='utf-8').decode('utf-8')

             content = re.sub(r'<.*?>|\n|', '', content)

             content = re.sub(r'\u3000\u3000', '', content)

             content = content.strip()

             href = hrefs[index]

             self.poem_queue.put((title, content, href))

 class Consumer(threading.Thread):

     def __init__(self, poem_queue, writer, gLock, *args, **kwargs):

         super(Consumer, self).__init__(*args, **kwargs)

         self.writer = writer

         self.poem_queue = poem_queue

         self.lock = gLock

     def run(self):

         while True:

             try:

                 title, content, href = self.poem_queue.get(timeout=20)

                 self.lock.acquire()

                 self.writer.writerow((title, content, href))

                 self.lock.release()

             except:

                 break

 def main():

     page_queue = Queue(100)

     poem_queue = Queue(500)

     gLock = threading.Lock()

     fp = open('poem.csv', 'a',newline='', encoding='utf-8')

     writer = csv.writer(fp)

     writer.writerow(('title', 'content', 'href'))

     for x in range(1, 100):

         url = 'https://www.gushiwen.org/shiwen/default.aspx?page=%d&type=0&id=0' % x

         page_queue.put(url)

     for x in range(5):

         t = Producer(page_queue, poem_queue)

         t.start()

     for x in range(5):

         t = Consumer(poem_queue, writer, gLock)

         t.start()

 if __name__ == '__main__':

     main()
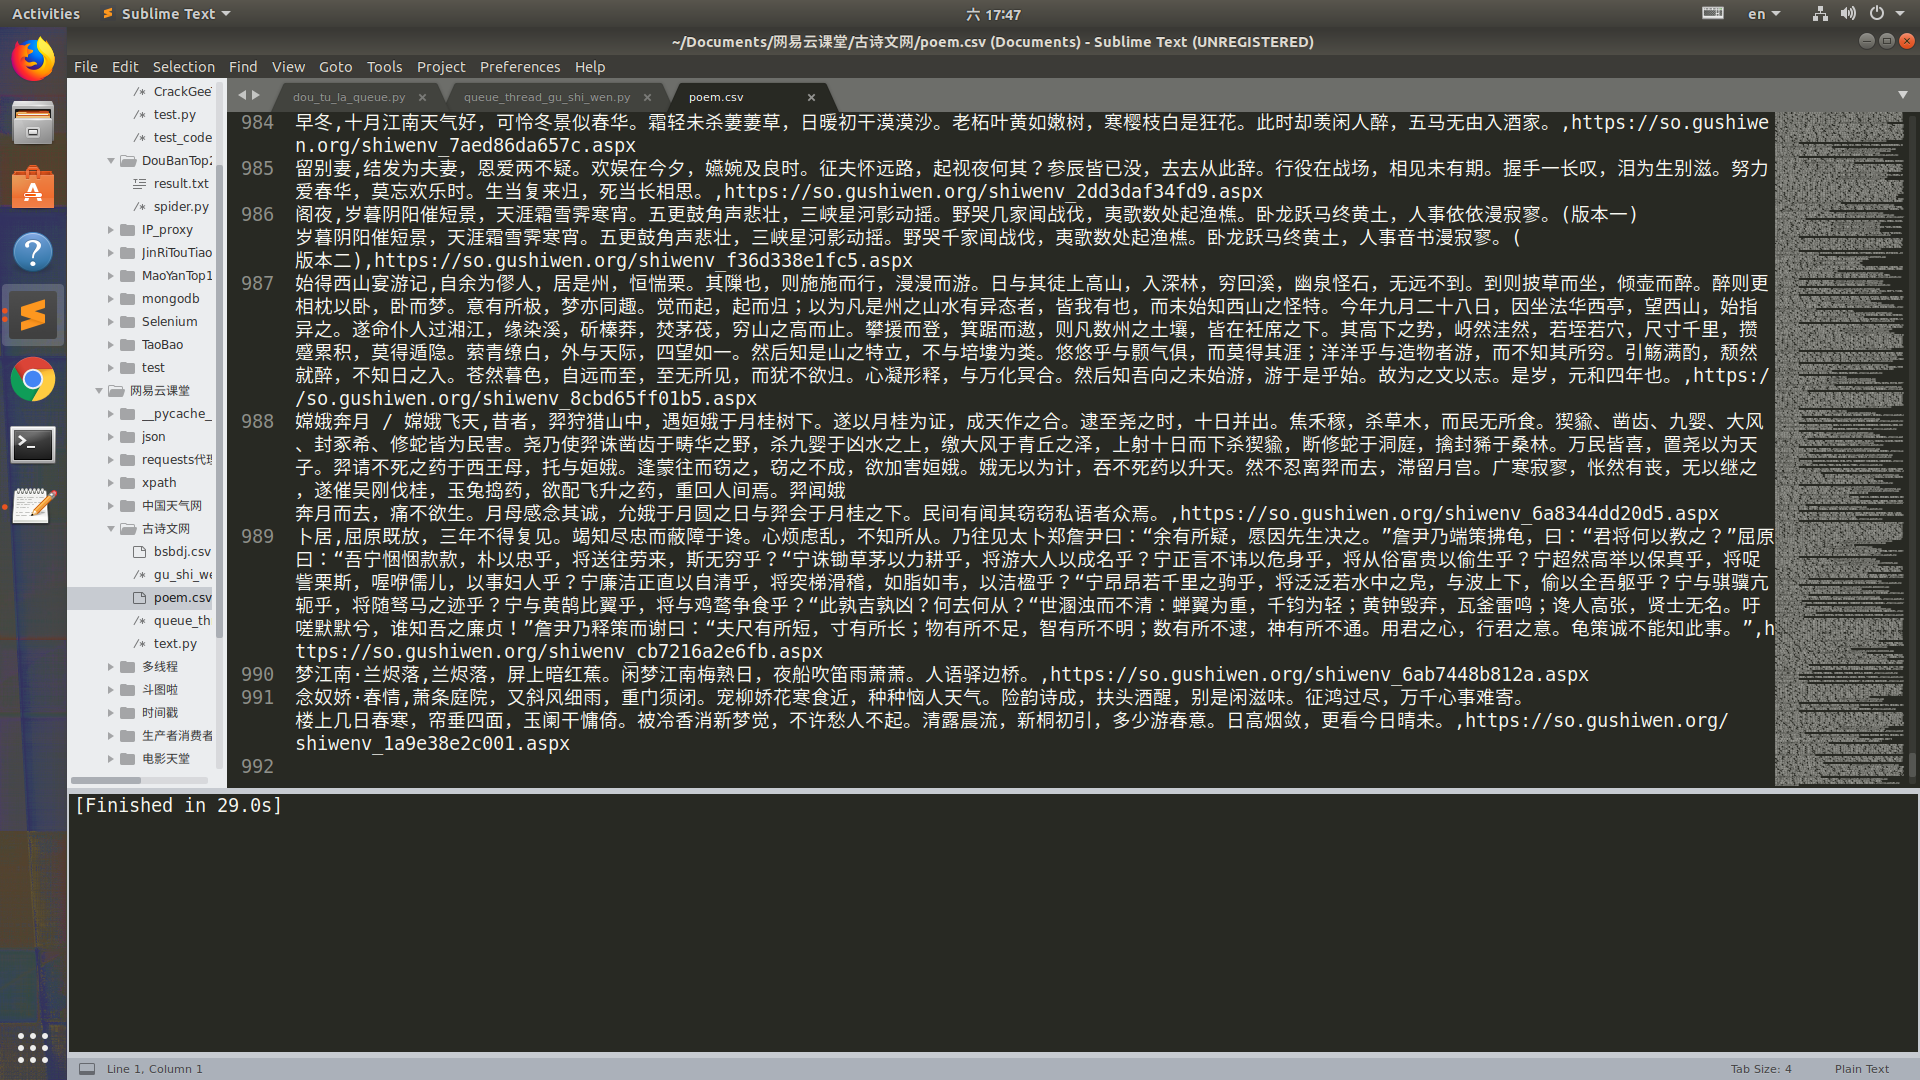
运行结果
爬虫_古诗文网(队列,多线程,锁,正则,xpath)的更多相关文章
- 爬虫_中国天气网_文字天气预报(xpath)
import requests from lxml import etree headers = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/5 ...
- requests_cookie登陆古诗文网。session的使用
通过登录失败,快速找到登录接口 获取hidden隐藏域中的id的value值 # 通过登陆 然后进入到主页面 # 通过找登陆接口我们发现 登陆的时候需要的参数很多 # _VIEWSTATE: /m1O ...
- 爬虫_豆瓣全部正在热映电影 (xpath)
单纯地练习一下xpath import requests from lxml import etree def get_url(url): html = requests.get(url) retur ...
- Python爬虫入门教程 11-100 行行网电子书多线程爬取
行行网电子书多线程爬取-写在前面 最近想找几本电子书看看,就翻啊翻,然后呢,找到了一个 叫做 周读的网站 ,网站特别好,简单清爽,书籍很多,而且打开都是百度网盘可以直接下载,更新速度也还可以,于是乎, ...
- 初识python 之 爬虫:使用正则表达式爬取“古诗文”网页数据
通过requests.re(正则表达式) 爬取"古诗文"网页数据. 详细代码如下: #!/user/bin env python # author:Simple-Sir # tim ...
- Java多线程--锁的优化
Java多线程--锁的优化 提高锁的性能 减少锁的持有时间 一个线程如果持有锁太长时间,其他线程就必须等待相应的时间,如果有多个线程都在等待该资源,整体性能必然下降.所有有必要减少单个线程持有锁的时间 ...
- synchronized与static synchronized 的差别、synchronized在JVM底层的实现原理及Java多线程锁理解
本Blog分为例如以下部分: 第一部分:synchronized与static synchronized 的差别 第二部分:JVM底层又是怎样实现synchronized的 第三部分:Java多线程锁 ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- SANSA 上上洛可可 贾伟作品 高山流水 香炉 香插香台香具 高端商务礼品 黑色【正品 价格 图片 折扣 评论】_尚品网ShangPin.com
SANSA 上上洛可可 贾伟作品 高山流水 香炉 香插香台香具 高端商务礼品 黑色[正品 价格 图片 折扣 评论]_尚品网ShangPin.com
随机推荐
- 用HttpClient和用HttpURLConnection做爬虫发现爬取的代码少了的问题
最近在学习用java来做爬虫但是发现不管用那种方式都是爬取的代码比网页的源码少了很多在网上查了很多都说是inputStream的缓冲区太小而爬取的网页太大导致读取出来的网页代码不完整,但是后面发现并不 ...
- .net之httphandler小记
本地调试代码遇到的一个问题,没有走URL路由器(UrlReWriter : IHttpHandlerFactory),于是网上科普了一下原理,主要有两点: 1.asp.net在处理http请求时,会由 ...
- openstack-KVM-vCPU
一.KVM基础功能 (1)支持 硬件支持 VT-x VT-d 系统支持 kernel > 3.5 (2)计算机系统的子系统 CPU 处理器 Memory 内存 Storage 存储 Networ ...
- 运行Maven项目时出现invalid LOC header (bad signature)错误,Tomcat不能正常启动
作为Maven小白,今天这问题困扰了我好久,经过多次在网上查询,终于找到了原因.明明一个小问题却耗费很多时间,着实不应该,所以必须记录一下. 报错信息如下: 对话框: 控制台: <span st ...
- zabbix使用jmx监控tomcat
zabbix监控Tomcat/JVM实例性能(115) – 运维生存时间http://www.ttlsa.com/zabbix/zabbix-use-jmx-monitor-tomcat/ zabbi ...
- JSP页面导致tomcat内存溢出一例
今天发现一个奇怪的问题,一个tomcat应用,里面只有一个单纯的jsp页面,而且这个jsp页面没有任何java代码——想用这个jsp页面配合tomcat完成一个性能验证.但是用jmeter压测了几分钟 ...
- [转帖]Linux的标准输入 标准输出和错误输出
Linux标准输入.输出和错误和文件重定向 专题 https://www.cnblogs.com/softidea/p/3965093.html 感觉自己对 这一块的理解一直不好 昨天同事给了一个 b ...
- PL/SQL编程--变量声明及赋值
declare v_price ,);--单价 v_usenum number;--水费字数 v_usenum2 number;--使用吨数 begin v_price:=2.45;--每吨单价 v_ ...
- Linux 文件及目录管理命令基础
pwd 显示当前所在目录 cd 切换目录 cd 命令语法 cd [选项] 目录 cd 的常用选项: cd ~ /cd 切换到当前用户的加目录 cd . 保持当前目录不变 cd .. 切换到上级目录 ...
- python爬虫之git的使用(windows下pycharm使用)
相信很多同学学会了git或者github以后都不知道怎么跟windows上的pycharm连在一起工作,那么下面我们开始介绍简单的安装和使用方法. 一.安装 1.首先你的有一个github的账户.注册 ...