
【半监督学习】MixMatch、UDA、ReMixMatch、FixMatch
半监督学习(Semi-Supervised Learning,SSL)的 SOTA 一次次被 Google 刷新,从 MixMatch 开始,到同期的 UDA、ReMixMatch,再到 2020 年的 FixMatch。
这四篇深度半监督学习方面的工作,都是从 consistency regularization 和 entropy minimization 两方面入手:
- consistency regularization:一致性,给输入图片或者中间层注入 noise,模型的输出应该尽可能保持不变或者近似。
- entropy minimization:最小化熵,模型在 unlabeled data 上的熵应该尽可能最小化。Pseudo label 也隐含地用到了 entropy minimization。
Consistency Regularization
对于每一个 unlabeled instance,consistency regularization 要求两次随机注入 noise 的输出近似。背后的思想是,如果一个模型是鲁棒的,那么即使输入有扰动,输出也应该近似。
对于 consistency regularization 来说,如何注入 noise 以及如何计算近似,就是每个方法的不同之处。注入 noise 可以通过模型本身的随机性(如 dropout)或者直接加入噪声(如 Gaussian noise),也可以通过 data augmentation;计算一致性的方法,可以使用 L2,也可以使用 KL divergency、cross entropy。
Entropy Minimization
MixMatch、UDA 和 ReMixMatch 通过 temperature sharpening 来间接利用 entropy minimization,而 FixMatch 通过 Pseudo label 来间接利用 entropy minimization。可以认为,只要通过得到 unlabeled data 的人工标签然后按照监督学习的方法(如 cross entropy loss)来训练的,都间接用到了 entropy minimization。因为人工标签都是 one-hot 或者近似 one-hot 的,如果 unlabeled data 的 prediction 近似人工标签,那么此时无标签数据的熵肯定也是较小的。
为什么这里使用人工标签而不是伪标签的称呼?一般而言,在半监督中,伪标签(pseudo label)特指 hard label,即 one-hot 类型的或者通过 argmax 得到的。[4]
Entropy minimization 可以在计算 unlabeled data 部分的 loss 和 consistency regularization 一起实现。
temperature sharpening 和 pseudo label 都得到了 unlabeled data 的人工标签,当前者 temperature=0 时,两者相等。pseudo label 要比 temperature sharpening 要简单,因为少了一个 temperature 超参数。
如果不利用 entropy minimization,那么 temperature sharpening 和 pseudo label 其实都是不需要的,只需要两次随机注入 noise 的 unlabeled instance 输出近似,就可以保证 consistency regularization。
或者说,得到 unlabeled data 的人工标签,可以使得 entropy minimization 和 consistency regularization 通过一项 loss 来完成。
结合 Consistency Regularization 和 Entropy Minimization
一般来说,半监督学习中的 unlabeled data 会使用全部训练数据集,即有标签的样本也会作为无标签样本来使用。
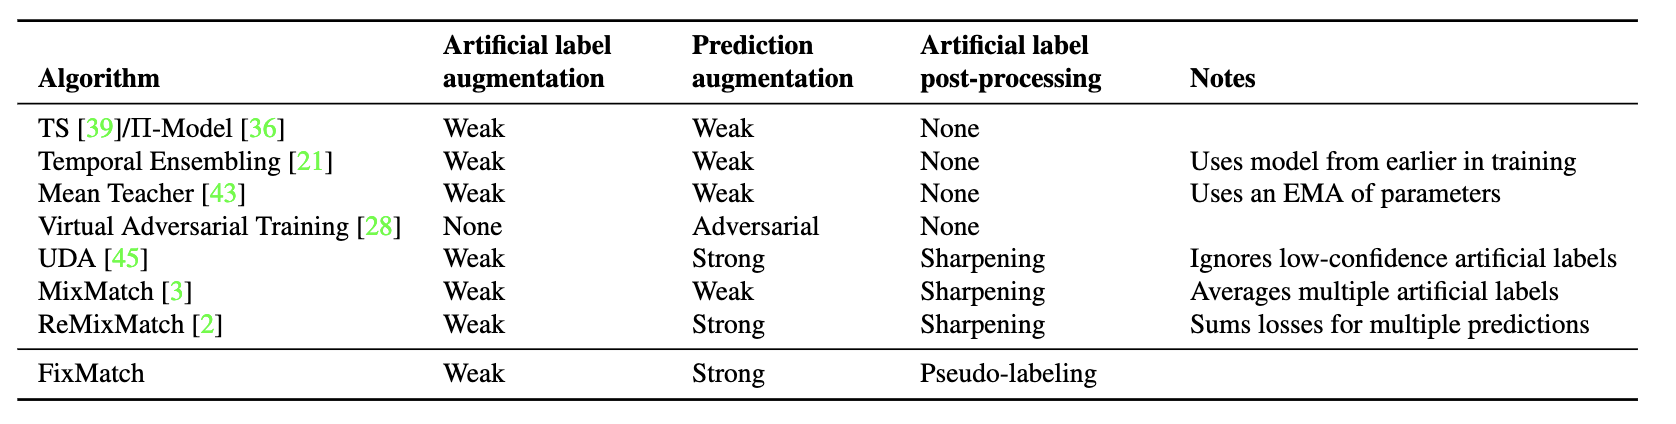
半监督学习中,labeled data 的标签都是给定的,而 unlabeled data 的标签都是不知道的。那么如何获得 unlabeled data 的人工标签(artificial label),MixMatch、UDA、ReMixMatch 和 FixMatch 的做法或多或少都不相同:
- MixMatch:平均 K 次 weak augmentation(如 shifting 和 flipping)的 predictions ,然后经过 temperature sharpening;
- UDA:一次 weak augmentation 的 prediction,然后经过 temperature sharpening;
- ReMixMatch:一次 weak augmentation 的 prediction,然后经过 distribution alignment,最后经过 temperature sharpening;
- FixMatch:一次 weak augmentation 的 prediction,然后 one-hot 得到 hard label。
得到了人工标签,我们就可以按照监督学习的方式来训练,这种思考方式就利用了 entropy minimization。而从 unlabeled data 的 consistency regularization 角度思考,我们需要注入不同的 noise,使得 unlabeled data 的 predictions 和它们的人工标签一致。
MixMatch、UDA、ReMixMatch 和 FixMatch 都利用 data augmentation 改变输入样本来注入 noise,不同的是 data augmentation 的具体方式和强度:
- MixMatch:一次 weak augmentation 得到 prediction,这就和正常的监督训练一样,只是 unlabeled loss 用的是 L2 而已;
- UDA:一次 strong augmentation(RandAugment) 得到 prediction;
- ReMixMatch:多次 strong augmentation(CTAugment)得到 predictions,然后同时参与 unlabeled loss 的计算,即一个 unlabeled instance 一个 step 多次增强后计算多次 loss;
- FixMatch:一次 strong augmentation(RandAugment 或 CTAugment)得到 prediction。
从 UDA 和 ReMixMatch 开始,strong augmentation 引入了半监督训练。UDA 使用了作者之前提出的 RandAugment 的 strong augmentation 方式,而 ReMixMatch 提出了一种 CTAugment。FixMatch 就把 UDA 和 ReMixMatch 中用到的 strong augmentation 都拿来用了一遍。
对于 unlabeled data 部分的 loss:
- MixMatch:L2 loss;
- UDA:KL divergency;
- ReMixMatch:cross entropy(包括自监督的 rotation loss 和没有使用 mixup 的 pre-mixup unlabeled loss);
- FixMatch:带阈值的 cross entropy。
FixMatch: Simplifying SSL with Consistency and Confidence
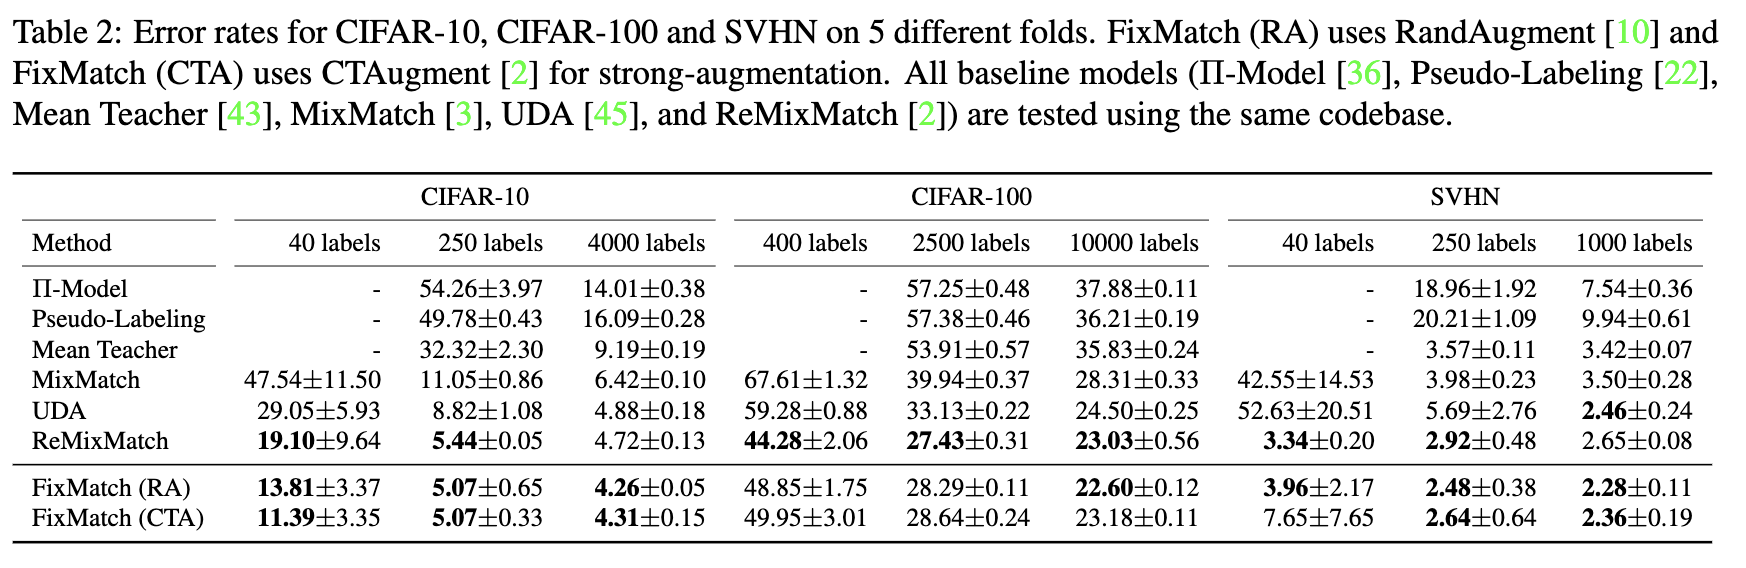
FixMatch 简化了 MixMatch、UDA 和 ReMixMatch,然后获得了更好的效果:
- 首先,temperature sharpening 换成 pseudo label,这是一个简化;
- 其次,FixMatch 通过设定一个阈值,在计算 unlabeled loss 时,对 prediction 的 confidence 超过阈值的 unlabeled instance 才算入 unlabeled loss,这样使得 unlabeled loss 的权重可以固定,这是第二个简化。
References
[1] Berthelot, D., Carlini, N., Goodfellow, I., Papernot, N., Oliver, A., Raffel, C. (2019). MixMatch: A Holistic Approach to Semi-Supervised Learning arXiv https://arxiv.org/abs/1905.02249
[2] Berthelot, D., Carlini, N., Cubuk, E., Kurakin, A., Sohn, K., Zhang, H., Raffel, C. (2019). ReMixMatch: Semi-Supervised Learning with Distribution Alignment and Augmentation Anchoring arXiv https://arxiv.org/abs/1911.09785
[3] Xie, Q., Dai, Z., Hovy, E., Luong, M., Le, Q. (2019). Unsupervised Data Augmentation for Consistency Training arXiv https://arxiv.org/abs/1904.12848
[4] Sohn, K., Berthelot, D., Li, C., Zhang, Z., Carlini, N., Cubuk, E., Kurakin, A., Zhang, H., Raffel, C. (2020). FixMatch: Simplifying Semi-Supervised Learning with Consistency and Confidence arXiv https://arxiv.org/abs/2001.07685
【半监督学习】MixMatch、UDA、ReMixMatch、FixMatch的更多相关文章
- 利用DP-SSL对少量的标记样本进行有效的半监督学习
作者 | Doreen 01 介绍 深度学习之所以能在图像分类.自然语言处理等方面取得巨大成功的原因在于大量的训练数据得到了高质量的标注. 然而在一些极其复杂的场景(例如:无人驾驶)中会产生海量的数据 ...
- 基于PU-Learning的恶意URL检测——半监督学习的思路来进行正例和无标记样本学习
PU learning问题描述 给定一个正例文档集合P和一个无标注文档集U(混合文档集),在无标注文档集中同时含有正例文档和反例文档.通过使用P和U建立一个分类器能够辨别U或测试集中的正例文档 [即想 ...
- sklearn半监督学习
标签: 半监督学习 作者:炼己者 欢迎大家访问 我的简书 以及 我的博客 本博客所有内容以学习.研究和分享为主,如需转载,请联系本人,标明作者和出处,并且是非商业用途,谢谢! --- 摘要:半监督学习 ...
- python大战机器学习——半监督学习
半监督学习:综合利用有类标的数据和没有类标的数据,来生成合适的分类函数.它是一类可以自动地利用未标记的数据来提升学习性能的算法 1.生成式半监督学习 优点:方法简单,容易实现.通常在有标记数据极少时, ...
- 吴裕雄 python 机器学习——半监督学习LabelSpreading模型
import numpy as np import matplotlib.pyplot as plt from sklearn import metrics from sklearn import d ...
- 吴裕雄 python 机器学习——半监督学习标准迭代式标记传播算法LabelPropagation模型
import numpy as np import matplotlib.pyplot as plt from sklearn import metrics from sklearn import d ...
- 虚拟对抗训练(VAT):一种用于监督学习和半监督学习的正则化方法
正则化 虚拟对抗训练是一种正则化方法,正则化在深度学习中是防止过拟合的一种方法.通常训练样本是有限的,而对于深度学习来说,搭设的深度网络是可以最大限度地拟合训练样本的分布的,从而导致模型与训练样本分布 ...
- 【论文解读】【半监督学习】【Google教你水论文】A Simple Semi-Supervised Learning Framework for Object Detection
题记:最近在做LLL(Life Long Learning),接触到了SSL(Semi-Supervised Learning)正好读到了谷歌今年的论文,也是比较有点开创性的,浅显易懂,对比实验丰富, ...
- AI之强化学习、无监督学习、半监督学习和对抗学习
1.强化学习 @ 目录 1.强化学习 1.1 强化学习原理 1.2 强化学习与监督学习 2.无监督学习 3.半监督学习 4.对抗学习 强化学习(英语:Reinforcement Learning,简称 ...
随机推荐
- 详解聚类算法Kmeans的两大优化——mini-batch和Kmeans++
本文始发于个人公众号:TechFlow,原创不易,求个关注 今天是机器学习专题的第13篇文章,我们来看下Kmeans算法的优化. 在上一篇文章当中我们一起学习了Kmeans这个聚类算法,在算法的最后我 ...
- Android 缓存的使用
缓存基础类 import android.content.Context; import android.content.SharedPreferences; public class CachePa ...
- IE浏览器下载文件中文文件名乱码问题解决
处理过程 根据IE的F12中的log提示,是因为http头信息中的编码替换了html文件中的编码.我最初的思路是设置Tomcat默认编码,但是我发现我已经在Server.xml中设置过,想到这里我想到 ...
- UVA129 Krypton Factor 困难的串 dfs回溯【DFS】
Krypton Factor Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others ...
- linux execl()函数 关于execl()函数族的用法不在赘述,
linux execl()函数 关于execl()函数族的用法不在赘述, linux 网络编程 1---(基本概念) 1.TCP和UDP协议 共同点:同为传输层协议 不同点: TCP:有连接,可靠 U ...
- Numpy和OpenCV中的图像几何变换
介绍 上面的图像使它不言而喻什么是几何变换.它是一种应用广泛的图像处理技术.例如,在计算机图形学中有一个简单的用例,用于在较小或较大的屏幕上显示图形内容时简单地重新缩放图形内容. 它也可以应用于扭曲一 ...
- Hbase 整合 Hadoop 的数据迁移
上篇文章说了 Hbase 的基础架构,都是比较理论的知识,最近我也一直在搞 Hbase 的数据迁移, 今天就来一篇实战型的,把最近一段时间的 Hbase 整合 Hadoop 的基础知识在梳理一遍,毕竟 ...
- java 初学者 第一阶段作业编程总结及心得体会
0.前言 第一阶段java作业分为3次. 第一次作业是简单得一些语法和一些简单得逻辑思维,主要内容有求三角形是什么三角形的,还有就是求坐标点所在范围的,也涉及到了数字和字母的转换,总之相相当于是给ja ...
- JS函数详解
什么是函数呢? 对于JS来说,我们可以把函数理解为任意一段代码放在一个盒子里,在我们想要让这段代码执行的时候,直接执行这个盒子里的代码就行.专业一点来讲:js函数就是由事件驱动的可执行课重复只用的代码 ...
- RecyclerView实现拖动排序和滑动删除功能
RecyclerView 的拖动排序需要借助一下 ItemTouchHelper 这个类,ItemTouchHelper 类是 Google 提供的一个支持 RecyclerView 滑动和拖动的一个 ...