
Scrapy模拟登录GitHub
d:
进入D盘
scrapy startproject GitHub
创建项目
scrapy genspider github github.com
创建爬虫
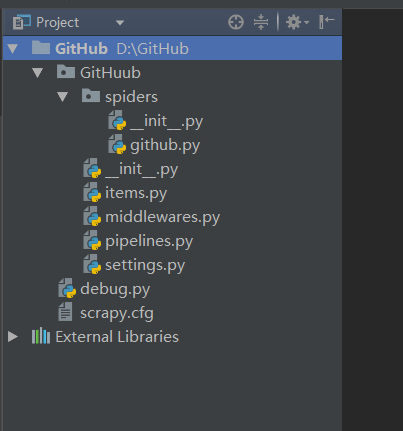
编辑github.py:
# -*- coding: utf-8 -*-
import scrapy
from scrapy import Request, FormRequest

class GithubSpider(scrapy.Spider):
    name = 'github'
    allowed_domains = ['github.com']

    headers = {
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
        'Accept-Encoding': 'gzip, deflate, br',
        'Accept-Language': 'zh-CN,zh;q=0.8,en-US;q=0.5,en;q=0.3',
        'Connection': 'keep-alive',
        'Referer': 'https://github.com/',
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:52.0) Gecko/20100101 Firefox/52.0',
        'Content-Type': 'application/x-www-form-urlencoded'
    }
    # 请求头

    def start_requests(self):
        # 重写start_requests方法
        urls = ['https://github.com/login']
        for url in urls:
            yield Request(url, meta={'cookiejar': 1}, callback=self.github_login)
            # 通过meta传入cookiejar特殊key,爬取url作为参数传给回调函数
            # meta:字典格式的元数据
            # cookiejar:是meta的一个特殊的key,通过cookiejar参数可以支持多个会话对某网站进行爬取
            # 可以对cookie做标记1, 2, 3, 4......这样scrapy就维持了多个会话

    def github_login(self, response):
        authenticity_token = response.xpath(".//*[@id='login']/form/input[2]/@value").extract_first()
        # 首先从源码中获取到authenticity_token的值
        return FormRequest.from_response(
            response,
            url='https://github.com/session',
            meta={'cookiejar': response.meta['cookiejar']},
            headers=self.headers,
            formdata={
                'authenticity_token': authenticity_token,
                'commit': 'Sign in',
                'login': '123456789@qq.com',
                'password': 'abcdef@123456',
                'utf8': '✓'
            },
            callback=self.github_after,
            dont_click=True
            # dont_click如果是True,表单数据将被提交,而不需要单击任何元素
        )

    def github_after(self, response):
        home_page = response.xpath(".//*[@id='dashboard']/div[2]/div[1]/nav/a[1]/text()").extract()
        # 获取登录成功后页面中的文本“Browse activity”

        if 'Browse activity' in home_page:
            self.logger.info('登录成功!')
            # 如果含有“Browse activity”,则打印登录成功
        else:
            self.logger.error('登录失败!')
新建debug.py调试脚本:
# -*- coding: utf-8 -*-
from scrapy import cmdline

cmdline.execute('scrapy crawl github'.split())
修改settings.py配置文件:
第23行修改为:
# Obey robots.txt rules
ROBOTSTXT_OBEY = False
# 遵循Robots协议
Scrapy模拟登录GitHub的更多相关文章
- Scrapy模拟登录信息
携带cookie模拟登录 需要在爬虫里面自定义一个start_requests()的函数 里面的内容: def start_requests(self): cookies = '真实有效的cookie ...
- scrapy模拟登录微博
http://blog.csdn.net/pipisorry/article/details/47008981 这篇文章是介绍使用scrapy模拟登录微博,并爬取微博相关内容.关于登录流程为嘛如此设置 ...
- 笔记-爬虫-模拟登录github
笔记-模拟登录github 1. 模拟登录github 1.1. 环境准备 安装/升级requests 2.20.0 pip install --upgrade requests pi ...
- scrapy 基础组件专题(十二):scrapy 模拟登录
1. scrapy有三种方法模拟登陆 1.1直接携带cookies 1.2找url地址,发送post请求存储cookie 1.3找到对应的form表单,自动解析input标签,自动解析post请求的u ...
- 利用scrapy模拟登录知乎
闲来无事,写一个模拟登录知乎的小demo. 分析网页发现:登录需要的手机号,密码,_xsrf参数,验证码 实现思路: 1.获取验证码 2.获取_xsrf 参数 3.携带参数,请求登录 验证码url : ...
- python学习,使用requests库来模拟登录github,post请求。
这次我们要模拟登录的页面是 https://github.com/login 首先我们先尝试着登陆一遍分析一下请求, 打开开发者工具下的network选项, 可以很清楚的看到这个会话session,而 ...
- Scrapy模拟登录赶集网
1.打开赶集网登录界面,先模拟登录并抓包,获得post请求的request参数 2. 我们只需构造出上面的参数传入formdata即可 参数分析: setcookie:为自动登录所传的值,不勾选时默认 ...
- scrapy模拟登录
对于scrapy来说,也是有两个方法模拟登陆: 直接携带cookie 找到发送post请求的url地址,带上信息,发送请求 scrapy模拟登陆之携带cookie 应用场景: cookie过期时间很长 ...
- python爬虫之scrapy模拟登录
背景: 初来乍到的pythoner,刚开始的时候觉得所有的网站无非就是分析HTML.json数据,但是忽略了很多的一个问题,有很多的网站为了反爬虫,除了需要高可用代理IP地址池外,还需要登录.例如知乎 ...
随机推荐
- javascript-对象搜索算法挑战
对象搜索算法挑战 function where(collection, source) { var arr = []; var status = null; // What's in a name? ...
- HDU 1102(Constructing Roads)(最小生成树之prim算法)
题目链接: http://acm.hdu.edu.cn/showproblem.php?pid=1102 Constructing Roads Time Limit: 2000/1000 MS (Ja ...
- LUA IO库
I/O库为文件操作提供两种模式. 简单模式(simple model)拥有一个当前输入文件和一个当前输出文件.而且提供针对这些文件相关的操作.全然模式(complete model)使用外部的文件句柄 ...
- Notes 20180507 : Java程序设计之环境搭建与HelloWord
3 HelloWorld 不管从事什么工作那么一个工作环境总是必不可少的,那怕你只是要写篇文章,一张平坦的书桌和流利的书写笔总是能帮助我们完成工作的,Java开发更是如此.在开始今天的HelloWor ...
- oAuth2.0认证流程图
这两天在看oAuth2.0的东西,简单的使用visio画了个流程图.演示的是用户登录慕课网,使用qq登录的流程:
- weblogic.xml中的虚拟目录的配置
项目中的Ueditor富文本编辑器中上传图片后要能够预览. 如下图: 实现: 配置weblogic的虚拟目录:项目名称是test 如图: 这个表示:所有的访问/uefile/*的路径都会被转发到服务器 ...
- 获取当前目录下所有php文件内的函数名
$dir = dirname(__FILE__); $files = scandir($dir); foreach($files as $name){ if($name == '.' || $name ...
- [转]windows下多个python版本共存,pip使用
windows下多个python版本共存,pip使用 2017年09月13日 17:21:30 阅读数:2574 一.同时装了Python3和Python2,怎么区分 了解python的人都知道pyt ...
- PHP操作redis之String(字符串)、List(列表)(一)
Redis 简介 Redis 是完全开源免费的,遵守BSD协议,是一个高性能的key-value数据库. Redis 与其他 key – value 缓存产品有以下三个特点: Redis支持数据的持久 ...
- 运行Delphi XE10的MongoDB例程,测试Delphi插入记录性能
Delphi XE10支持MongoDB的数据库,提供了个例子restaurants可批量导入数据. 本文对比Delphi例子与MongoDB自带的mongoimport导入批量数据的性能. 步骤: ...