
【python3】爬取新浪的栏目分类
目标地址: http://www.sina.com.cn/
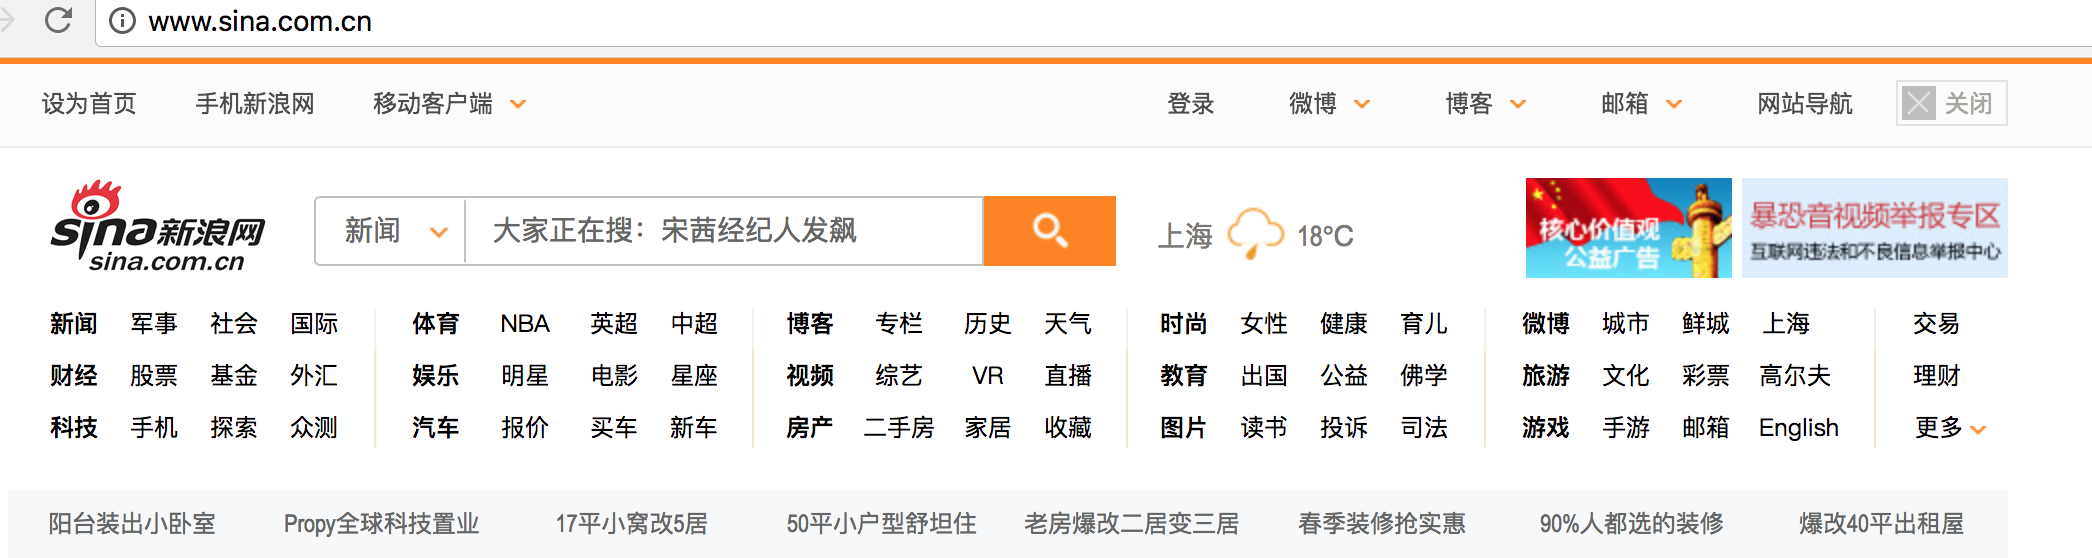
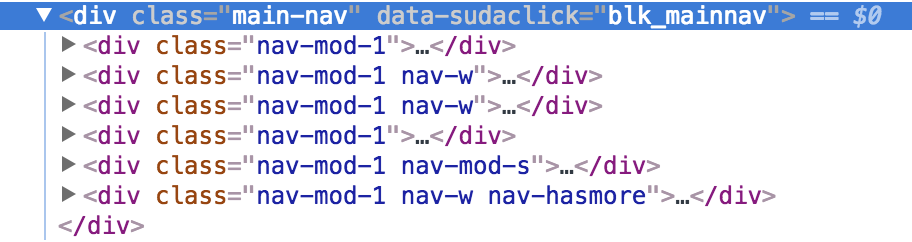
查看源代码,分析:
1 整个分类 在 div main-nav 里边包含
2 分组情况:1,4一组 、 2,3一组 、 5 一组 、6一组
实现源码:
# coding=utf-8

import urllib.request

import ssl

from lxml import etree

# 获取html内容

def getHtml(url):

    page = urllib.request.urlopen(url)

    html = page.read()

    html = html.decode('utf-8')

    return html

# 获取内容

def get_title(arr, html, pathrole, sumtimes):

    selector = etree.HTML(html)

    content = selector.xpath(pathrole)

    i = 0

    while i <= sumtimes:

        result = content[i].xpath('string(.)').strip()

        arr.append(result)

        i += 1

    return arr

# 创建ssl证书

ssl._create_default_https_context = ssl._create_unverified_context

url = "http://www.sina.com.cn/"

html = getHtml(url)

# 第一次获取

arr = []

pathrole1 = '//div[@class="main-nav"]/div[@class="nav-mod-1 nav-w"]/ul/li'

retult1 = get_title(arr, html, pathrole=pathrole1, sumtimes=23)

# 第二次获取

if retult1:

    pathrole2 = '//div[@class="main-nav"]/div[@class="nav-mod-1"]/ul/li'

    retult2 = get_title(retult1, html, pathrole=pathrole2, sumtimes=23)

else:

    print("error")

# 第三次获取

if retult2:

    pathrole3 = '//div[@class="main-nav"]/div[@class="nav-mod-1 nav-mod-s"]/ul/li'

    retult3 = get_title(retult2, html, pathrole3, sumtimes=11)

else:

    print("error")

# 第四次获取

if retult3:

    pathrole4 = '//div[@class="main-nav"]/div[@class="nav-mod-1 nav-w nav-hasmore"]/ul/li'

    retult4 = get_title(retult3, html, pathrole4, sumtimes=1)

else:

    print("error")

# 第五次获取:更多列表

if retult4:

    pathrole5 = '//div[@class="main-nav"]/div[@class="nav-mod-1 nav-w nav-hasmore"]/ul/li/ul[@class="more-list"]/li'

    retult5 = get_title(retult4, html, pathrole5, sumtimes=6)

    print(retult5)

else:

    print("error")
以上代码,还可以继续优化,比如 xpath 的模糊匹配。可以把前四组合为一个,继续学习!
【python3】爬取新浪的栏目分类的更多相关文章
- Python3:爬取新浪、网易、今日头条、UC四大网站新闻标题及内容
Python3:爬取新浪.网易.今日头条.UC四大网站新闻标题及内容 以爬取相应网站的社会新闻内容为例: 一.新浪: 新浪网的新闻比较好爬取,我是用BeautifulSoup直接解析的,它并没有使用J ...
- selenium+BeautifulSoup+phantomjs爬取新浪新闻
一 下载phantomjs,把phantomjs.exe的文件路径加到环境变量中,也可以phantomjs.exe拷贝到一个已存在的环境变量路径中,比如我用的anaconda,我把phantomjs. ...
- python3 爬取boss直聘职业分类数据(未完成)
import reimport urllib.request # 爬取boss直聘职业分类数据def subRule(fileName): result = re.findall(r'<p cl ...
- python3爬虫-爬取新浪新闻首页所有新闻标题
准备工作:安装requests和BeautifulSoup4.打开cmd,输入如下命令 pip install requests pip install BeautifulSoup4 打开我们要爬取的 ...
- python3使用requests爬取新浪热门微博
微博登录的实现代码来源:https://gist.github.com/mrluanma/3621775 相关环境 使用的python3.4,发现配置好环境后可以直接使用pip easy_instal ...
- Python 爬虫实例(7)—— 爬取 新浪军事新闻
我们打开新浪新闻,看到页面如下,首先去爬取一级 url,图片中蓝色圆圈部分 第二zh张图片,显示需要分页, 源代码: # coding:utf-8 import json import redis i ...
- python2.7 爬虫初体验爬取新浪国内新闻_20161130
python2.7 爬虫初学习 模块:BeautifulSoup requests 1.获取新浪国内新闻标题 2.获取新闻url 3.还没想好,想法是把第2步的url 获取到下载网页源代码 再去分析源 ...
- python爬取新浪股票数据—绘图【原创分享】
目标:不做蜡烛图,只用折线图绘图,绘出四条线之间的关系. 注:未使用接口,仅爬虫学习,不做任何违法操作. """ 新浪财经,爬取历史股票数据 ""&q ...
- xpath爬取新浪天气
参考资料: http://cuiqingcai.com/1052.html http://cuiqingcai.com/2621.html http://www.cnblogs.com/jixin/p ...
随机推荐
- LeetCode224——Basic Calculator
Implement a basic calculator to evaluate a simple expression string. The expression string may conta ...
- R语言绘制花瓣图flower plot
R语言中有很多现成的R包,可以绘制venn图,但是最多支持5组,当组别数大于5时,venn图即使能够画出来,看上去也非常复杂,不够直观: 在实际的数据分析中,组别大于5的情况还是经常遇到的,这是就可以 ...
- C# 判断一个字符串是否为url
/// <summary> /// 判断一个字符串是否为url /// </summary> /// <param name="str">< ...
- 9款极具创意的HTML5/CSS3进度条动画
今天我们要分享9款极具创意的HTML5/CSS3进度条动画,这些进度条也许可以帮你增强用户交互和提高用户体验,喜欢的朋友就收藏了吧. 1.HTML5/CSS3图片加载进度条 可切换多主题 今天要分享的 ...
- tf.variable_scope
转载:https://blog.csdn.net/gaoyueace/article/details/79079068 例如: #在名字为ae的命名空间内创建变量 with tf.variable_s ...
- [Learn AF3]第四章 App framework组件之Button
Button 组件名称:Button 是否js控件:否 使用说明:如果说panel组件是af3的“核心(heart of the ui)”,那么Button就是af中的五虎上将之 ...
- CentOS 65 安装vmware tools 杂记
CentOS 65中安装vmware tools时出现如下错误, centos vmware tools install failure ,no default label for /tmp/vmwa ...
- mysql 类型
1.bigint 范围(-2^63 (-9223372036854775808) 到 2^63-1 (9223372036854775807) ) 字节大小(8个字节) 2.int 范围(-2^31 ...
- koa2使用阿里云oss的nodejs sdk实现上传图片
nodejs实现上传图片到阿里云,自然是写成接口形式比较方便,前端监听input file的改变,把file对象传入到formData中传入后端,不能直接传入file对象,后端需要接受formData ...
- webpack学习简单总结
webpack使用总结: 入门使用: 这个报错说明需要安装相应的Loader,并在引用时指定相应的loader 执行成功如图: chunk指相应的区块. 要是css引入正确:必须引入css-loade ...