
Python 爬虫实例(7)—— 爬取 新浪军事新闻
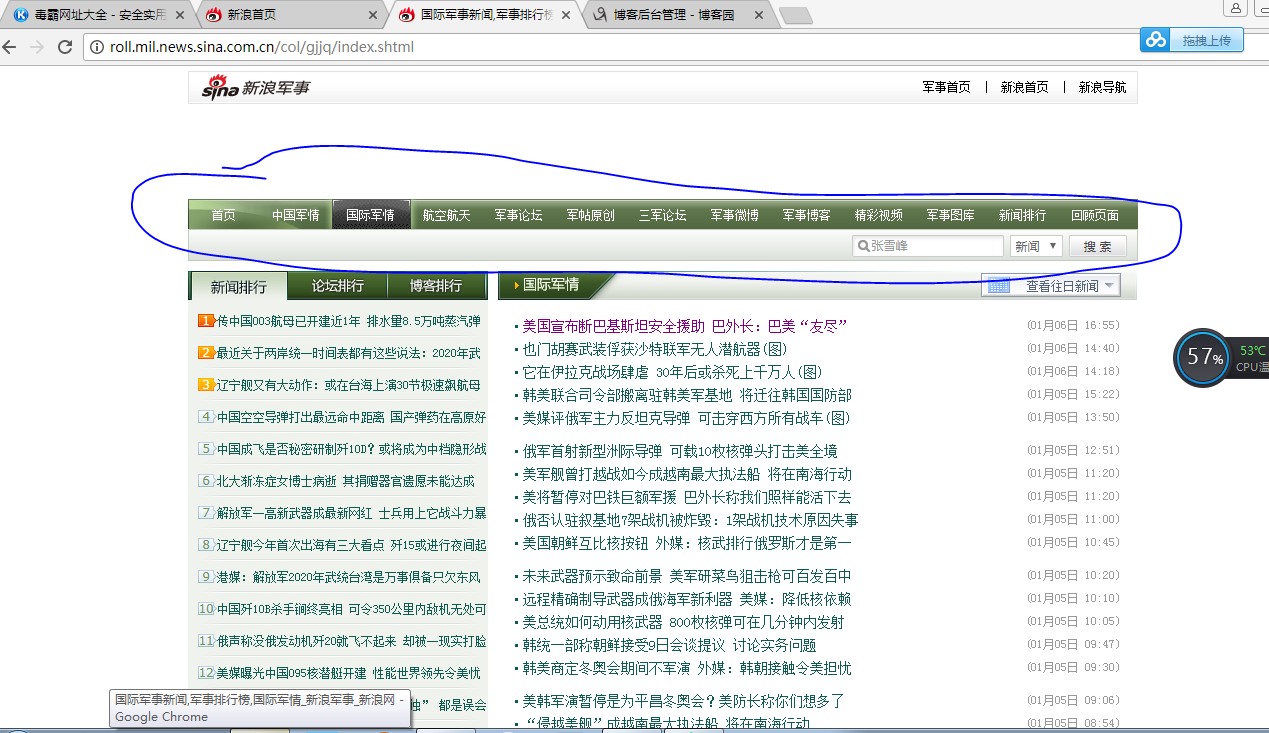
我们打开新浪新闻,看到页面如下,首先去爬取一级 url,图片中蓝色圆圈部分
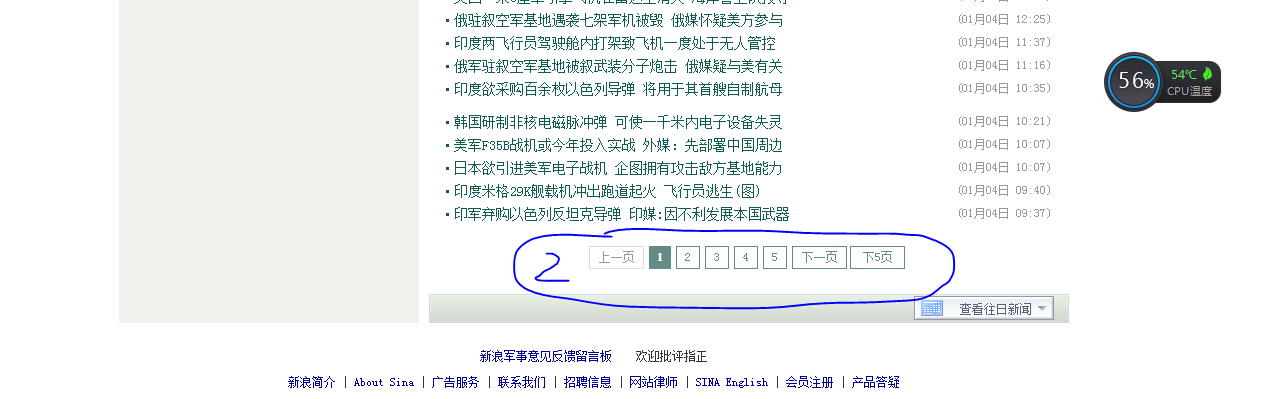
第二zh张图片,显示需要分页,
源代码:
# coding:utf-8

import json

import redis

import time

import requests

session = requests.session()

import logging.handlers

import pickle

import sys

import re

import datetime

from bs4 import BeautifulSoup

import sys

reload(sys)

sys.setdefaultencoding('utf8')

import datetime

# 生成一年的日期

def dateRange(start, end, step=1, format="%Y-%m-%d"):

    strptime, strftime = datetime.datetime.strptime, datetime.datetime.strftime

    days = (strptime(end, format) - strptime(start, format)).days

    return [strftime(strptime(start, format) + datetime.timedelta(i), format) for i in xrange(0, days, step)]

def spider():

    date_list = dateRange("2017-01-01", "2018-01-06")[::-1]

    print date_list

    for date in date_list:

        for page in range(1,5):

            #组合url

            url = "http://roll.mil.news.sina.com.cn/col/zgjq/" + str(date)+"_"+ str(page) +".shtml"

            # 伪装请求头

            headers = {

                "Host":"roll.mil.news.sina.com.cn",

                "Cache-Control":"max-age=0",

                "Upgrade-Insecure-Requests":"",

                "User-Agent":"Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.113 Safari/537.36",

                "Accept":"text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",

                "Accept-Encoding":"gzip, deflate",

                "Accept-Language":"zh-CN,zh;q=0.8",

                "If-Modified-Since":"Sat, 06 Jan 2018 09:57:24 GMT",

            }

            result = session.get(url=url,headers=headers).content

            #编码格式是 gb2312,使用BeautifulSoup解决编码格式

            soup = BeautifulSoup(result,'html.parser')

            #找到新闻列表

            result_div = soup.find_all('div',attrs={"class":"fixList"})[0]

            #去下换行

            result_replace = str(result_div).replace('\n','').replace('\r','').replace('\t','')

            #正则匹配信息

            result_list = re.findall('<li>(.*?)</li>',result_replace)

            for i in result_list:

                #匹配出来新闻 url, name,time

                news_url = re.findall('<a href="(.*?)" target=',i)[0]

                news_name = re.findall('target="_blank">(.*?)</a>',i)[0]

                news_time = re.findall('<span class="time">\((.*?)\)</span>',i)[0]

                print news_url

                print news_name

                print news_time

spider()
Python 爬虫实例(7)—— 爬取 新浪军事新闻的更多相关文章
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- python2.7 爬虫初体验爬取新浪国内新闻_20161130
python2.7 爬虫初学习 模块:BeautifulSoup requests 1.获取新浪国内新闻标题 2.获取新闻url 3.还没想好,想法是把第2步的url 获取到下载网页源代码 再去分析源 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- [python爬虫] Selenium定向爬取虎扑篮球海量精美图片
前言: 作为一名从小就看篮球的球迷,会经常逛虎扑篮球及湿乎乎等论坛,在论坛里面会存在很多精美图片,包括NBA球队.CBA明星.花边新闻.球鞋美女等等,如果一张张右键另存为的话真是手都点疼了.作为程序员 ...
- Python3:爬取新浪、网易、今日头条、UC四大网站新闻标题及内容
Python3:爬取新浪.网易.今日头条.UC四大网站新闻标题及内容 以爬取相应网站的社会新闻内容为例: 一.新浪: 新浪网的新闻比较好爬取,我是用BeautifulSoup直接解析的,它并没有使用J ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- selenium+BeautifulSoup+phantomjs爬取新浪新闻
一 下载phantomjs,把phantomjs.exe的文件路径加到环境变量中,也可以phantomjs.exe拷贝到一个已存在的环境变量路径中,比如我用的anaconda,我把phantomjs. ...
随机推荐
- P3353 在你窗外闪耀的星星
飞逝的的时光不会模糊我对你的记忆.难以相信从我第一次见到你以来已经过去了3年.我仍然还生动地记得,3年前,在美丽的集美中学,从我看到你微笑着走出教室,你将头向后仰,柔和的晚霞照耀着你玫瑰色的脸颊.我明 ...
- Linux系统开发之路-中
4.Linux的安装(Windows环境下): 1)Windows环境需要借助虚拟机来安装Linux系统,这个推荐使用的软件是VMWare,官网能下载到的最新版本是Workstation Pro15. ...
- ROWNUM = 1 to replace count(*)
For a long time, I have been using the EXISTS clause to determine if at least one record exists in a ...
- Web Service 消息格式
当客户端和Web Service服务器进行通信时,他们交换消息.客户端发送请求消息到Web Service服务器. Web Service服务器响应并返回消息.这就像普通的HTTP,浏览器发送一个HT ...
- UVA 207 PGA Tour Prize Money
知识补充: ①:ssprintf: int sprintf(char *str, const char *format, ...) 发送格式化输出到 str 所指向的字符串. char str[80] ...
- python数据类型内置方法 字符串和列表
1.字符串 内置方法操作# a = 'qqssf'#1. print(a[-1:]) #按索引取,正向从0开始,反向从-1开始# print(len(a)) #取长度# a = 'qqssf'# 2. ...
- JS 单体内置对象
内置对象: 由ECMAScript提供的.不依赖于宿主环境的对象,这些对象在ECMAScript程序执行之前就已经存在了. 不必由开发人员显式地实例化内置对象 比如: Object Array Str ...
- mysql命令(command)
连接mysql命令: -uuserName -pPassword 显示表的索引: SHOW INDDEX FROM table_name 查看mysql的超时时间:SHOW GLOBAL VARIAB ...
- PHP中new self()和new static()的区别
1.new static()是在PHP5.3版本中引入的新特性. 2.无论是new static()还是new self(),都是new了一个新的对象. 3.这两个方法new出来的对象有什么区别呢,说 ...
- jQueryUI中Datepicker(日历)插件使用
atepicker插件的属性: 属性 数据类型 默认值 说明 altField string "" 使用备用的输出字段,即将选择的日期 以另一种格式,输出到另一个控件中, 值为选择 ...