
python3爬虫-爬取新浪新闻首页所有新闻标题
准备工作:安装requests和BeautifulSoup4。打开cmd,输入如下命令
pip install requests

pip install BeautifulSoup4打开我们要爬取的页面,这里以新浪新闻为例,地址为:http://news.sina.com.cn/china/
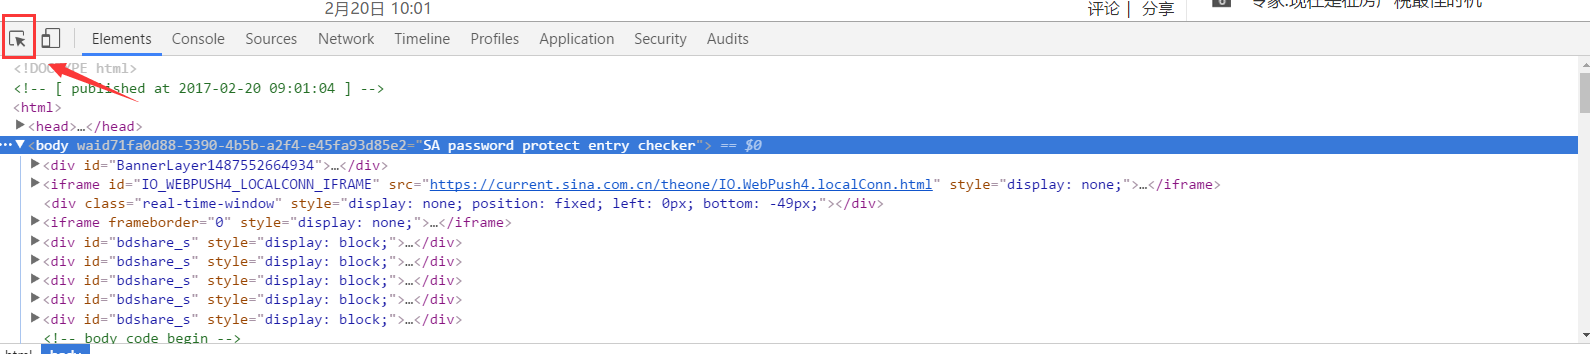
按F12打开开发人员工具,点击左上角的图片,然后再页面中点击你想查看的元素:
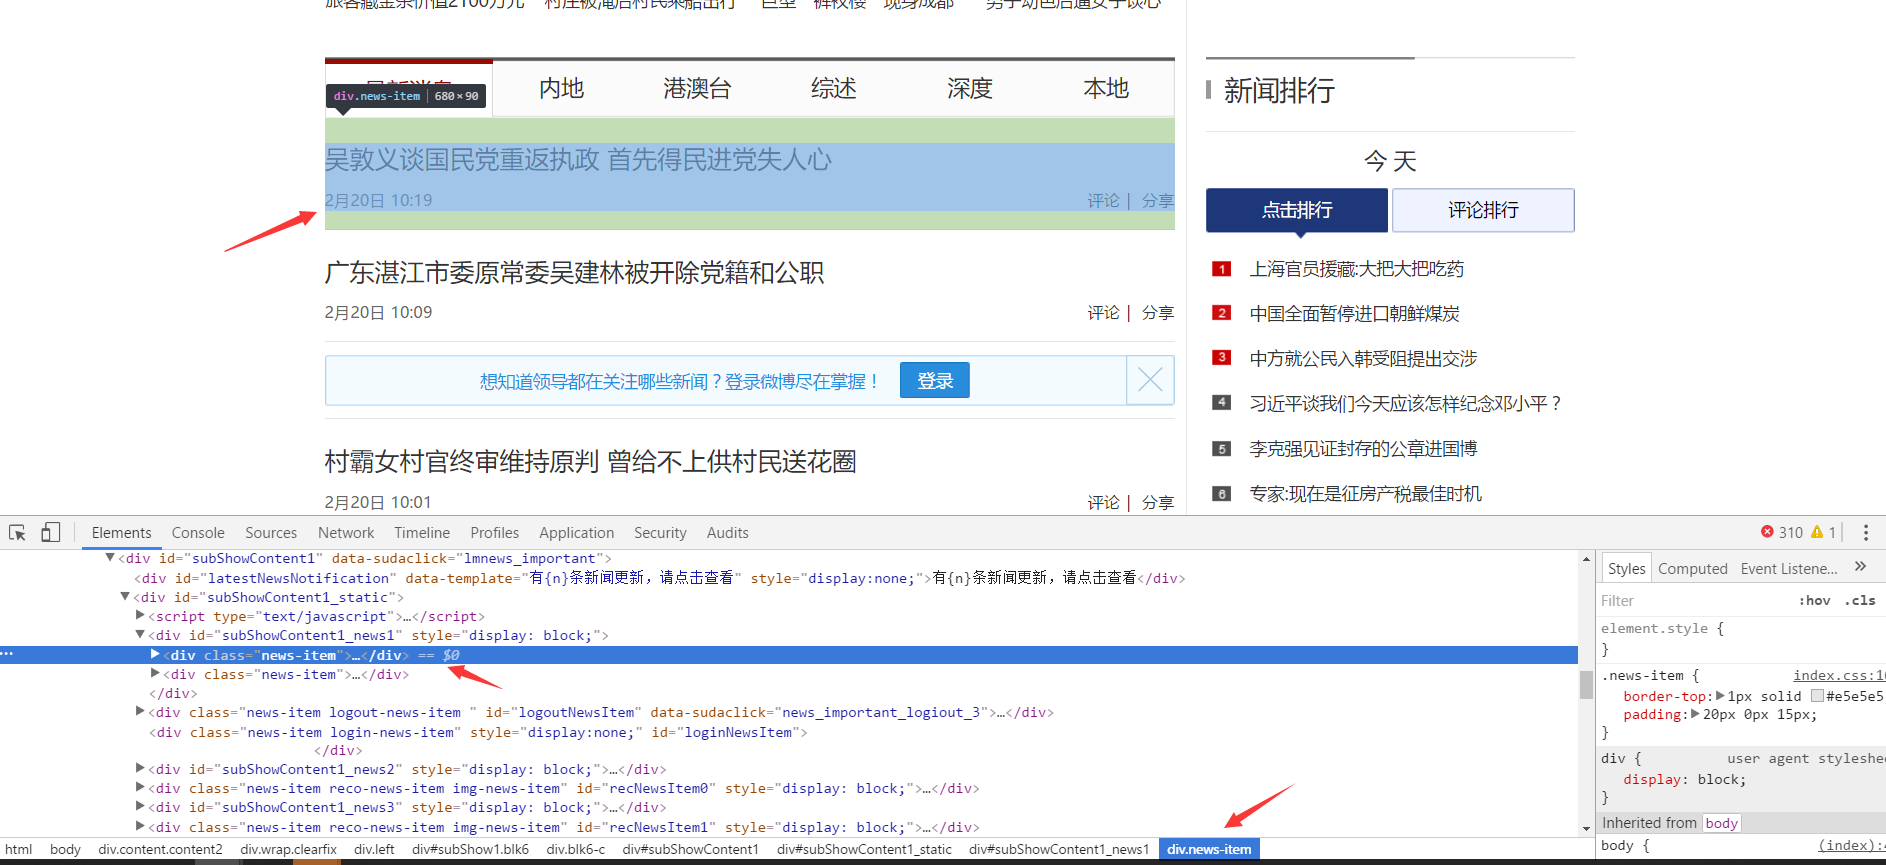
我点击了新闻标题处的元素,查看到该元素为class=news-item的元素:
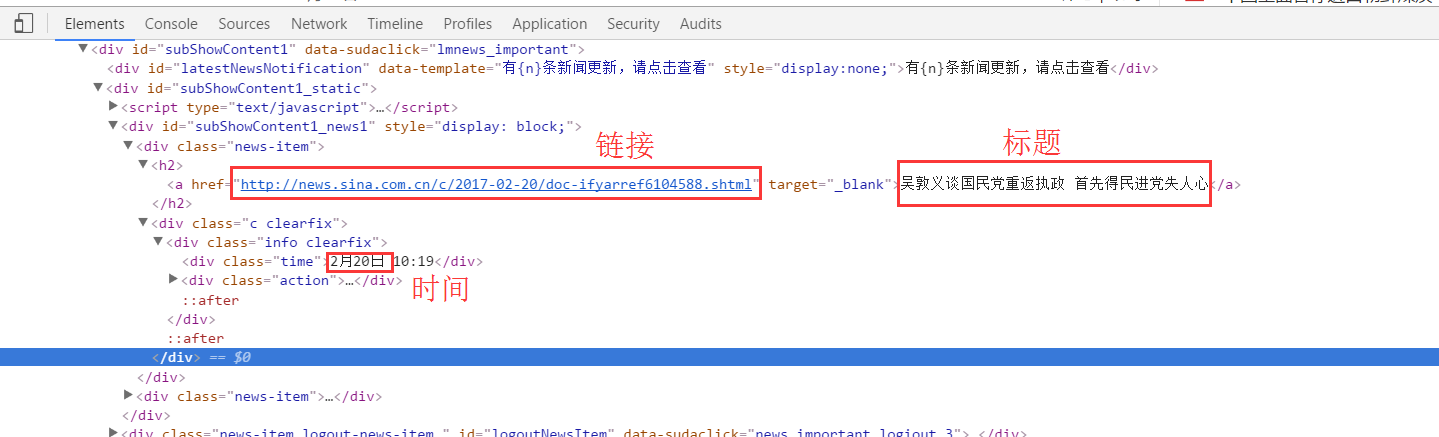
在这里,我们要获取新闻的时间,标题和链接,查看到分别在如下位置:
现在,就可以根据元素的结构编写爬虫代码了:
import requests

from bs4 import BeautifulSoup

url = 'http://news.sina.com.cn/china/'

res = requests.get(url)

# 使用UTF-8编码

res.encoding = 'UTF-8'

# 使用剖析器为html.parser

soup = BeautifulSoup(res.text, 'html.parser')

#遍历每一个class=news-item的节点

for news in soup.select('.news-item'):

    h2 = news.select('h2')

    #只选择长度大于0的结果

    if len(h2) > 0:

        #新闻时间

        time = news.select('.time')[0].text

        #新闻标题

        title = h2[0].text

        #新闻链接

        href = h2[0].select('a')[0]['href']

        #打印

        print(time, title, href)
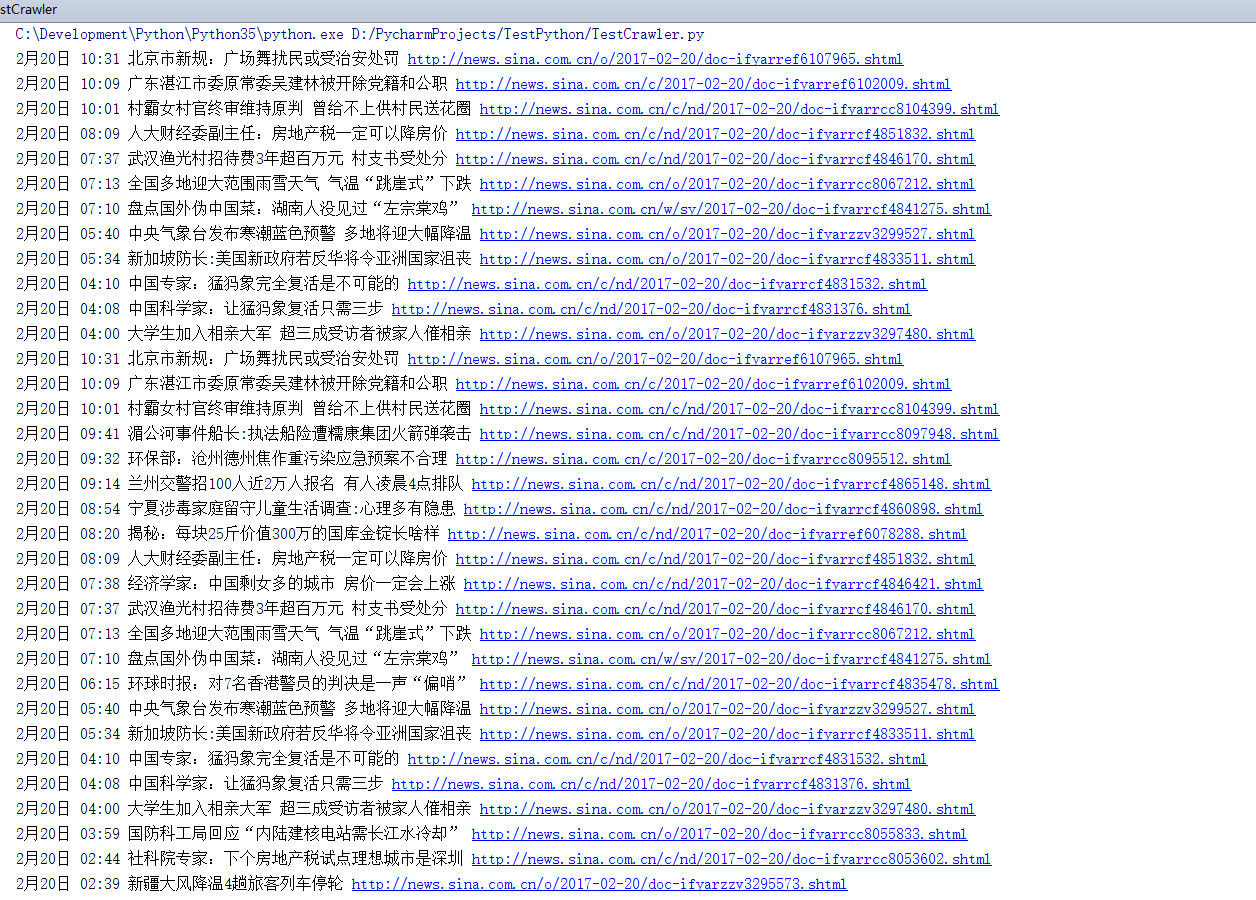
运行程序,结果如下图所示:
python3爬虫-爬取新浪新闻首页所有新闻标题的更多相关文章
- Python3:爬取新浪、网易、今日头条、UC四大网站新闻标题及内容
Python3:爬取新浪.网易.今日头条.UC四大网站新闻标题及内容 以爬取相应网站的社会新闻内容为例: 一.新浪: 新浪网的新闻比较好爬取,我是用BeautifulSoup直接解析的,它并没有使用J ...
- 【python3】爬取新浪的栏目分类
目标地址: http://www.sina.com.cn/ 查看源代码,分析: 1 整个分类 在 div main-nav 里边包含 2 分组情况:1,4一组 . 2,3一组 . 5 一组 .6一组 ...
- selenium+BeautifulSoup+phantomjs爬取新浪新闻
一 下载phantomjs,把phantomjs.exe的文件路径加到环境变量中,也可以phantomjs.exe拷贝到一个已存在的环境变量路径中,比如我用的anaconda,我把phantomjs. ...
- python3爬虫爬取网页思路及常见问题(原创)
学习爬虫有一段时间了,对遇到的一些问题进行一下总结. 爬虫流程可大致分为:请求网页(request),获取响应(response),解析(parse),保存(save). 下面分别说下这几个过程中可以 ...
- python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照 来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了. 使用python 爬取博客园首页文章链接和标题. 首先当然是环境了,爬虫在window10系统下,python ...
- Python 爬虫实例(7)—— 爬取 新浪军事新闻
我们打开新浪新闻,看到页面如下,首先去爬取一级 url,图片中蓝色圆圈部分 第二zh张图片,显示需要分页, 源代码: # coding:utf-8 import json import redis i ...
- python2.7 爬虫初体验爬取新浪国内新闻_20161130
python2.7 爬虫初学习 模块:BeautifulSoup requests 1.获取新浪国内新闻标题 2.获取新闻url 3.还没想好,想法是把第2步的url 获取到下载网页源代码 再去分析源 ...
- python3使用requests爬取新浪热门微博
微博登录的实现代码来源:https://gist.github.com/mrluanma/3621775 相关环境 使用的python3.4,发现配置好环境后可以直接使用pip easy_instal ...
- python3 爬虫---爬取糗事百科
这次爬取的网站是糗事百科,网址是:http://www.qiushibaike.com/hot/page/1 分析网址,参数''指的是页数,第二页就是'/page/2',以此类推... 一.分析网页 ...
随机推荐
- radio的取值
<dd id="pingjia${evaluation.orderItemId }" class="ms-wf clearfix" idx="$ ...
- 51开发环境的搭建--KeilC51的安装及工程的创建
学习单片机的开发,单靠书本的知识是远远不够的,必须实际操作编程才能领会书中的知识点,起到融会贯通的效果.51单片机作为入门级的单片机--上手容易.网上资源丰富.单片机稳定性及资源比较丰富.通过串口即可 ...
- 正则表达式(overall)
令自己想爱但深爱不上的正则表达式~ 阅读网站:http://c.biancheng.net/cpp/html/1402.html 为什么使用正则表达式? ①防止SQL注入:尤其对于网站,安全是至关重要 ...
- SpringMVC系列之URL匹配问题
一.工程目录 二.web.xml配置文件及与其他文件的关系 三.控制器部分 四.返回值 五.url前后缀 六.项目源代码 http://files.cnblogs.com/files/xujian20 ...
- (原创)使用mceusb设备,将lirc移植到android笔记
首先说一下大环境和总体步骤: 下载lirc 0.8.7源码,使用ubuntu的setup.sh,配置为mceusb的驱动,同时Compile tools for X-Windows选项去掉,生成con ...
- Delphi之Code Explorer
Code Explorer(代码浏览器)是Delphi IDE的特性之一,它大受用户的欢迎.正如其名所表示,Code Explorer用于快速浏览源代码单元.Code Explorer通常位于Code ...
- vuex - 常用命令学习及用法整理
https://vuex.vuejs.org/zh-cn/api.html 命令 用途 备注 this.$store 组件中访问store实例 store.state.a 获取在state对象中的数据 ...
- python的高级特性:切片,迭代,列表生成式,生成器,迭代器
python的高级特性:切片,迭代,列表生成式,生成器,迭代器 #演示切片 k="abcdefghijklmnopqrstuvwxyz" #取前5个元素 k[0:5] k[:5] ...
- CSS+transform画动态表情
先给大家看下画完后是什么样子: 代码看这里: html代码: <body> <div class="emoji emoji_like"> <div c ...
- [转]OpenStack Keystone V3
Keystone V3 Keystone 中主要涉及到如下几个概念:User.Tenant.Role.Token.下面对这几个概念进行简要说明. User:顾名思义就是使用服务的用户,可以是人.服务或 ...