
【大数据系列】HDFS文件权限和安全模式、安装
HDFS文件权限
1、与linux文件权限类型
r:read w:write x:execute权限x对于文件忽略,对于文件夹表示是否允许访问其内容
2、如果linux系统用户sanglp使用hadoop命令创建一个文件,那么这个文件在HDFS中owner就是sanglp
3、HDFS的权限目的:阻止好人做错事,而不是阻止坏人做坏事。
安全模式
1、 namenode启动的时候,首先将映像文件(fsimage)载入内存,并执行编辑日志(edits)中的各项操作。
2、 一旦在内存中成功建立文件系统元数据的映射,则创建一个新的fsimage文件(这个操作不需要SecondaryNameNode)和一个空的编辑日志。
3、 此刻namenode运行在安全模式。即namenode的文件系统对于客户端来说是只读的(显示目录、显示文件内容等。写、删除、重命名都会失败)
4、 在此阶段Namenode手机各个datanode的报告,当数据块达到最小副本数以上时,会被认为是“安全”的,在一定比例(可设置)的数据块被确定为“安全”后,再过若干时间,安全模式结束
5、 当检测到副本数不足的数据块时,该块会被复制直到最小副本数,系统中数据块的位置并不是由namenode维护的,而是以块列表示形式存储在datanode中。
HDFS安装
1、 伪分布式安装
2、 完全分布式安装
- 下载
- 解压
- 检查java和ssh的免密码登陆
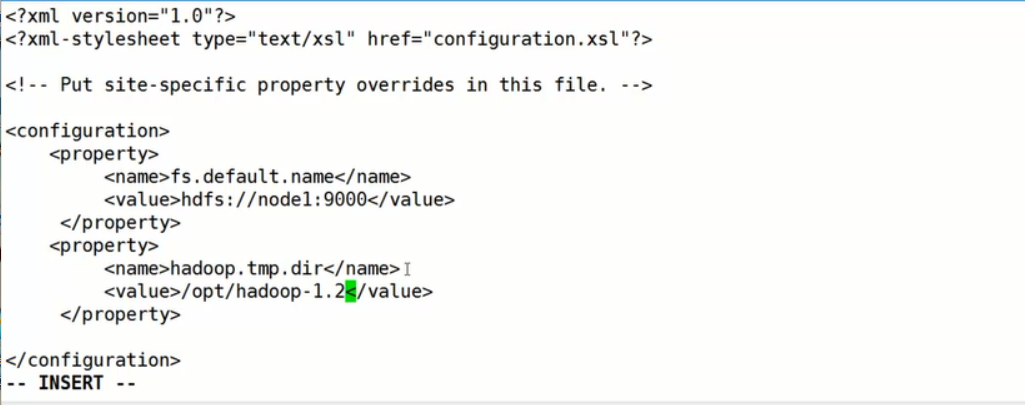
- 修改core-site.xml
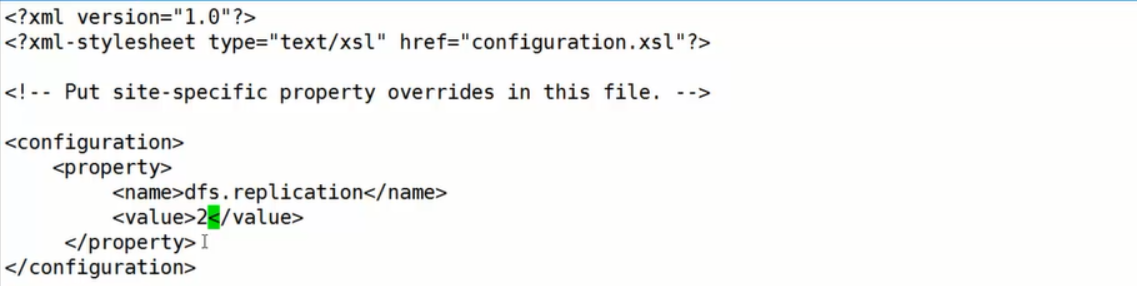
- 修改hdfs-site.xml
- 修改master文件和slaves文件
- 格式化namenode
- start-hdfs.sh启动
3、 按照文档安装
编辑core-site.xml (默认core-default.xml里有使用到的变量 fs.default.name配置的是NameNode的主机和入口)
编辑hdfs-site.xml(副本数是小于或等于DataNode的节点数的 hdfs-default.xml)
编辑slaves(配置datanode的ip信息)
修改masters(配置secondary NameNode 配置主机名或ip )
配置免密登陆是为了在任何一台机器上可以操作所有的节点
只启动hdfs的时候使用start-dfs.sh
需要在hadoop/conf/Hadoop-env.sh中配置JAVA_HOME
如果namenode启动的时候显示别的dataNode已经启动,但是别的主机上jps没有启动则关闭防火墙重新启动。
之后访问http://node1:50070查看详情NameNode DataNode等信息
【大数据系列】HDFS文件权限和安全模式、安装的更多相关文章
- hadoop学习笔记(四):HDFS文件权限,安全模式,以及整体注意点总结
本文原创,转载注明作者和原文链接! 一:总结注意点: 到现在为止学习到的角色:三个NameNode.SecondaryNameNode.DataNode 1.存储的是每一个文件分割存储之后的元数据信息 ...
- 【大数据系列】win10不借助Cygwin安装hadoop2.8
一.下载安装包 解压安装包并创建data,name,tmp文件夹 二.修改配置文件 1.core-site.xml <?xml version="1.0" encoding= ...
- 大数据系列2:Hdfs的读写操作
在前文大数据系列1:一文初识Hdfs中,我们对Hdfs有了简单的认识. 在本文中,我们将会简单的介绍一下Hdfs文件的读写流程,为后续追踪读写流程的源码做准备. Hdfs 架构 首先来个Hdfs的架构 ...
- 大数据系列文章-Hadoop的HDFS读写流程(二)
在介绍HDFS读写流程时,先介绍下Block副本放置策略. Block副本放置策略 第一个副本:放置在上传文件的DataNode:如果是集群外提交,则随机挑选一台磁盘不太满,CPU不太忙的节点. 第二 ...
- 大数据系列(3)——Hadoop集群完全分布式坏境搭建
前言 上一篇我们讲解了Hadoop单节点的安装,并且已经通过VMware安装了一台CentOS 6.8的Linux系统,咱们本篇的目标就是要配置一个真正的完全分布式的Hadoop集群,闲言少叙,进入本 ...
- 大数据系列(2)——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之Flume+kafka 整合
相关文章: 大数据系列之Kafka安装 大数据系列之Flume--几种不同的Sources 大数据系列之Flume+HDFS 关于Flume 的 一些核心概念: 组件名称 功能介绍 Agent ...
- 大数据系列(4)——Hadoop集群VSFTP和SecureCRT安装配置
前言 经过前三篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,当然,我相信安装的过程肯定遇到或多或少的问题,这些都需要自己解决,解决的过程就是学习的过程,本篇的来介绍几个Hadoop环 ...
随机推荐
- AOP (面向切面编程)
AOP (面向切面编程) 留个参考的地址,还没看呢:http://www.cnblogs.com/zhaolb/p/4875167.html
- RNA_seq GATK 最佳实践
GATK处理DNA 水平的snp 经验比较成熟,而RNA 水平较少,所以可能会存在错误 目前的流程兼顾了假阳性(不是真的snp位点)和假阴性(该位点是snp,却没有检测到):后续会不断改善 G ...
- 超炫酷的jQuery/HTML5应用效果及源码
jQuery非常强大,我们之前也用jQuery分享过很多实用的插件.HTML5可以让网页变得更加绚丽多彩,将HTML5和jQuery结合使用那将发挥更棒的效果. 今天向大家收集了一些关于HTML5和j ...
- win7下安装双系统Ubuntu14.04后开机没有win7,直接进入Ubuntu
开机进入Ubuntu后,打开命令端,输入: sudo update-grub 然后重启,则解决问题
- 【转帖】如何在redhat单机服务器上运行postgresql的多个实例(howto run multiple postgresql instance on one redhat server)
Running multiple PostgreSQL 9.2 Instances on one server in CentOS 6/RHEL 6/Fedora 原帖网站速度很慢,故转帖在此 Thi ...
- 安卓开发笔记——Menu菜单组件(选项菜单,上下文菜单,子菜单)
菜单是用户界面中最常见的元素之一,使用非常频繁,在Android中,菜单被分为如下三种,选项菜单(OptionsMenu).上下文菜单(ContextMenu)和子菜单(SubMenu). 菜单的实现 ...
- (转)Java程序员应该知道的10个调试技巧
(转自 酷勤网 – 程序员的那点事!http://www.kuqin.com/) 试可以帮助识别和解决应用程序缺陷,在本文中,作者将使用大家常用的的开发工具Eclipse来调试Java应用程序.但这里 ...
- 使用Fakes的Stub和Shim对ASP.NET MVC4进行单元测试
这是一篇导航文,不是翻译. MSDN对stub和shim的解释和使用场景演示:http://msdn.microsoft.com/en-us/library/hh549175.aspx 一个更详细的示 ...
- 理解select,poll,epoll实现分析
mark 引用:http://janfan.cn/chinese/2015/01/05/select-poll-impl-inside-the-kernel.html 文章 select()/poll ...
- MathType编辑粗体空心字的技巧
在用MathType公式编辑器编辑公式时,由于不同的使用需要,会有不同的字体要求.如果是正式的论文中的公式,一般公式只要求数学的国际使用规定就可以了,而如果是用在ppt等这种演示的文稿中,所要用到的字 ...