
深度增强学习--A3C
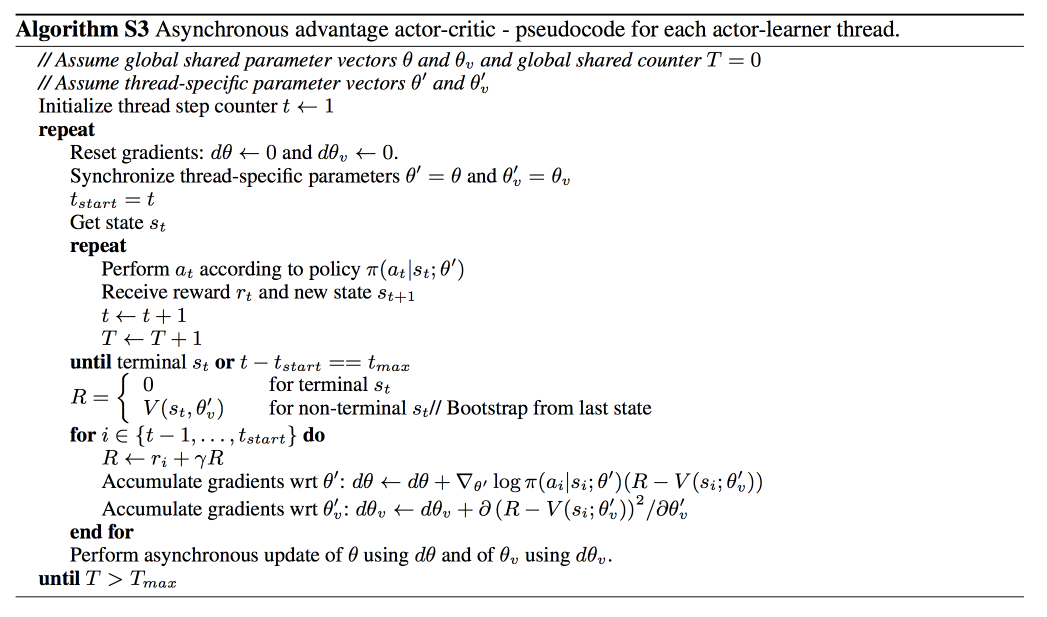
它会创建多个并行的环境, 让多个拥有副结构的 agent 同时在这些并行环境上更新主结构中的参数. 并行中的 agent 们互不干扰, 而主结构的参数更新受到副结构提交更新的不连续性干扰, 所以更新的相关性被降低, 收敛性提高
 import threading

 import numpy as np

 import tensorflow as tf

 import pylab

 import time

 import gym

 from keras.layers import Dense, Input

 from keras.models import Model

 from keras.optimizers import Adam

 from keras import backend as K

 # global variables for threading

 episode = 0

 scores = []

 EPISODES = 2000

 # This is A3C(Asynchronous Advantage Actor Critic) agent(global) for the Cartpole

 # In this example, we use A3C algorithm

 class A3CAgent:

     def __init__(self, state_size, action_size, env_name):

         # get size of state and action

         self.state_size = state_size

         self.action_size = action_size

         # get gym environment name

         self.env_name = env_name

         # these are hyper parameters for the A3C

         self.actor_lr = 0.001

         self.critic_lr = 0.001

         self.discount_factor = .99

         self.hidden1, self.hidden2 = 24, 24

         self.threads = 8  #8个线程并行

         # create model for actor and critic network

         self.actor, self.critic = self.build_model()

         # method for training actor and critic network

         self.optimizer = [self.actor_optimizer(), self.critic_optimizer()]

         self.sess = tf.InteractiveSession()

         K.set_session(self.sess)

         self.sess.run(tf.global_variables_initializer())

     # approximate policy and value using Neural Network

     # actor -> state is input and probability of each action is output of network

     # critic -> state is input and value of state is output of network

     # actor and critic network share first hidden layer

     def build_model(self):

         state = Input(batch_shape=(None,  self.state_size))

         shared = Dense(self.hidden1, input_dim=self.state_size, activation='relu', kernel_initializer='glorot_uniform')(state)

         actor_hidden = Dense(self.hidden2, activation='relu', kernel_initializer='glorot_uniform')(shared)

         action_prob = Dense(self.action_size, activation='softmax', kernel_initializer='glorot_uniform')(actor_hidden)

         value_hidden = Dense(self.hidden2, activation='relu', kernel_initializer='he_uniform')(shared)

         state_value = Dense(1, activation='linear', kernel_initializer='he_uniform')(value_hidden)

         actor = Model(inputs=state, outputs=action_prob)

         critic = Model(inputs=state, outputs=state_value)

         actor._make_predict_function()

         critic._make_predict_function()

         actor.summary()

         critic.summary()

         return actor, critic

     # make loss function for Policy Gradient

     # [log(action probability) * advantages] will be input for the back prop

     # we add entropy of action probability to loss

     def actor_optimizer(self):

         action = K.placeholder(shape=(None, self.action_size))

         advantages = K.placeholder(shape=(None, ))

         policy = self.actor.output

         good_prob = K.sum(action * policy, axis=1)

         eligibility = K.log(good_prob + 1e-10) * K.stop_gradient(advantages)

         loss = -K.sum(eligibility)

         entropy = K.sum(policy * K.log(policy + 1e-10), axis=1)

         actor_loss = loss + 0.01*entropy

         optimizer = Adam(lr=self.actor_lr)

         updates = optimizer.get_updates(self.actor.trainable_weights, [], actor_loss)

         train = K.function([self.actor.input, action, advantages], [], updates=updates)

         return train

     # make loss function for Value approximation

     def critic_optimizer(self):

         discounted_reward = K.placeholder(shape=(None, ))

         value = self.critic.output

         loss = K.mean(K.square(discounted_reward - value))

         optimizer = Adam(lr=self.critic_lr)

         updates = optimizer.get_updates(self.critic.trainable_weights, [], loss)

         train = K.function([self.critic.input, discounted_reward], [], updates=updates)

         return train

     # make agents(local) and start training

     def train(self):

         # self.load_model('./save_model/cartpole_a3c.h5')

         agents = [Agent(i, self.actor, self.critic, self.optimizer, self.env_name, self.discount_factor,

                         self.action_size, self.state_size) for i in range(self.threads)]#建立8个local agent

         for agent in agents:

             agent.start()

         while True:

             time.sleep(20)

             plot = scores[:]

             pylab.plot(range(len(plot)), plot, 'b')

             pylab.savefig("./save_graph/cartpole_a3c.png")

             self.save_model('./save_model/cartpole_a3c.h5')

     def save_model(self, name):

         self.actor.save_weights(name + "_actor.h5")

         self.critic.save_weights(name + "_critic.h5")

     def load_model(self, name):

         self.actor.load_weights(name + "_actor.h5")

         self.critic.load_weights(name + "_critic.h5")

 # This is Agent(local) class for threading

 class Agent(threading.Thread):

     def __init__(self, index, actor, critic, optimizer, env_name, discount_factor, action_size, state_size):

         threading.Thread.__init__(self)

         self.states = []

         self.rewards = []

         self.actions = []

         self.index = index

         self.actor = actor

         self.critic = critic

         self.optimizer = optimizer

         self.env_name = env_name

         self.discount_factor = discount_factor

         self.action_size = action_size

         self.state_size = state_size

     # Thread interactive with environment

     def run(self):

         global episode

         env = gym.make(self.env_name)

         while episode < EPISODES:

             state = env.reset()

             score = 0

             while True:

                 action = self.get_action(state)

                 next_state, reward, done, _ = env.step(action)

                 score += reward

                 self.memory(state, action, reward)

                 state = next_state

                 if done:

                     episode += 1

                     print("episode: ", episode, "/ score : ", score)

                     scores.append(score)

                     self.train_episode(score != 500)

                     break

     # In Policy Gradient, Q function is not available.

     # Instead agent uses sample returns for evaluating policy

     def discount_rewards(self, rewards, done=True):

         discounted_rewards = np.zeros_like(rewards)

         running_add = 0

         if not done:

             running_add = self.critic.predict(np.reshape(self.states[-1], (1, self.state_size)))[0]

         for t in reversed(range(0, len(rewards))):

             running_add = running_add * self.discount_factor + rewards[t]

             discounted_rewards[t] = running_add

         return discounted_rewards

     # save <s, a ,r> of each step

     # this is used for calculating discounted rewards

     def memory(self, state, action, reward):

         self.states.append(state)

         act = np.zeros(self.action_size)

         act[action] = 1

         self.actions.append(act)

         self.rewards.append(reward)

     # update policy network and value network every episode

     def train_episode(self, done):

         discounted_rewards = self.discount_rewards(self.rewards, done)

         values = self.critic.predict(np.array(self.states))

         values = np.reshape(values, len(values))

         advantages = discounted_rewards - values

         self.optimizer[0]([self.states, self.actions, advantages])

         self.optimizer[1]([self.states, discounted_rewards])

         self.states, self.actions, self.rewards = [], [], []

     def get_action(self, state):

         policy = self.actor.predict(np.reshape(state, [1, self.state_size]))[0]

         return np.random.choice(self.action_size, 1, p=policy)[0]

 if __name__ == "__main__":

     env_name = 'CartPole-v1'

     env = gym.make(env_name)

     state_size = env.observation_space.shape[0]

     action_size = env.action_space.n

     env.close()

     global_agent = A3CAgent(state_size, action_size, env_name)

     global_agent.train()
深度增强学习--A3C的更多相关文章
- 深度增强学习--DPPO
PPO DPPO介绍 PPO实现 代码DPPO
- 深度增强学习--DDPG
DDPG DDPG介绍2 ddpg输出的不是行为的概率, 而是具体的行为, 用于连续动作 (continuous action) 的预测 公式推导 推导 代码实现的gym的pendulum游戏,这个游 ...
- 深度增强学习--DQN的变形
DQN的变形 double DQN prioritised replay dueling DQN
- 深度增强学习--Actor Critic
Actor Critic value-based和policy-based的结合 实例代码 import sys import gym import pylab import numpy as np ...
- 深度增强学习--Policy Gradient
前面都是value based的方法,现在看一种直接预测动作的方法 Policy Based Policy Gradient 一个介绍 karpathy的博客 一个推导 下面的例子实现的REINFOR ...
- 深度增强学习--Deep Q Network
从这里开始换个游戏演示,cartpole游戏 Deep Q Network 实例代码 import sys import gym import pylab import random import n ...
- 常用增强学习实验环境 II (ViZDoom, Roboschool, TensorFlow Agents, ELF, Coach等) (转载)
原文链接:http://blog.csdn.net/jinzhuojun/article/details/78508203 前段时间Nature上发表的升级版Alpha Go - AlphaGo Ze ...
- 马里奥AI实现方式探索 ——神经网络+增强学习
[TOC] 马里奥AI实现方式探索 --神经网络+增强学习 儿时我们都曾有过一个经典游戏的体验,就是马里奥(顶蘑菇^v^),这次里约奥运会闭幕式,日本作为2020年东京奥运会的东道主,安倍最后也已经典 ...
- 增强学习 | AlphaGo背后的秘密
"敢于尝试,才有突破" 2017年5月27日,当今世界排名第一的中国棋手柯洁与AlphaGo 2.0的三局对战落败.该事件标志着最新的人工智能技术在围棋竞技领域超越了人类智能,借此 ...
随机推荐
- 怎么制作CHM格式电子书
CHM格式的帮助文件相信大家都不陌生,CHM文件形式多样,使用方便,深受大家喜爱. 今天给大家介绍一种把文本文件转换为CHM格式电子书的方法. 前期准备过程 1 下载QuickCHM v2.6文件 去 ...
- f'lask源码
上下文本质 ? 1 2 3 4 5 6 7 8 - 当请求过来后,将请求相关数据添加到 Local()类中 { 线程或协程唯一标识:{"stack":[re ...
- android studio 入门比较好的书籍
http://blog.csdn.NET/aqi00/article/details/50012511 http://blog.csdn.net/aqi00/article/details/73065 ...
- string char * const char *之间的互相转换
string -> const char * 用str的c_str()方法或者data()方法均可,这个两个方法返回值为cong char * string str = "hel ...
- [水煮 ASP.NET Web API2 方法论](1-1)在MVC 应用程序中添加 ASP.NET Web API
问题 怎么样将 Asp.Net Web Api 加入到现有的 Asp.Net MVC 项目中 解决方案 在 Visual Studio 2012 中就已经把 Asp.Net Web Api 自动地整合 ...
- redis的运行机制
从以前总结的redis一些基本性能中,可知redis是非关系型数据库(nosql):这一类的数据类型有以下特点: 非关系型的(sql语句对它不起作用,不需要建表存数据,它是直接存储),分布式(主从复制 ...
- PDF文档盖章
概述 在pdf文档的最后一页,合适位置,添加印章图片. maven依赖 <dependency> <groupId>com.itextpdf</groupId> & ...
- VB查询数据库之结账——机房收费系统总结(五)
对于机房收费的结账,我感觉是所有窗体中,最难的一个.这个窗体我真的做了好多天.它的难度系数我感觉是最高的. 首先,你要理清上机时间和收费标准的关系,在预备时间中,是不收费的. 其次,在超过预备时间,一 ...
- [BZOJ 1901] Dynamic Rankings
Link: BZOJ 1901 传送门 Solution: 带修改主席树的模板题 对于静态区间第$k$大直接上主席树就行了 但加上修改后会发现修改时复杂度不满足要求了: 去掉/增加第$i$位上的值时要 ...
- k-近邻算法 简单例子
from numpy import * import operator def create_data_set(): # 训练集与标签 group = array([[1.0, 1.1], [1.0, ...