
scrapy--Beautyleg
很早就开始关注:Beautyleg 高清丝袜美腿.关注之后开始觉得打开了新世界的大门,如果有相同观点的,那么你很有品味.说真的,学习爬虫的动力之一就是想把里面的图片爬取下来。哈哈哈!!!
给大家放点爬取完的图片,激励下大家赶紧动手。嘿嘿嘿
1.Beauty.py
# -*- coding: utf-8 -*-

import scrapy

from scrapy.pipelines.images import ImagesPipeline

from scrapy.linkextractors import LinkExtractor

from beauty.items import BeautyItem

import pdb

class BeautySpider(scrapy.Spider):

    name = 'Beauty'

    allowed_domains = ['www.beautylegmm.com']

    start_urls = ['http://www.beautylegmm.com/']

    def parse(self, response):

        le = LinkExtractor(restrict_css='div.post_weidaopic')

        #pdb.set_trace()

        for link in le.extract_links(response):

            yield scrapy.Request(link.url,callback=self.parse_url)

        le2 = LinkExtractor(restrict_css='ol.page-navigator')

        for link2 in le2.extract_links(response):

            yield scrapy.Request(link2.url,callback=self.parse)

    def parse_url(self,response):

        photo = BeautyItem()

        if response.css('div.post a::attr(href)'):

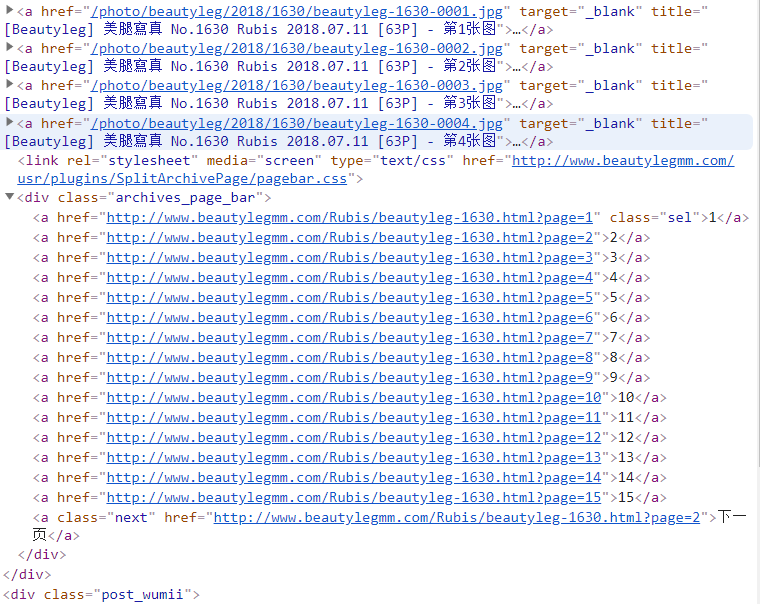
            for href in response.css('div.post a::attr(href)')[:4]:     #<a href=''>有很多,就只有前4个是图片地址,取前4个连接就够了.没有域名:<a href="/photo/beautyleg/2018/1630/beautyleg-1630-0001.jpg">

                full_url  = response.urljoin(href.extract())         #使用response.urljoin(),整合src,获得图片的绝对路径:http://www.beautylegmm.com/photo/beautyleg/2018/1630/beautyleg-1630-0001.jpg

                photo['images_url'] = full_url

                yield photo

        le1 = LinkExtractor(restrict_css='div.grid_10 div.post')       #获取页数:<a href="http://www.beautylegmm.com/Rubis/beautyleg-1630.html?page=1" >

        for link1 in le1.extract_links(response):

            #pdb.set_trace()

            yield scrapy.Request(link1.url,callback=self.parse_url)
2.items.py
import scrapy

class BeautyItem(scrapy.Item):

    images_url = scrapy.Field()

    images     = scrapy.Field()
3.pipelines.py
import scrapy

from scrapy.exceptions import DropItem

from scrapy.pipelines.images import ImagesPipeline

import pdb

class BeautyPipeline(ImagesPipeline):

    def get_media_requests(self,item,info):

        yield scrapy.Request(item['images_url'])

    def item_completed(self,results,item,info):

        images_path = [x['path'] for ok,x in results if ok]

        if not images_path:

            raise DropItem ('item contain no images')

        return item
4.settings.py
USER_AGENT ={       #设置浏览器的User_agent

    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/22.0.1207.1 Safari/537.1",

    "Mozilla/5.0 (X11; CrOS i686 2268.111.0) AppleWebKit/536.11 (KHTML, like Gecko) Chrome/20.0.1132.57 Safari/536.11",

    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1092.0 Safari/536.6",

    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1090.0 Safari/536.6",

    "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/19.77.34.5 Safari/537.1",

    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.9 Safari/536.5",

    "Mozilla/5.0 (Windows NT 6.0) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.36 Safari/536.5",

    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3",

    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3",

    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_8_0) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3",

    "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.0 Safari/536.3",

    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24",

    "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24"

}

CONCURRENT_REQUESTS = 16    #同时来16个请求

DOWNLOAD_DELAY = 0.2        #0.2s后开启处理第一个请求

ROBOTSTXT_OBEY = False

LOAD_TRUNCATED_IMAGES = True

COOKIES_ENABLED = False

ITEM_PIPELINES = {

    'beauty.pipelines.BeautyPipeline': 1,

}
好了,有感兴趣的小伙伴,遇到什么问题可以来咨询我!!!
scrapy--Beautyleg的更多相关文章
- Scrapy框架爬虫初探——中关村在线手机参数数据爬取
关于Scrapy如何安装部署的文章已经相当多了,但是网上实战的例子还不是很多,近来正好在学习该爬虫框架,就简单写了个Spider Demo来实践.作为硬件数码控,我选择了经常光顾的中关村在线的手机页面 ...
- scrapy爬虫docker部署
spider_docker 接我上篇博客,为爬虫引用创建container,包括的模块:scrapy, mongo, celery, rabbitmq,连接https://github.com/Liu ...
- scrapy 知乎用户信息爬虫
zhihu_spider 此项目的功能是爬取知乎用户信息以及人际拓扑关系,爬虫框架使用scrapy,数据存储使用mongo,下载这些数据感觉也没什么用,就当为大家学习scrapy提供一个例子吧.代码地 ...
- ubuntu 下安装scrapy
1.把Scrapy签名的GPG密钥添加到APT的钥匙环中: sudo apt-key adv --keyserver hkp://keyserver.ubuntu.com:80 --recv 6272 ...
- 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
上周学习了BeautifulSoup的基础知识并用它完成了一个网络爬虫( 使用Beautiful Soup编写一个爬虫 系列随笔汇总 ), BeautifulSoup是一个非常流行的Python网 ...
- Scrapy:为spider指定pipeline
当一个Scrapy项目中有多个spider去爬取多个网站时,往往需要多个pipeline,这时就需要为每个spider指定其对应的pipeline. [通过程序来运行spider],可以通过修改配置s ...
- scrapy cookies:将cookies保存到文件以及从文件加载cookies
我在使用scrapy模拟登录新浪微博时,想将登录成功后的cookies保存到本地,下次加载它实现直接登录,省去中间一系列的请求和POST等.关于如何从本次请求中获取并在下次请求中附带上cookies的 ...
- Scrapy开发指南
一.Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. Scrapy基于事件驱动网络框架 Twis ...
- 利用scrapy和MongoDB来开发一个爬虫
今天我们利用scrapy框架来抓取Stack Overflow里面最新的问题(),并且将这些问题保存到MongoDb当中,直接提供给客户进行查询. 安装 在进行今天的任务之前我们需要安装二个框架,分别 ...
- python3 安装scrapy
twisted(网络异步框架) wget https://pypi.python.org/packages/dc/c0/a0114a6d7fa211c0904b0de931e8cafb5210ad82 ...
随机推荐
- node搭环境(四)--webpack启服务运行VUE模块文件(手写简单脚手架)
webpack启服务步骤: 1.新建空文件夹webpack-vue.在空文件夹右键点击- GIt Bath here--输入cnpm init--按程序走完会生成package.json文件 2.打开 ...
- 初步学习XML的基本代码
using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.T ...
- 硬盘的基础知识-SSD
硬盘有三类:HDD(机械硬盘),SSD(固态硬盘),HHD(混合硬盘) 原理: HDD:磁性碟片 SSD: 闪存颗粒 HHD:磁性碟片的基础上加上了闪存颗粒. 这里对HDD,HHD不加说明,只对SSD ...
- Python中基本数据类型与对字符串处理的方法
一.基本数据类型(int,bool,str) 1.基本数据类型: int 整数 整数 str字符串 一般不用来存放大量的数据 bool布尔值 用来判断(True,False) list 列表.用来存 ...
- 让你的sharepoint2013具有EMS快递查询的功能
<iframe name="kuaidi100" src="http://www.kuaidi100.com/frame/app/index2.html" ...
- C#面向对象几组关键字的详解(this,base,dynamic,var,const,readonly,is,as)
× 目录 [1]this和base的区别 [2]var和dynamic的区别 [3]const和readonly的区别 [4]is和as的区别 这几个关键字,在用法上有许多相似之处.这里主要看看细节之 ...
- 2.eclipse安装
1.进入官网https://www.eclipse.org/ 2.配置工作目录:存放 1.项目代码 2.IDE相关配置信息 3.没有配置tomcat,所以为空.
- 酷狗音乐PC端怎么使用听歌识曲功能?
生活中很多时候会听到一些美妙的音乐,耳熟或者动听却不知道它的名字.就像第一眼看到你心动的那个她却不知她叫什么.移动端有酷狗音乐的听歌识曲.现在PC端也有了相同的功能,每当我们看到一部精彩影视剧听到美妙 ...
- UE4工具
COMMON CONTAINERS TARRAY (Engine\Source\Runtime\Core\Public\Containers\Array.h) TSET (Engine\Source\ ...
- 微信小程序加载本地图片方法
目录结构如下,只要图片按正确的方式放入小程序的开发工具的项目中,即可在wxml文件中用内联样式或者image标签都可以引用本地的图片. 步骤一:微信开发工具 打开项目 步骤二:新建个文件夹(放项目的一 ...