
requests,lxml爬启信宝
首先,
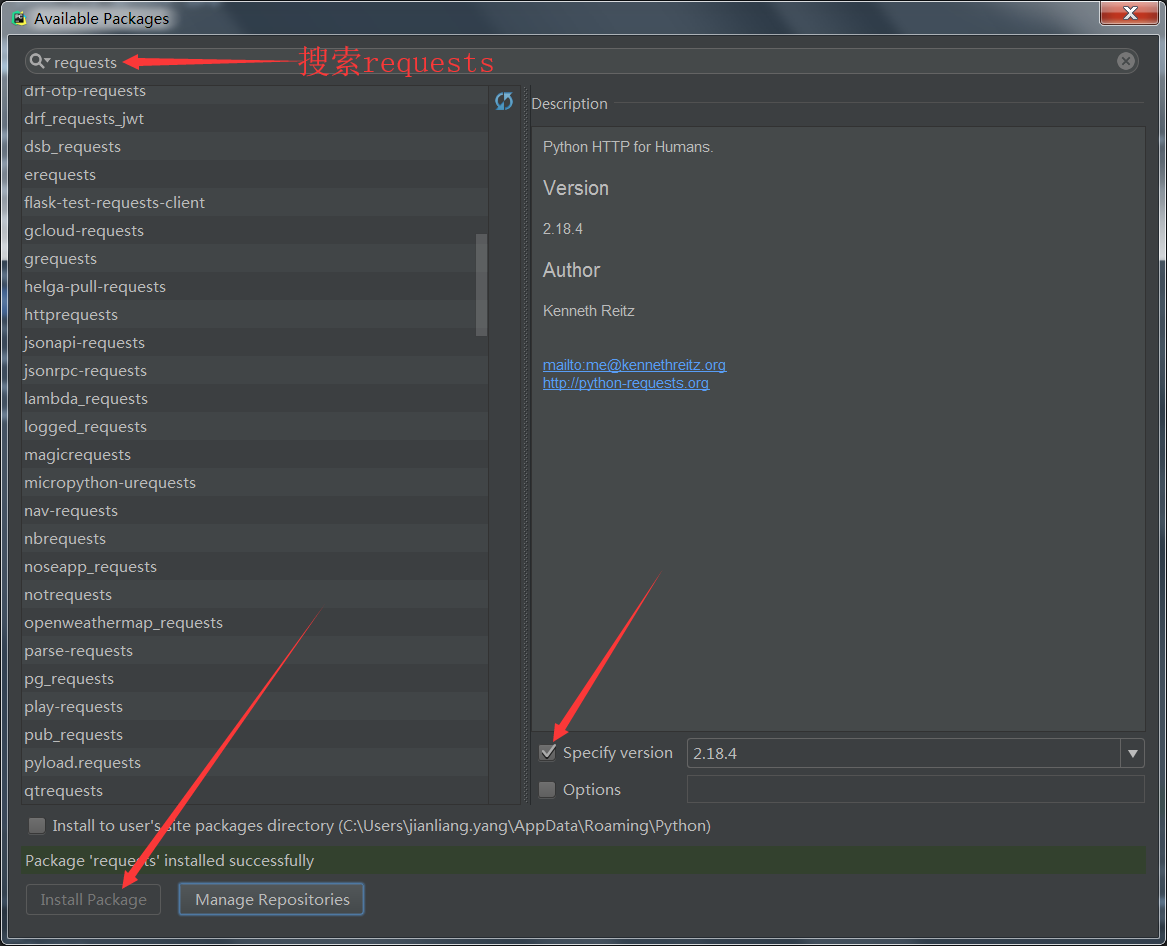
添加requests模块:
然后,
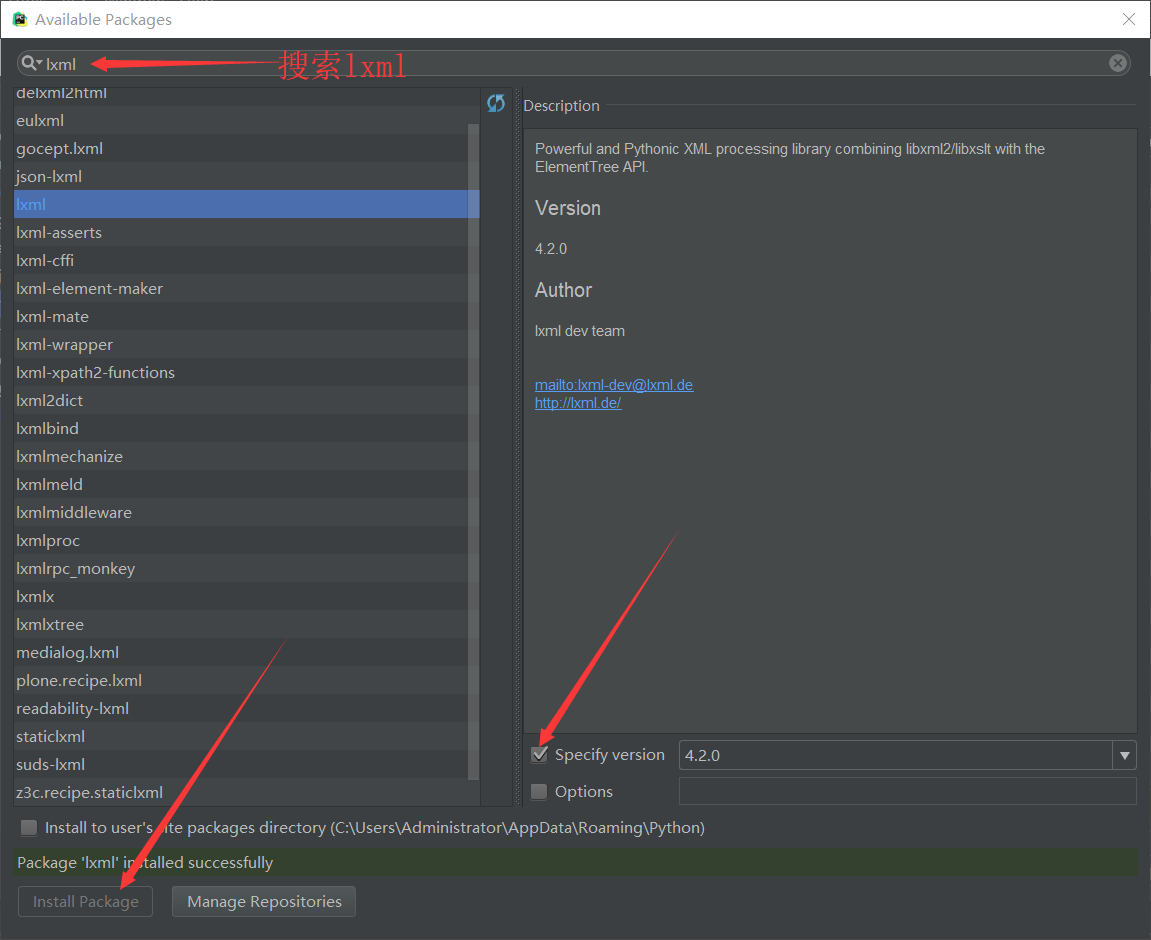
添加lxml模块:
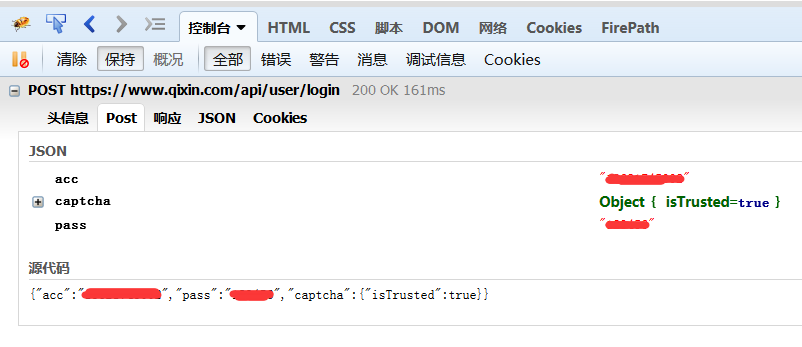
启信宝登录抓包:
QiXinBao.py:
import requests
from lxml import etree

loginUrl = "https://www.qixin.com/api/user/login"
# 启信宝登录接口
homePage = "https://www.qixin.com"
# 启信宝首页

headers = {"Accept": "application/json, text/plain, */*",
           "Accept-Encoding": "gzip, deflate, br",
           "Accept-Language": "zh-CN,zh;q=0.8,en-US;q=0.5,en;q=0.3",
           "Content-Length": "66",
           "Content-Type": "application/json;charset=utf-8",
           "Host": "www.qixin.com",
           "Referer": "https://www.qixin.com/auth/login?return_url=%2Fnew-vip",
           "User-Agent": "Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:52.0) Gecko/20100101 Firefox/52.0",
           "X-Requested-With": "XMLHttpRequest",
           "dc49417fe4f34f86b0fe": "44282ce68be84e73f8eb4d2a4d4b32c02e8e84970160b2d6829c6b8a5380483e50ec708bc38040dd715d283dfac3123cf422ecff2fe4977c8624e457c5046959"
           }
# 请求头(伪装成浏览器)
parameter = {"acc": "13688888888", "pass": "000000", "captcha": {"isTrusted": True}}
# 请求体

session = requests.Session()
# 保持会话
response_1 = session.post(loginUrl, headers=headers, json=parameter, timeout=5)
# 登录
print(response_1.status_code)
# 打印响应码

response_2 = session.get(homePage).content
# 打开启信宝首页
page_2 = etree.HTML(response_2)
link = page_2.xpath("//html/body/div[1]/div[4]/div/div[2]/div/div[1]/div[1]/a//@href")
companyUrl = homePage+link[0]
# 获取第一家公司的URL

response_3 = session.get(companyUrl).content
# 打开第一家公司
page_3 = etree.HTML(response_3)
companyName = page_3.xpath("//html/body/div[6]/div/div[2]/div/div/h4//text()")
# 获取公司名称
code_1 = page_3.xpath("//*[@id='icinfo']/table/tbody/tr[1]/td[2]//text()")
# 获取统一社会信用代码
code_2 = page_3.xpath("//*[@id='icinfo']/table/tbody/tr[2]/td[2]//text()")
# 获取注册号

print(companyName[0]+"\n"+code_1[0]+"\n"+code_2[0])
requests,lxml爬启信宝的更多相关文章
- selenium + ChromeDriver 实战系列之启信宝(一)
之前写了一篇selenium + ChromeDriver的一些入门的知识,这篇博客里面找了启信宝这个网站,简单的进行了一个实战练习.本篇博客的结构如下: 首先会给出一些使用seleniu ...
- requests+lxml+xpath爬取豆瓣电影
(1)lxml解析html from lxml import etree #创建一个html对象 html=stree.HTML(text) result=etree.tostring(html,en ...
- 爬虫系列2:Requests+Xpath 爬取租房网站信息
Requests+Xpath 爬取租房网站信息 [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]:参考前文 ...
- <day003>登录+爬取淘宝商品信息+字典用json存储
任务1:利用cookie可以免去登录的烦恼(验证码) ''' 只需要有登录后的cookie,就可以绕过验证码 登录后的cookie可以通过Selenium用第三方(微博)进行登录,不需要进行淘宝的滑动 ...
- [实战演练]python3使用requests模块爬取页面内容
本文摘要: 1.安装pip 2.安装requests模块 3.安装beautifulsoup4 4.requests模块浅析 + 发送请求 + 传递URL参数 + 响应内容 + 获取网页编码 + 获取 ...
- 利用Python爬虫爬取淘宝商品做数据挖掘分析实战篇,超详细教程
项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 项目目的 1. 对商品标题进行文本分析 词云可视化 2. ...
- 爬虫系列1:Requests+Xpath 爬取豆瓣电影TOP
爬虫1:Requests+Xpath 爬取豆瓣电影TOP [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]: ...
- 利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍 Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样.由于这个性质,Selenium也是一 ...
- python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件
第二个例子是使用requests库+re库爬取淘宝搜索商品页面的商品信息 (1)分析网页源码 打开淘宝,输入关键字“python”,然后搜索,显示如下搜索结果 从url连接中可以得到搜索商品的关键字是 ...
随机推荐
- 一款css3的标签动画效果
/*响应式设计,动画效果需引入animate.min.css库*/ <div class="index_tag"> <div class="rowFlu ...
- 简单使用idea Spring Boot搭建项目
第一步:使用Spring Initializr创建 第二步:项目配置 第三步:选择项目需要的依赖 第五步: ok 创建完成,修改仓库 maven{ url 'http://maven.aliyun.c ...
- 【Node.js学习笔记】使用Gulp项目自动化构建工具
刚接触node.js,对前端的一些东西还不是很清楚,据说Gulp这东西很强大,先来看看从网上抄的一段关于自动化构建的描述: 在为数众多的中小型软件作坊中,不存在自动化构建和发布工具.构建.交付准备环境 ...
- Node.js笔记07——不使用generator自定义一个项目,深入了解项目结构
一.初始化项目 新建项目 git init manager 新建view文件夹,建几个静态文件夹 新建app.js 快速初始化项目依赖 npm init -y 安装express npm instal ...
- AOP切点切面内容
一.实现接口MethodBeforeAdvice该拦截器会在调用方法前执行 实现接口 AfterReturningAdvice该拦截器会在调用方法后执行 ...
- DQL-条件查询
二 :条件查询 语法:select 列表名 from 表名 where 筛选条件 例如: select salary from employees where salary> ...
- Oracle查找lobsegment、lobindex对应的表
在查看表空间的使用情况的时候,发现有几个LOBSEGMENT.LOBINDEX类型的对象占用了大量的空间.于是想找出那些表占用了大量的空间,以便于清理. Oracle对BLOB类型的定义 ...
- ubuntu网卡配置及安装ssh服务
1.ubuntu网卡配置 1.查看网卡名称 ip a 2.进行编辑网卡配置文件 sudo vi /etc/network/interfaces 更改网卡配置文件添加内容修改内容如下:下面的enp0s3 ...
- python字符编码转换说明及深浅copy介绍
编码说明: 常用编码介绍: ascii 数字,字母 特殊字符. 字节:8位表示一个字节. 字符:是你看到的内容的最小组成单位. abc : a 一个字符. 中国:中 一个字符. a : 0000 10 ...
- Action与Func 用法
//vs2017 + framework4.6.2 //zip https://github.com/chxl800/ActionFuncDemo //源文件git https://gith ...