
requests+lxml+xpath爬取豆瓣电影
(1)lxml解析html
from lxml import etree

#创建一个html对象

html=stree.HTML(text)

result=etree.tostring(html,encoding="utf-8").decode("utf-8")
requests+lxml+xpath实现豆瓣电影爬虫
import requests

from lxml import etree
headers={
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36',
}
原始界面:
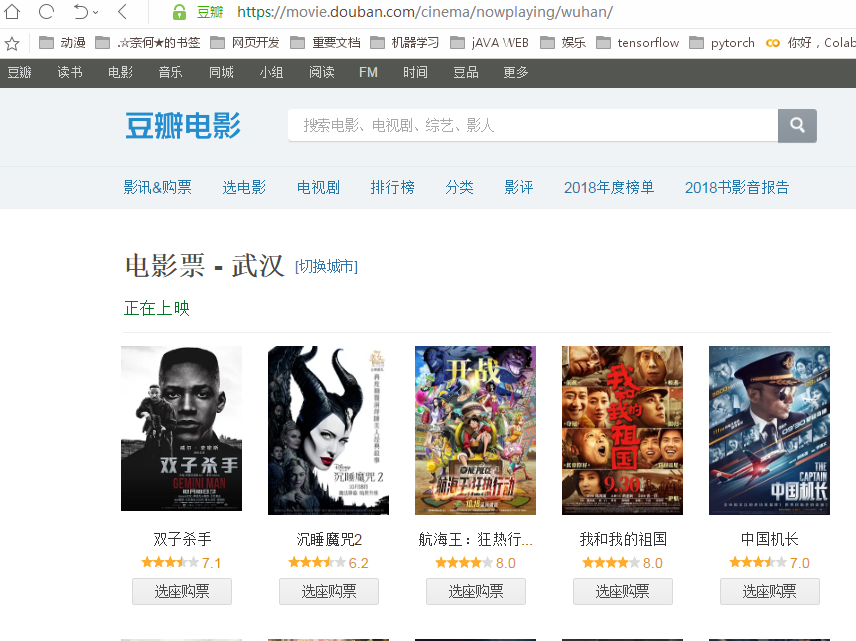
url="https://movie.douban.com/cinema/nowplaying/wuhan/"

response=request.get(url,headers=headers)

text=response.text

html=etree.HTML(text)
我们会得到一个html对象

转换成字符串看下结果
result=etree.tostring(html,encoding="utf-8").decode("utf-8")
部分结果如下:
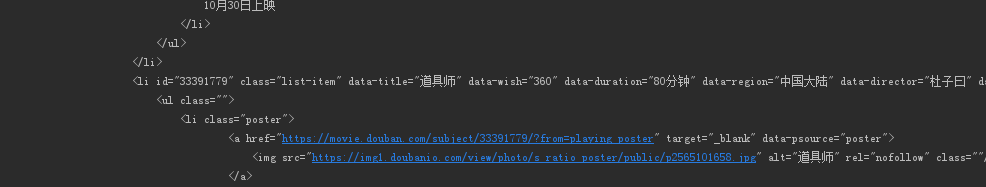
然后进行xpath解析:
我们对准其中一部电影点击鼠标右键--检查,得到如下视图:

我们发现,上映电影的信息都在带有属性lists的ul中,我们可以对此进行xpath解析,(我们解析的是html对象,而不是转成字符串的结果):
uls=html.xpath("//ul[@class='lists']")[0]
我们在转成字符串查看一下结果:
res=etree.tostring(uls,encoding="utf-8").decode("utf-8")

print(res)

正是我们想要的,我们接着解析里面的内容:
首先获取所有的li:
#这句的意思是获取当前uls下的所有直接li
lis=uls.xpath("./li)
结果是一系列的li对象:
我们再分别进行解析:
movies=[]

for li in lis:

    name=li.xpath("@data-title")[0]

    score=li.xpath("@data-score")[0]

    country=li.xpath("@data-region")[0]

    director=li.xpath("@data-director")[0]

    actors=li.xpath("@data-actors")[0]

    category=li.xpath("@data-category")[0]

    movie={

        "name":name,

        "score":score,

        "country":country,

        "director":director,

        "actors":actors,

        "category":category

    }

    movies.append(movie)

print(movies)
部分结果如下:

在json中格式化结果如下:

至此,一个初步的爬虫就完成了。
requests+lxml+xpath爬取豆瓣电影的更多相关文章
- 爬虫系列(十) 用requests和xpath爬取豆瓣电影
这篇文章我们将使用 requests 和 xpath 爬取豆瓣电影 Top250,下面先贴上最终的效果图: 1.网页分析 (1)分析 URL 规律 我们首先使用 Chrome 浏览器打开 豆瓣电影 T ...
- 爬虫系列(十一) 用requests和xpath爬取豆瓣电影评论
这篇文章,我们继续利用 requests 和 xpath 爬取豆瓣电影的短评,下面还是先贴上效果图: 1.网页分析 (1)翻页 我们还是使用 Chrome 浏览器打开豆瓣电影中某一部电影的评论进行分析 ...
- 爬虫系列1:Requests+Xpath 爬取豆瓣电影TOP
爬虫1:Requests+Xpath 爬取豆瓣电影TOP [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]: ...
- requests+lxml+xpath爬取电影天堂
1.导入相应的包 import requests from lxml import etree 2.原始ur url="https://www.dytt8.net/html/gndy/dyz ...
- requests结合xpath爬取豆瓣最新上映电影
# -*- coding: utf-8 -*- """ 豆瓣最新上映电影爬取 # ul = etree.tostring(ul, encoding="utf-8 ...
- python3+requests+BeautifulSoup+mysql爬取豆瓣电影top250
基础页面:https://movie.douban.com/top250 代码: from time import sleep from requests import get from bs4 im ...
- Python爬虫爬取豆瓣电影之数据提取值xpath和lxml模块
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统.谷歌浏览器 目的:爬取豆瓣电影排行榜中电影的title.链接地址.图片.评价人数.评分等 网址:https:// ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
随机推荐
- MySQL数据库忘记密码怎么办?
忘记MySQL数据库密码就进不去数据库,也就无法修改密码,解决方法如下: 1:打开cmd命令符,先关闭正在运行的数据库,输入如下命令: 2:打开mysql.exe和mysqld.exe所在的文件夹,复 ...
- Spring 梳理-传递模型数据到视图
传递model,返回string,不指定返回key package com.jt; import com.myOrg.DeptUserDomain; @Controller @RequestMappi ...
- Scanner类的next()方法和nextLine()方法的异同点
通过一段代码就可以明白其中的奥妙!! import java.util.Scanner; public class next_nextLine { public static void main(St ...
- Bootstrap入门学习笔记(只记录了效果)
基本头文件 <!DOCTYPE html> <html> <head> <title>Bootstrap 实例</title> <me ...
- asp.net编译中出现 数据库 'C:\Program Files\Microsoft SQL Server\MSSQL10_50.MSSQLSERVER\MSSQL\DATA\test1.mdf' 已存在。请选择其他数据库名称。
关于asp.net编译中出现数据库 'C:\Program Files\Microsoft SQL Server\MSSQL10_50.MSSQLSERVER\MSSQL\DATA\test1.mdf ...
- vue 引入 fontawesome 报错 Could not find one or more icon(s) 解决
在 vue 项目中引用 fontawesome , 按照官方说明如下步骤操作 1. 终端中执行 $ npm i --save @fortawesome/fontawesome-svg-core $ n ...
- Docker下配置nacos
前言 近段时间在学dubbo,dubbo-admin死活装不上,无论是本地还是docker,所以把目光投向了其他配置中心,我选定的是阿里新开源的nacos. 正文 拉取镜像到本地docker dock ...
- BZOJ 1345: [Baltic2007]序列问题Sequence
1345: [Baltic2007]序列问题Sequence Time Limit: 5 Sec Memory Limit: 162 MBSubmit: 1180 Solved: 633[Subm ...
- python接口自动化2-第一次发送get请求
前言 Requests: 让 HTTP 服务人类,唯一的一个非转基因的 Python HTTP 库,人类可以安全享用: Requests继承了urllib2的所有特性,能满足当前网络的需求,支持Pyt ...
- 算法学习之剑指offer(二)
题目1 题目描述 用两个栈来实现一个队列,完成队列的Push和Pop操作. 队列中的元素为int类型. import java.util.Stack; public class Solution { ...