
Spark大数据处理框架入门(单机版)
导读
- 引言
- 环境准备
- 安装步骤
- 1.下载地址
- 2.开始下载
- 3.解压spark
- 4.配置环境变量
- 5.配置 spark-env.sh
- 6.启动spark服务
- 7.测试spark
stay hungry stay foolish.
引言
2012年,UC Berkelye 的ANPLab研发并开源了新的大数据处理框架Spark。其核心思想包括两方面:一方面对大数据处理框架的输入/输出、中间数据进行建模,将这些数据抽象为统一的数据结构,命名为弹性分布式数据集(Resilent Distributed Dataset,RDD),并在此数据结构上构建了一系列通用的数据操作,使得用户可以简单地实现复杂的数据处理流程;另一方面采用基于内存的数据聚合、数据缓存等机制来加速应用执行,尤其适用于迭代和交互式应用。Spark采用EPFL大学研发的函数式编程语言Scala实现,并且提供了Scala、Java、Python、R四种语言的接口,以方便开发者适用熟悉的语言进行大数据应用开发。
话不多说,现在就开始我们的Spark之旅吧!
一 环境准备:
| 服务器 | 配置 | 单机 | 文件目录 |
|---|---|---|---|
| Centos7 | 4核,14G | master | /opt/spark/spark-3.1.1-bin-hadoop2.7/ |
- Spark 3.1.1
- Hadoop 3.2
- Scala 1.11
- Java OpenJdk 1.8.0_292
二 安装步骤
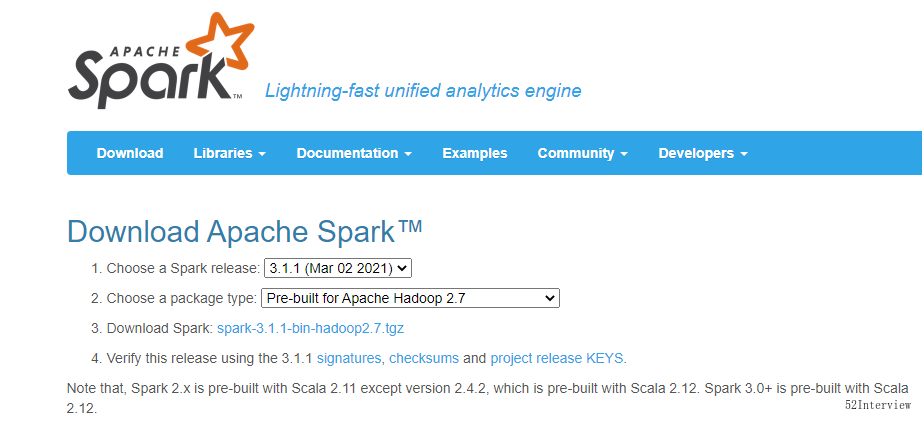
1.下载地址
http://spark.apache.org/downloads.html
如下图所示:选择3.1.1版本的spark,并选择对应的Hadoop 版本
2.开始下载
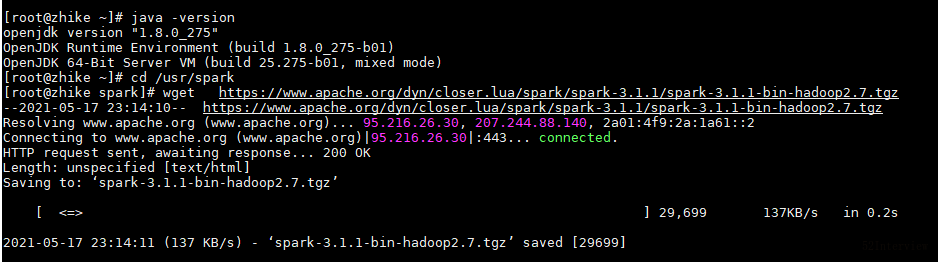
wget https://www.apache.org/dyn/closer.lua/spark/spark-3.1.1/spark-3.1.1-bin-hadoop2.7.tgz
Notes: centos下,先进入某个目录,比如/opt/spark目录,然后执行下载
3.解压spark
这里解压到/opt/spark/
sudo tar zxvf spark-3.1.1-bin-hadoop2.7.tgz
4.配置环境变量
# vim /etc/profile
新增内容:
#spark environment

export SPARK_HOME=/opt/spark/spark-3.1.1-bin-hadoop2.7

export PATH=${SPARK_HOME}/bin:$PATH
退出并保存;刷新资源使配置生效。
# source /etc/profile
5.配置 spark-env.sh
进入 conf目录
# cd conf
重命名
# mv spark-env.sh.template spark-env.sh
修改spark-env.sh
# vim spark-env.sh
在spark-env.sh增加如下内容:
# java

JAVA_HOME=/usr

# hadoop CONF

HADOOP_CONF_DIR=/usr/hadoop/hadoop-2.7.7/etc/hadoop
温馨提示:
java环境变量地址 以具体机器的java安装为准,若使用yum安装java环境变量配置路径
查询本机Java安装路径
which java
/usr/bin/java
配置Java环境变量:
# java

 #java

JAVA_HOME=/usr
6.启动spark服务
./start-all.sh
Notes: 也可以指定启动 ./sbin/start-master.sh
在浏览器输入服务器外网地址访问

7 测试spark
spark自带了一些测试demo,可以参照官方文档:http://spark.apache.org/docs/latest/quick-start.html
7.1 spark-shell 方式
进入handoop目录,
cd /opt/spark-3.1.1-bin-hadoop3.2/
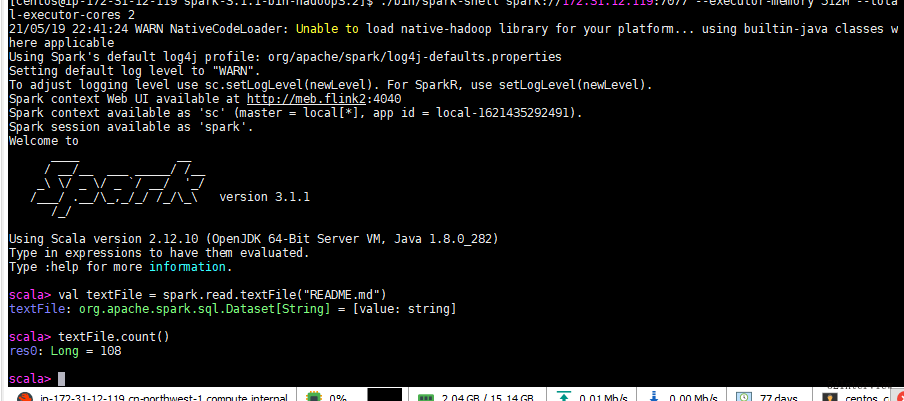
执行spark-shell
./bin/spark-shell spark://xxxx.xxxx.12.119:7077 --executor-memory 512M --total-executor-cores 2
Using Scala version 2.12.10 (OpenJDK 64-Bit Server VM, Java 1.8.0_282)

Type in expressions to have them evaluated.

Type :help for more information.

scala> val textFile = spark.read.textFile("README.md")

textFile: org.apache.spark.sql.Dataset[String] = [value: string]

scala> textFile.count()

res0: Long = 108

scala>
温馨提示:
如果出现以下错误.
WARN TaskSchedulerImpl: Initial job has not accepted any resources; check your cluster UI to ensure
解决方案:启动这个spark-shell的时候指明内存大小
./bin/spark-shell spark://172.31.xx.xx:7077 --executor-memory 512M --total-executor-cores 2
7.2 spark-submit 提交
执行如下命令
bin/spark-submit \

--class org.apache.spark.examples.SparkPi \

--master spark://YOURHOST:7077 \

--executor-memory 500M \

--total-executor-cores 2 \

/opt/spark/spark-3.1.1-bin-hadoop3.2/examples/jars/spark-examples_2.12-3.1.1.jar \

10
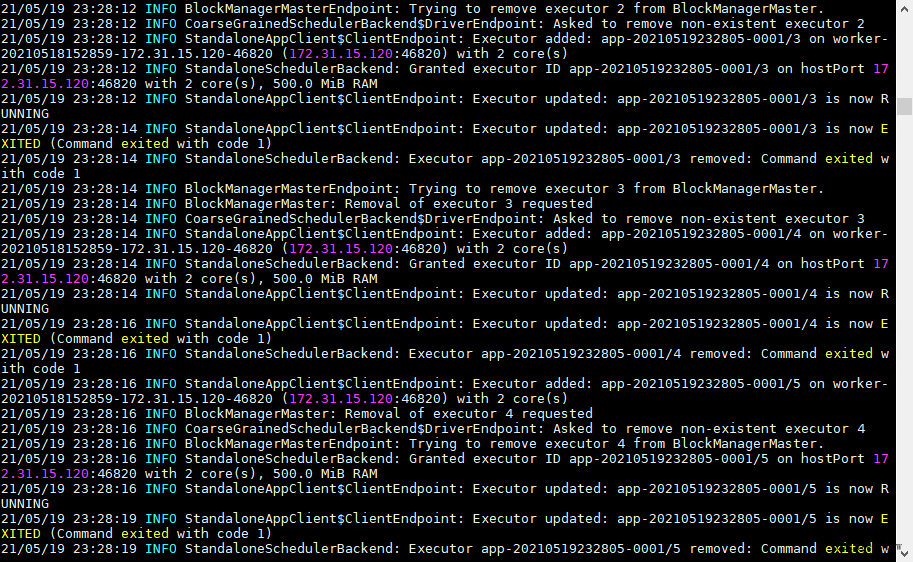
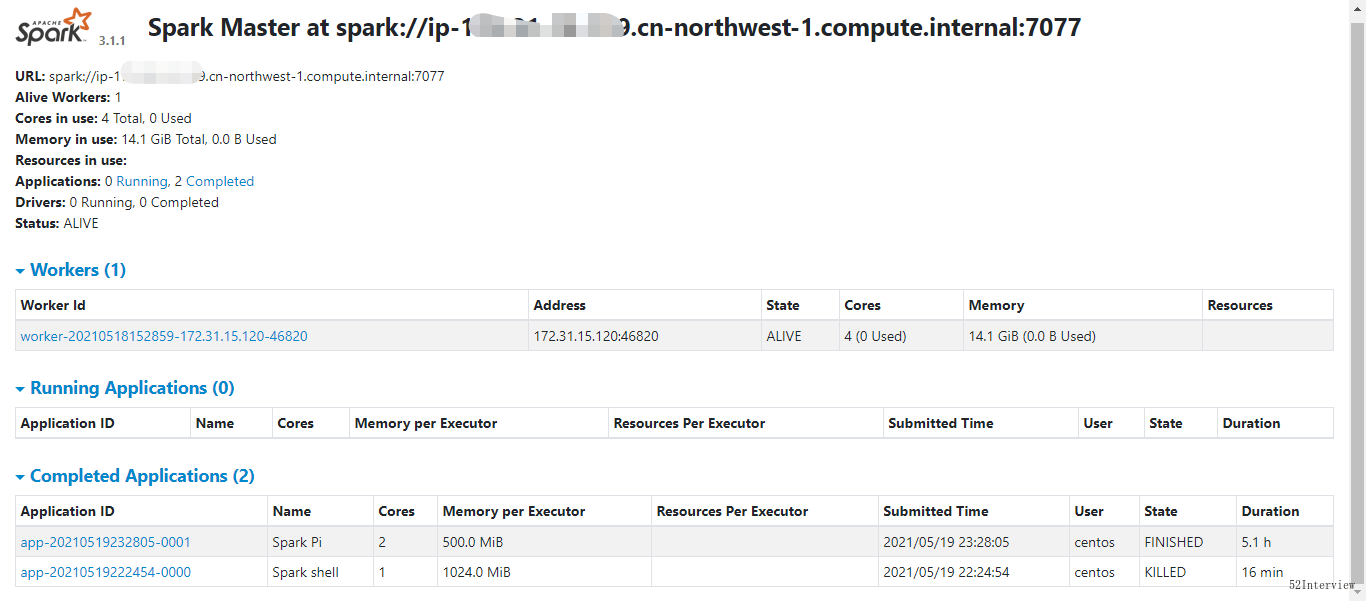
再来看看Spark视图
版权声明
作者:顶级码农
出处:
若标题中有“转载”字样,则本文版权归原作者所有。若无转载字样,本文版权归作者所有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文链接,否则保留追究法律责任的权利.
更多内容请关注智客工坊
Spark大数据处理框架入门(单机版)的更多相关文章
- Spark大数据处理技术
全球首部全面介绍Spark及Spark生态圈相关技术的技术书籍 俯览未来大局,不失精细剖析,呈现一个现代大数据框架的架构原理和实现细节 透彻讲解Spark原理和架构,以及部署模式.调度框架.存储管理及 ...
- Spark大数据处理 之 动手写WordCount
Spark是主流的大数据处理框架,具体有啥能耐,相信不需要多说.我们开门见山,直接动手写大数据界的HelloWorld:WordCount. 先上完整代码,看看咋样能入门. import org.ap ...
- 《Spark大数据处理:技术、应用与性能优化 》
基本信息 作者: 高彦杰 丛书名:大数据技术丛书 出版社:机械工业出版社 ISBN:9787111483861 上架时间:2014-11-5 出版日期:2014 年11月 开本:16开 页码:255 ...
- 《Spark大数据处理:技术、应用与性能优化》【PDF】 下载
内容简介 <Spark大数据处理:技术.应用与性能优化>根据最新技术版本,系统.全面.详细讲解Spark的各项功能使用.原理机制.技术细节.应用方法.性能优化,以及BDAS生态系统的相关技 ...
- 《Spark大数据处理:技术、应用与性能优化》【PDF】
内容简介 <Spark大数据处理:技术.应用与性能优化>根据最新技术版本,系统.全面.详细讲解Spark的各项功能使用.原理机制.技术细节.应用方法.性能优化,以及BDAS生态系统的相关技 ...
- 大数据处理框架之Strom:认识storm
Storm是分布式实时计算系统,用于数据的实时分析.持续计算,分布式RPC等. (备注:5种常见的大数据处理框架:· 仅批处理框架:Apache Hadoop:· 仅流处理框架:Apache Stor ...
- Spark大数据处理 之 从WordCount看Spark大数据处理的核心机制(2)
在上一篇文章中,我们讲了Spark大数据处理的可扩展性和负载均衡,今天要讲的是更为重点的容错处理,这涉及到Spark的应用场景和RDD的设计来源. Spark的应用场景 Spark主要针对两种场景: ...
- Spark大数据处理 之 RDD粗粒度转换的威力
在从WordCount看Spark大数据处理的核心机制(2)中我们看到Spark为了支持迭代和交互式数据挖掘,而明确提出了内存中可重用的数据集RDD.RDD的只读特性,再加上粗粒度转换操作形成的Lin ...
- 大数据处理框架之Strom: Storm----helloword
大数据处理框架之Strom: Storm----helloword Storm按照设计好的拓扑流程运转,所以写代码之前要先设计好拓扑图.这里写一个简单的拓扑: 第一步:创建一个拓扑类含有main方法的 ...
随机推荐
- ABP 适用性改造 - 精简 ABP CLI 生成的项目结构
Overview 不管是公司或者个人都会有不同的开发习惯,通过建立项目模板,既可以使开发人员聚焦于业务功能的开发,也可以在一定程度上统一不同开发人员之间的开发风格.在使用 ABP 框架的过程中,对于 ...
- salesforce零基础学习(一百零二)Limitation篇之 CPU Limit
本篇参考: https://help.salesforce.com/articleView?id=000339361&type=1&mode=1 https://developer.s ...
- pwn题命令行解题脚本
目录 脚本说明 脚本内容 使用 使用示例 参考与引用 脚本说明 这是专门为本地调试与远程答题准备的脚本,依靠命令行参数进行控制. 本脚本支持的功能有: 本地调试 开启tmux调试 设置gdb断点,支持 ...
- [hash]集合
集合 题目描述 给定两个集合A.B,集合内的任一元素x满足1 ≤ x ≤ 109,并且每个集合的元素个数不大于105.我们希望求出A.B之间的关系. 任 务 :给定两个集合的描述,判断它们满足下列关系 ...
- Mybatis-plus 上
Mybatis-plus 上 简介 1.什么是Mybatis-plus MyBatis-Plus(简称 MP)是一个 MyBatis的增强工具,在 MyBatis 的基础上只做增强不做改变,为简化开发 ...
- 201871010130-周学铭 实验三 结对项目—《D{0-1}KP 实例数据集算法实验平台》项目报告
项目 内容 课程班级博客链接 18卓越班 这个作业要求链接 实验三结对编程要求 我的课程学习目标 体验软件项目开发中的两人合作,练习结对编程(Pair programming).掌握Github协作开 ...
- 两种纯CSS方式实现hover图片pop-out弹出效果
实现原理 主要图形的组成元素由背景和前景图两个元素,以下示例代码中,背景元素使用伪元素 figure::before 表示, 前景元素使用 figure img 表示,当鼠标 hover 悬浮至 fi ...
- pandas(5):数学统计——描述性统计
Pandas 可以对 Series 与 DataFrame 进行快速的描述性统计,方便快速了解数据的集中趋势和分布差异.源Excel文件descriptive_statistics.xlsx: 一.描 ...
- OkHttp:NoClassDefFoundError
1 问题描述 使用OkHttp时报错: Caused by: java.lang.NoClassDefFoundError: kotlin/jvm/internal/Intrinsics at okh ...
- IDEA main 函数的快捷键
1.main()快捷键:psvm 当输入ps的时候编辑器就会有如下提示,可见比eclipse要很方便 2.System.out.println()快捷键:sout