
scrapy练习1
1.建立项目:
#建立名为tuto的项目

scrapy startproject tuto
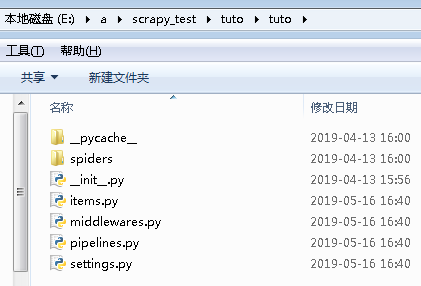
2.进入项目目录:
cd tuto
3.建立域名任务:
#minyan任务名;后面是任务对应的域名

scrapy genspider minyan quotes.toscrape.com

cmd全程记录:
E:\a\scrapy_test>scrapy startproject tuto

New Scrapy project 'tuto', using template directory 'c:\python\python37\lib\site

-packages\scrapy\templates\project', created in:

    E:\a\scrapy_test\tuto

You can start your first spider with:

    cd tuto

    scrapy genspider example example.com

E:\a\scrapy_test>cd tuto

E:\a\scrapy_test\tuto>scrapy genspider minyan quotes.toscrape.com

Created spider 'minyan' using template 'basic' in module:

  tuto.spiders.minyan

E:\a\scrapy_test\tuto>
4.pycharm打开项目,建立用于调试的文件:main.py

用到的函数解析:https://www.cnblogs.com/chenxi188/p/10876690.html
main.py:
# -*- coding: utf-8 -*-

__author__='pasaulis'

import sys,os

from scrapy.cmdline import execute

#获取到当前目录,添加到环境变量,方便运行cmd不必再去找目录

#.append()添加到环境变量;.dirname()输出不含文件名的路径;.abspath(__file__)得到当前文件的绝对路径

sys.path.append(os.path.dirname(os.path.abspath(__file__)))

#调用命令运行爬虫scrapy crawl 爬虫名minyan.py中(name的值)

execute(["scrapy","crawl","minyan"])
查看页面,确定需要解析哪些数据,在items.py里写出:
import scrapy

class TutoItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    text=scrapy.Field()

    author=scrapy.Field()

    tags=scrapy.Field()

    #pass
minyan.py:
# -*- coding: utf-8 -*-

import scrapy

from tuto.items import TutoItem #从tuto文件夹下的items.py导入其中的类TutoItem用于创建列表

class MinyanSpider(scrapy.Spider):

    name = 'minyan'

    allowed_domains = ['quotes.toscrape.com']

    start_urls = ['http://quotes.toscrape.com/']

    def parse(self, response):

        quotes=response.css('.quote')

        for quote in quotes:

            item=TutoItem()

            item['text']=quote.css('.text::text').extract_first()

            item['author']=quote.css('.author::text').extract_first()

            item['tags']=quote.css('.keywords::attr(content)').extract_first()

            yield item

        #下一页

        next=response.css('.next > a::attr(href)').extract_first()

        url=response.urljoin(next) #补全网址

        yield scrapy.Request(url=url,callback=self.parse) #请求下一页,并回调自身方法
settings.py把此条改为false
# Obey robots.txt rules

ROBOTSTXT_OBEY = False
运行代码:
在pycharm最下terminal里: scrapy crawl mingyan
或main.py里运行
scrapy练习1的更多相关文章
- Scrapy框架爬虫初探——中关村在线手机参数数据爬取
关于Scrapy如何安装部署的文章已经相当多了,但是网上实战的例子还不是很多,近来正好在学习该爬虫框架,就简单写了个Spider Demo来实践.作为硬件数码控,我选择了经常光顾的中关村在线的手机页面 ...
- scrapy爬虫docker部署
spider_docker 接我上篇博客,为爬虫引用创建container,包括的模块:scrapy, mongo, celery, rabbitmq,连接https://github.com/Liu ...
- scrapy 知乎用户信息爬虫
zhihu_spider 此项目的功能是爬取知乎用户信息以及人际拓扑关系,爬虫框架使用scrapy,数据存储使用mongo,下载这些数据感觉也没什么用,就当为大家学习scrapy提供一个例子吧.代码地 ...
- ubuntu 下安装scrapy
1.把Scrapy签名的GPG密钥添加到APT的钥匙环中: sudo apt-key adv --keyserver hkp://keyserver.ubuntu.com:80 --recv 6272 ...
- 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
上周学习了BeautifulSoup的基础知识并用它完成了一个网络爬虫( 使用Beautiful Soup编写一个爬虫 系列随笔汇总 ), BeautifulSoup是一个非常流行的Python网 ...
- Scrapy:为spider指定pipeline
当一个Scrapy项目中有多个spider去爬取多个网站时,往往需要多个pipeline,这时就需要为每个spider指定其对应的pipeline. [通过程序来运行spider],可以通过修改配置s ...
- scrapy cookies:将cookies保存到文件以及从文件加载cookies
我在使用scrapy模拟登录新浪微博时,想将登录成功后的cookies保存到本地,下次加载它实现直接登录,省去中间一系列的请求和POST等.关于如何从本次请求中获取并在下次请求中附带上cookies的 ...
- Scrapy开发指南
一.Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. Scrapy基于事件驱动网络框架 Twis ...
- 利用scrapy和MongoDB来开发一个爬虫
今天我们利用scrapy框架来抓取Stack Overflow里面最新的问题(),并且将这些问题保存到MongoDb当中,直接提供给客户进行查询. 安装 在进行今天的任务之前我们需要安装二个框架,分别 ...
- python3 安装scrapy
twisted(网络异步框架) wget https://pypi.python.org/packages/dc/c0/a0114a6d7fa211c0904b0de931e8cafb5210ad82 ...
随机推荐
- 项目启动报错:Communications link failure
2017-12-29 10:43:19,776 ERROR [com.alibaba.druid.pool.DruidDataSource] - <init datasource error, ...
- 吴裕雄--天生自然java开发常用类库学习笔记:ListIterator接口
import java.util.ArrayList ; import java.util.List ; import java.util.ListIterator ; public class Li ...
- Java 日期与时间
章节 Java 基础 Java 简介 Java 环境搭建 Java 基本语法 Java 注释 Java 变量 Java 数据类型 Java 字符串 Java 类型转换 Java 运算符 Java 字符 ...
- 每天一点点之 uni-app 框架开发 - 页面滚动到指定位置
项目需求:在页面中,不管位于何处,点击评论按钮页面滚动到对应到位置 实现思路如下: uni.createSelectorQuery().select(".comment").bou ...
- WTL之手动编写框架窗口
新版博客已经搭建好了,有问题请访问 htt://www.crazydebug.com 本人是一个实践主义者,不罗嗦上一篇工程搭建好以后,这一篇就开始写代码,写之前再说几句,如果你熟悉MFC分析过MFC ...
- 如何通过 Python 和 OpenCV 实现目标数量监控?
今天我们将利用python+OpenCV实现对视频中物体数量的监控,达到视频监控的效果,比如洗煤厂的监控水龙头的水柱颜色,当水柱为黑色的超过了一半,那么将说明过滤网发生了故障.当然不仅如此,我们看的是 ...
- HDU 4952 Number Transformation 多校8 机智数学
哎.这个题想了好久,状态不对啊...一个大家都出的题..当时想到肯定是可以有什么规律来暴力,不用算到10的10次方 对于某个k,x.从1到k循环,每次求一个新的x,这个x要大于等于原x,并且要是i的倍 ...
- OleDbCommand 的用法
OleDbCommand 的用法 OleDbConnection con=new OleDbConnection("Provider=Microsoft.Jet.OLEDB.4.0; dat ...
- opencv人脸检测
找了一张自己喜欢的<超人前传>剧照 其中的xml分类器需要到https://github.com/opencv/opencv/tree/master/data/haarcascades去下 ...
- ACM-DFS Template
自己写的DFSTemplate: // DFS_Template.cpp : 定义控制台应用程序的入口点. // #include "stdafx.h" //DFS的思想是:一直向 ...