
从0开始学爬虫12之使用requests库基本认证
从0开始学爬虫12之使用requests库基本认证
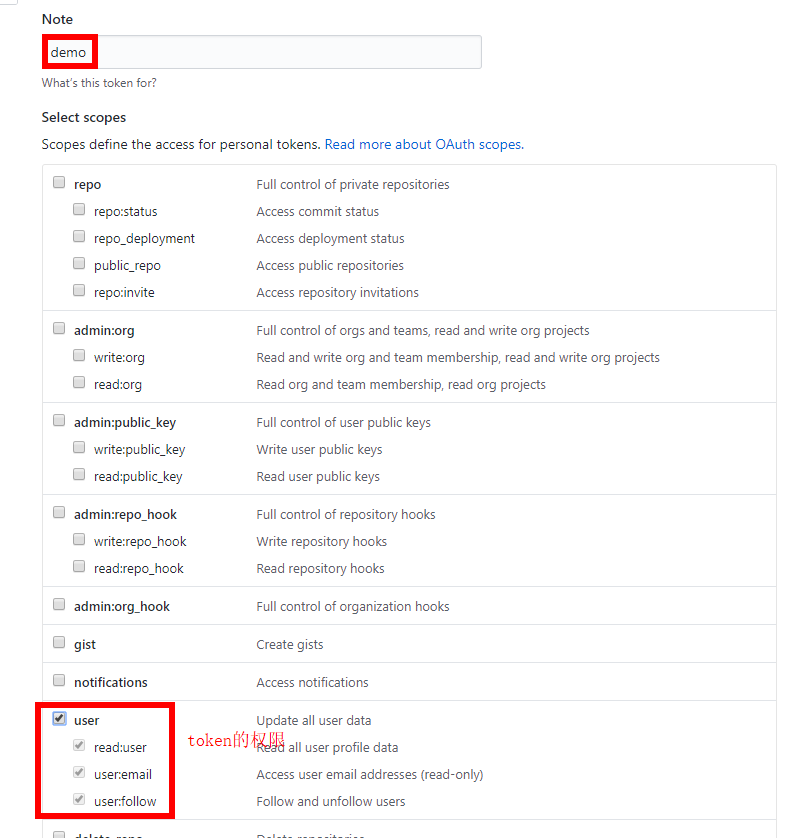
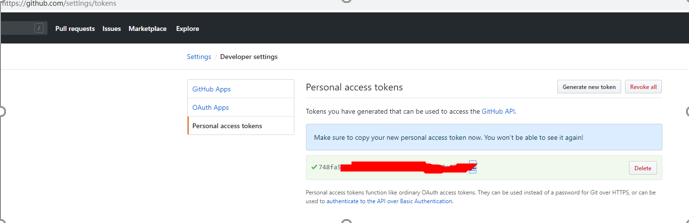
此处我们使用github的token进行简单测试验证

# coding=utf-8

import requests

BASE_URL = "https://api.github.com"

def construct_url(endpoint):

    return '/'.join([BASE_URL, endpoint])

def basic_auth():

    '''

    基本认证

    :return:

    '''

    response = requests.get(construct_url('user'), auth=('reblue520','reblue520'))

    print response.text

    print response.status_code

    print response.request.headers

def basic_oauth():

    # 添加github中添加的token认证

    headers = {'Authorization': 'token 748fa57d10'}

    # user/emails

    response = requests.get(construct_url('user/emails'), headers=headers)

    print response.request.headers

    print response.text

    print response.status_code

from requests.auth import AuthBase

class GithubAuth(AuthBase):

    # 自定义auth,对aut进行优化

    def __init__(self, token):

        self.token = token

    def __call__(self, r):

        # requests 加 headers信息

        r.headers['Authorization'] = ' '.join(['token', self.token])

        return r

def oath_advanced():

    auth = GithubAuth('748fa57d10')

    response = requests.get(construct_url('user/emails'), auth=auth)

    print response.text

if __name__ == '__main__':

    # basic_auth()

    # basic_oauth()

    oath_advanced()
从0开始学爬虫12之使用requests库基本认证的更多相关文章
- 从0开始学爬虫11之使用requests库下载图片
从0开始学爬虫11之使用requests库下载图片 # coding=utf-8 import requests def download_imgage(): ''' demo: 下载图片 ''' h ...
- 从0开始学爬虫9之requests库的学习之环境搭建
从0开始学爬虫9之requests库的学习之环境搭建 Requests库的环境搭建 环境:python2.7.9版本 参考文档:http://2.python-requests.org/zh_CN/l ...
- 从0开始学爬虫8使用requests/pymysql和beautifulsoup4爬取维基百科词条链接并存入数据库
从0开始学爬虫8使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 Python使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 参考 ...
- 从0开始学爬虫4之requests基础知识
从0开始学爬虫4之requests基础知识 安装requestspip install requests get请求:可以用浏览器直接访问请求可以携带参数,但是又长度限制请求参数直接放在URL后面 P ...
- 从0开始学爬虫3之xpath的介绍和使用
从0开始学爬虫3之xpath的介绍和使用 Xpath:一种HTML和XML的查询语言,它能在XML和HTML的树状结构中寻找节点 安装xpath: pip install lxml HTML 超文本标 ...
- 从0开始学爬虫2之json的介绍和使用
从0开始学爬虫2之json的介绍和使用 Json 一种轻量级的数据交换格式,通用,跨平台 键值对的集合,值的有序列表 类似于python中的dict Json中的键值如果是字符串一定要用双引号 jso ...
- Python爬虫利器一之Requests库的用法
前言 之前我们用了 urllib 库,这个作为入门的工具还是不错的,对了解一些爬虫的基本理念,掌握爬虫爬取的流程有所帮助.入门之后,我们就需要学习一些更加高级的内容和工具来方便我们的爬取.那么这一节来 ...
- (转)Python爬虫利器一之Requests库的用法
官方文档 以下内容大多来自于官方文档,本文进行了一些修改和总结.要了解更多可以参考 官方文档 安装 利用 pip 安装 $ pip install requests 或者利用 easy_install ...
- 网络爬虫必备知识之requests库
就库的范围,个人认为网络爬虫必备库知识包括urllib.requests.re.BeautifulSoup.concurrent.futures,接下来将结对requests库的使用方法进行总结 1. ...
随机推荐
- 使用BERT模型生成句子序列向量
之前我写过一篇文章,利用bert来生成token级向量(对于中文语料来说就是字级别向量),参考我的文章:<使用BERT模型生成token级向量>.但是这样做有一个致命的缺点就是字符序列长度 ...
- Java精通并发-轻量级锁与重量级锁的变化深入详解
在上一次https://www.cnblogs.com/webor2006/p/11446129.html的理论的最后谈到了锁的演化,如下: 下面具体来阐述一下: 偏向锁:它是针对一个线程来说, 它的 ...
- idea的基础设置
1. 在idea.exe.vmoptions文件里,如图进行修改即可,, 优化的原理就是调用更多的运行内存来加载他,所以4G的话本身会不够,就会造成其他应用很卡. 2. 下面是进行一些基本的配置 ...
- 大数据之路week07--day06 (Sqoop 的使用)
Sqoop的使用一(将数据库中的表数据上传到HDFS) 首先我们先准备数据 1.没有主键的数据(下面介绍有主键和没有主键的使用区别) -- MySQL dump 10.13 Distrib 5.1.7 ...
- 2019ICPC南京网络赛B super_log——扩展欧拉定理
题目 设函数 $$log_a*(x) = \begin{cases}-1, & \text{ if } x < 1 \\ 1+log_a*(log_ax) & \text{ if ...
- 集合(Collection)类
集合(Collection)类是专门用于数据存储和检索的类.这些类提供了对栈(stack).队列(queue).列表(list)和哈希表(hash table)的支持.大多数集合类实现了相同的接口. ...
- Sublime 原版安装
sublime text3 安装方法 ① 官网下载安装 https://www.sublimetext.com/3 ② 更改hosts文件 具体方法如下: windows系统的hosts文件在C:\W ...
- js原型和原型链的问题
<script> //js原型和原型链的概念 functionperson(name){ this.name=name; } person.prototype.age=18; person ...
- Phoenix 简单介绍
转载自:https://blog.csdn.net/carolzhang8406/article/details/79455684 1. Phoenix定义 Phoenix最早是saleforce的一 ...
- BZOJ 3328: PYXFIB 单位根反演+矩阵乘法+二项式定理
如果写过 LJJ 学二项式那道题的话这道题就不难了. #include <bits/stdc++.h> #define ll long long #define setIO(s) freo ...