
从0开始学爬虫11之使用requests库下载图片
从0开始学爬虫11之使用requests库下载图片
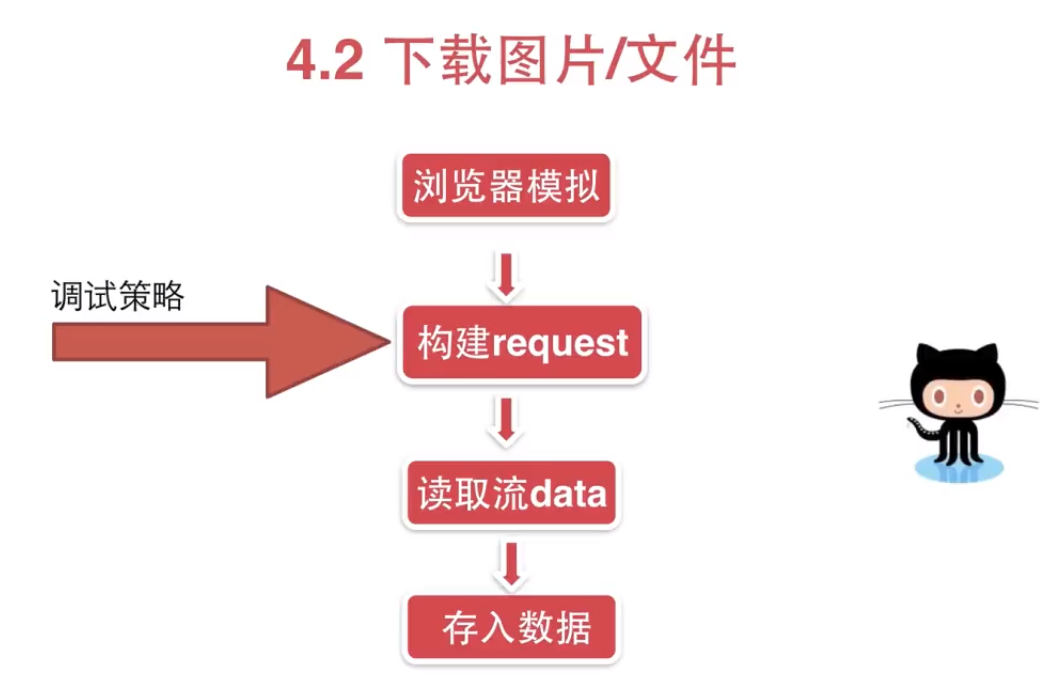
# coding=utf-8

import requests

def download_imgage():

    '''

    demo: 下载图片

    '''

    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36"}

    url = "https://ss0.bdstatic.com/94oJfD_bAAcT8t7mm9GUKT-xh_/timg?image&quality=100&size=b4000_4000&sec=1563595148&di=1239a9121c930e1ab892faa7cd0b8f8a&src=http://m.360buyimg.com/pop/jfs/t23434/230/1763906670/10667/55866a07/5b697898N78cd1466.jpg"

    response = requests.get(url,headers=headers, stream=True)

    with open('demo.jpg', 'wb') as fd:

        for chunk in response.iter_content(128):

            fd.write(chunk)

    print response.content

def download_image_improved():

    # 伪造headers信息

    headers = {

        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36"}

    # 限定url

    url = "https://ss0.bdstatic.com/94oJfD_bAAcT8t7mm9GUKT-xh_/timg?image&quality=100&size=b4000_4000&sec=1563595148&di=1239a9121c930e1ab892faa7cd0b8f8a&src=http://m.360buyimg.com/pop/jfs/t23434/230/1763906670/10667/55866a07/5b697898N78cd1466.jpg"

    response = requests.get(url, headers=headers, stream=True)

    # contextlib 管理上下文信息

    from contextlib import closing

    # 可以关闭文件流

    with closing(requests.get(url, headers=headers, stream=True)) as response:

        # 打开文件

        with open('demo1.jpg', 'wb') as fd:

            # 每128字节写入一次

            for chunk in response.iter_content(128):

                fd.write(chunk)

if __name__ == '__main__':

    # download_imgage()

    download_image_improved()
从0开始学爬虫11之使用requests库下载图片的更多相关文章
- 从0开始学爬虫12之使用requests库基本认证
从0开始学爬虫12之使用requests库基本认证 此处我们使用github的token进行简单测试验证 # coding=utf-8 import requests BASE_URL = " ...
- 从0开始学爬虫9之requests库的学习之环境搭建
从0开始学爬虫9之requests库的学习之环境搭建 Requests库的环境搭建 环境:python2.7.9版本 参考文档:http://2.python-requests.org/zh_CN/l ...
- 从0开始学爬虫8使用requests/pymysql和beautifulsoup4爬取维基百科词条链接并存入数据库
从0开始学爬虫8使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 Python使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 参考 ...
- 从0开始学爬虫4之requests基础知识
从0开始学爬虫4之requests基础知识 安装requestspip install requests get请求:可以用浏览器直接访问请求可以携带参数,但是又长度限制请求参数直接放在URL后面 P ...
- 从0开始学爬虫3之xpath的介绍和使用
从0开始学爬虫3之xpath的介绍和使用 Xpath:一种HTML和XML的查询语言,它能在XML和HTML的树状结构中寻找节点 安装xpath: pip install lxml HTML 超文本标 ...
- 从0开始学爬虫2之json的介绍和使用
从0开始学爬虫2之json的介绍和使用 Json 一种轻量级的数据交换格式,通用,跨平台 键值对的集合,值的有序列表 类似于python中的dict Json中的键值如果是字符串一定要用双引号 jso ...
- Python爬虫利器一之Requests库的用法
前言 之前我们用了 urllib 库,这个作为入门的工具还是不错的,对了解一些爬虫的基本理念,掌握爬虫爬取的流程有所帮助.入门之后,我们就需要学习一些更加高级的内容和工具来方便我们的爬取.那么这一节来 ...
- (转)Python爬虫利器一之Requests库的用法
官方文档 以下内容大多来自于官方文档,本文进行了一些修改和总结.要了解更多可以参考 官方文档 安装 利用 pip 安装 $ pip install requests 或者利用 easy_install ...
- 第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签
第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签 标签选择器对象 HtmlXPathSelector()创建标签选择器对象,参数接收response回调的html对象需 ...
随机推荐
- BZOJ4659: Lcm
Description 给出A,B,考虑所有满足l<=a<=A,l<=b<=B,且不存在n>1使得n^2同时整除a和b的有序数 对(a,b),求其lcm(a,b)之和.答 ...
- 《少年先疯队》第九次团队作业:Beta冲刺与团队项目验收
博文简要信息表: 项目 内容 软件工程 https://www.cnblogs.com/nwnu-daizh/ 本次实验链接地址 https://www.cnblogs.com/nwnu-daizh/ ...
- APP弱网测试工具(QNET)
QNET介绍官网链接:https://wetest.qq.com/product/qnet 目前在测试移动设备上进行弱网络专项测试的方案主要有两种: 通过Android设备连接到PC上进行弱网络测试, ...
- Mybatis 使用PageHelper封装通用Dao分页方法
参考: PageHelper官网:https://pagehelper.github.io/docs/howtouse/#3-%E5%A6%82%E4%BD%95%E5%9C%A8%E4%BB%A3% ...
- Visual Studio 2017 许可证已过期解决方案
1.卸载并重安VS2017 2.安装后打开VS2017,点击帮助=>注册产品,输入序列号NJVYC-BMHX2-G77MM-4XJMR-6Q8QF(企业版), KBJFW-NXHK6-W4WJM ...
- 【CSP-S 2019】【洛谷P5666】树的重心【主席树】【树状数组】【dfs】
题目: 题目链接:https://www.luogu.com.cn/problem/P5666 小简单正在学习离散数学,今天的内容是图论基础,在课上他做了如下两条笔记: 一个大小为 \(n\) 的树由 ...
- MySQL读写分离项目配置
一.项目信息 1.拓扑 二.环境规划 1.主机信息 2.软件信息 3.MySQL中间件 三.配置
- Linux sudo权限绕过(CVE-2019-14287)
2019年10月14日,Sudo官方发布了Sudo 1.8.28版本,其中包含sudo root权限绕过漏洞的补丁修复. 此漏洞编号是CVE-2019-14287,当sudo配置为允许用户以任意方式运 ...
- admin站点管理
admin中的显示 class Saltstack_GroupAdmin(admin.ModelAdmin): list_display = ['group_name','salt_minion_id ...
- 力扣50题 Pow(x,n)
本题是力扣网第50题. 实现 pow(x, n) ,即计算 x 的 n 次幂函数. 采用递归和非递归思路python实现. class Solution: #递归思路 def myPow_recurs ...