
用pytorch进行CIFAR-10数据集分类
CIFAR-10.(Canadian Institute for Advanced Research)是由 Alex Krizhevsky、Vinod Nair 与 Geoffrey Hinton 收集的一个用于图像识别的数据集,60000个32*32的彩色图像,50000个training data,10000个 test data 有10类,飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车,每类6000张图。与MNIST相比,色彩、颜色噪点较多,同一类物体大小不一、角度不同、颜色不同。
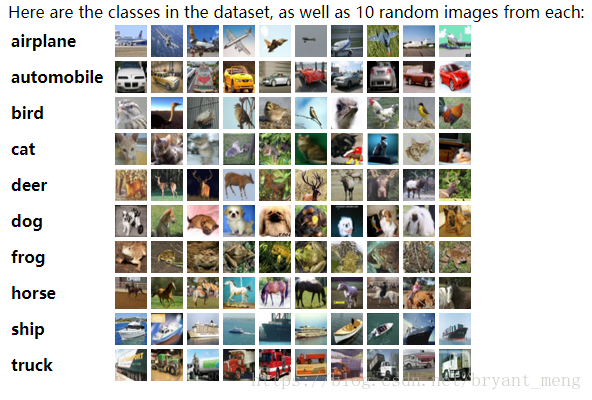
先要对该数据集进行分类
步骤如下:
1.使用torchvision加载并预处理CIFAR-10数据集、
2.定义网络
3.定义损失函数和优化器
4.训练网络并更新网络参数
5.测试网络
 import torchvision as tv            #里面含有许多数据集

 import torch

 import torchvision.transforms as transforms    #实现图片变换处理的包

 from torchvision.transforms import ToPILImage

 #使用torchvision加载并预处理CIFAR10数据集

 show = ToPILImage()         #可以把Tensor转成Image,方便进行可视化

 transform = transforms.Compose([transforms.ToTensor(),transforms.Normalize(mean = (0.5,0.5,0.5),std = (0.5,0.5,0.5))])#把数据变为tensor并且归一化range [, ] -> [0.0,1.0]

 trainset = tv.datasets.CIFAR10(root='data1/',train = True,download=True,transform=transform)

 trainloader = torch.utils.data.DataLoader(trainset,batch_size=,shuffle=True,num_workers=)

 testset = tv.datasets.CIFAR10('data1/',train=False,download=True,transform=transform)

 testloader = torch.utils.data.DataLoader(testset,batch_size=,shuffle=True,num_workers=)

 classes = ('plane','car','bird','cat','deer','dog','frog','horse','ship','truck')

 (data,label) = trainset[]

 print(classes[label])#输出ship

 show((data+)/).resize((,))

 dataiter = iter(trainloader)

 images, labels = dataiter.next()

 print(' '.join('%11s'%classes[labels[j]] for j in range()))

 show(tv.utils.make_grid((images+)/)).resize((,))#make_grid的作用是将若干幅图像拼成一幅图像

 #定义网络

 import torch.nn as nn

 import torch.nn.functional as F

 class Net(nn.Module):

     def __init__(self):

         super(Net,self).__init__()

         self.conv1 = nn.Conv2d(,,)

         self.conv2 = nn.Conv2d(,,)

         self.fc1 = nn.Linear(**,)

         self.fc2 = nn.Linear(,)

         self.fc3 = nn.Linear(,)

     def forward(self,x):

         x = F.max_pool2d(F.relu(self.conv1(x)),(,))

         x = F.max_pool2d(F.relu(self.conv2(x)),)

         x = x.view(x.size()[],-)

         x = F.relu(self.fc1(x))

         x = F.relu(self.fc2(x))

         x = self.fc3(x)

         return  x

 net = Net()

 print(net)

 #定义损失函数和优化器

 from torch import optim

 criterion  = nn.CrossEntropyLoss()#定义交叉熵损失函数

 optimizer = optim.SGD(net.parameters(),lr = 0.001,momentum=0.9)

 #训练网络

 from torch.autograd  import Variable

 for epoch in range():

     running_loss = 0.0

     for i, data in enumerate(trainloader, ):#enumerate将其组成一个索引序列,利用它可以同时获得索引和值,enumerate还可以接收第二个参数,用于指定索引起始值

         inputs, labels = data

         inputs, labels = Variable(inputs), Variable(labels)

         optimizer.zero_grad()

         outputs = net(inputs)

         loss  = criterion(outputs, labels)

         loss.backward()

         optimizer.step()

         running_loss += loss.item()

         if i %  ==:

             print('[%d, %5d] loss: %.3f'%(epoch+,i+,running_loss/))

             running_loss = 0.0

 print("----------finished training---------")

 dataiter = iter(testloader)

 images, labels = dataiter.next()

 print('实际的label: ',' '.join('%08s'%classes[labels[j]] for j in range()))

 show(tv.utils.make_grid(images/ - 0.5)).resize((,))#?????

 outputs = net(Variable(images))

 _, predicted = torch.max(outputs.data,)#返回最大值和其索引

 print('预测结果:',' '.join('%5s'%classes[predicted[j]] for j in range()))

 correct =

 total =

 for data in testloader:

     images, labels = data

     outputs = net(Variable(images))

     _, predicted = torch.max(outputs.data, )

     total +=labels.size()

     correct +=(predicted == labels).sum()

 print('10000张测试集中的准确率为: %d %%'%(*correct/total))

 if torch.cuda.is_available():

     net.cuda()

     images = images.cuda()

     labels = labels.cuda()

     output = net(Variable(images))

     loss = criterion(output, Variable(labels))
学习率太大会很难逼近最优值,所以要注意在数据集小的情况下学习率尽量小一些,epoch尽量大一些。
这个例子是陈云的深度学习pytorch框架书上的一个demo,运行该代码需要注意的是数据集的下载问题,因为运行程序很可能数据集下载很慢或者直接下载失败,因此推荐使用迅雷根据指定网址直接下载,半分钟就可以下载好。
用pytorch进行CIFAR-10数据集分类的更多相关文章
- 【翻译】TensorFlow卷积神经网络识别CIFAR 10Convolutional Neural Network (CNN)| CIFAR 10 TensorFlow
原网址:https://data-flair.training/blogs/cnn-tensorflow-cifar-10/ by DataFlair Team · Published May 21, ...
- 单向LSTM笔记, LSTM做minist数据集分类
单向LSTM笔记, LSTM做minist数据集分类 先介绍下torch.nn.LSTM()这个API 1.input_size: 每一个时步(time_step)输入到lstm单元的维度.(实际输入 ...
- PyTorch深度学习实践——多分类问题
多分类问题 目录 多分类问题 Softmax 在Minist数据集上实现多分类问题 作业 课程来源:PyTorch深度学习实践--河北工业大学 <PyTorch深度学习实践>完结合集_哔哩 ...
- 机器学习与Tensorflow(3)—— 机器学习及MNIST数据集分类优化
一.二次代价函数 1. 形式: 其中,C为代价函数,X表示样本,Y表示实际值,a表示输出值,n为样本总数 2. 利用梯度下降法调整权值参数大小,推导过程如下图所示: 根据结果可得,权重w和偏置b的梯度 ...
- Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes
Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = ...
- Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression
Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression 一. 逻辑回归 逻辑回归(Logistic Regression)是用于处理因变量为分类变量的回归问题, ...
- Python实现鸢尾花数据集分类问题——基于skearn的SVM
Python实现鸢尾花数据集分类问题——基于skearn的SVM 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = 'Xiaoli ...
- 3.keras-简单实现Mnist数据集分类
keras-简单实现Mnist数据集分类 1.载入数据以及预处理 import numpy as np from keras.datasets import mnist from keras.util ...
- 6.keras-基于CNN网络的Mnist数据集分类
keras-基于CNN网络的Mnist数据集分类 1.数据的载入和预处理 import numpy as np from keras.datasets import mnist from keras. ...
- pytorch构建自己的数据集
现在需要在json文件里面读取图片的URL和label,这里面可能会出现某些URL地址无效的情况. python读取json文件 此处只需要将json文件里面的内容读取出来就可以了 with open ...
随机推荐
- 【leetcode】967. Numbers With Same Consecutive Differences
题目如下: Return all non-negative integers of length N such that the absolute difference between every t ...
- foreach循环的跳出
由于foreach循环中不像for循环可以直接通过return或break来终止当前循环,不过这里可以借助try...catch...来完成var arr = [1,2,3,4,5,6,7,8,9,1 ...
- PHP FILTER_VALIDATE_FLOAT 过滤器
定义和用法 FILTER_VALIDATE_FLOAT 过滤器把值作为浮点数来验证. Name: "float" ID-number: 259 实例 <?php $var=1 ...
- js 获取数组中的最大值和最小值
var arr = [3,12,23,18,25,33,22,30,1] 方案一: 思想 首先对数组进行排序(小 >大),第一项为最小值,最后一项为最大值 var min; var max; a ...
- 互斥锁Demo
#include <stdio.h> #include <pthread.h> pthread_t work1Id; pthread_t work2Id; ; ; pthrea ...
- CSS:CSS 伪类(Pseudo-classes)
ylbtech-CSS:CSS 伪类(Pseudo-classes) 1.返回顶部 1. CSS 伪类(Pseudo-classes) CSS伪类是用来添加一些选择器的特殊效果. 语法 伪类的语法: ...
- Idea 导入项目不能运行
1.项目结构里面配置sdk,配置output输出目录 2.配置语言等级 配置src源文件目录 配置目录里面添加application,添加main class
- Dubbo入门到精通学习笔记(四):持续集成管理平台之Maven私有库和本地库的安装与配置
文章目录 介绍 Maven私有库和本地库的安装与配置 Nexus安装 Nexus 配置(登录后) 介绍 如果构建的Maven项目本地仓库没有对应的依赖包,那么就会去Nexus私服去下载, 那么如果Ne ...
- 剑指offer第二版面试题1:数组中重复的数字(JAVA版)
题目:在一个长度为n的数组里的所有数字都在0到n-1的范围内.数组中某些数字是重复的,但不知道有几个数字重复了,也不知道每个数字重复的次数.请找出数组中任意一个重复的数字.例如如果输入长度为7的数组{ ...
- Warshall算法和Floyd算法
不用说这两位都是冷门算法……毕竟O(n^3)的时间复杂度算法在算法竞赛里基本算是被淘汰了……而且也没有在这个算法上继续衍生出其他的算法… 有兴趣的话:click here.. 话说学离散的时候曾经有个 ...