
【Python】【爬虫】【爬狼】003_获取搜索结果的页数
# 获取搜索内容的页数
需要的包
import urllib.request  # 获取网页源码

import re  # 正则表达式,进行文字匹配

from bs4 import BeautifulSoup  # 解析网页
解析网页
第一步,解析网页为网页源码(【Python】【爬虫系列】【爬狼】002_自定义获取网页源码的函数 - 萌狼蓝天 - 博客园 (cnblogs.com/mllt))
    # 获取网页源码

    response_html = xrilang_UrlToDocument(Url)

    # xrilang_UrlToDocument是我自定义函数,如果你没写这个函数,直接使用,会报错的。

    # 如果你想了解这个函数的具体内容,请看【爬狼系列】笔记第002篇
获取搜索内容的页数
分析网页
切换页数,观察地址栏变化。
根据观察第二页、第三页链接如下
# 第二页

https://www.yhdmp.cc/s_all?kw=love&pagesize=24&pageindex=1

# 第三页

https://www.yhdmp.cc/s_all?kw=love&pagesize=24&pageindex=2
由此可以推测出,第一页的地址为
https://www.yhdmp.cc/s_all?kw=love&pagesize=24&pageindex=0
s_all:Search All 搜索全部
kw:Key Word
pagesize:页面大小(一页有多少个视频)
pageindex:页面索引(索引从0开始,代表页数。索引0是第一页,索引1是第二页,以此类推)
获取视频数量
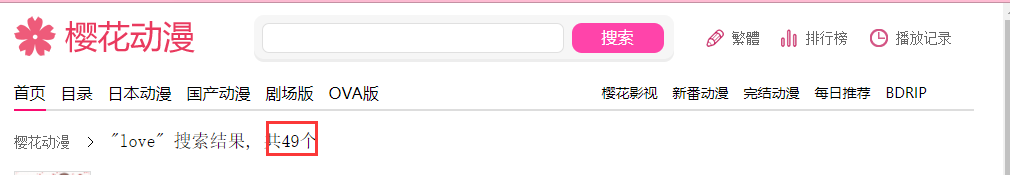
此处会显示视频数量,我们只需取出这个“数字”就可以了。
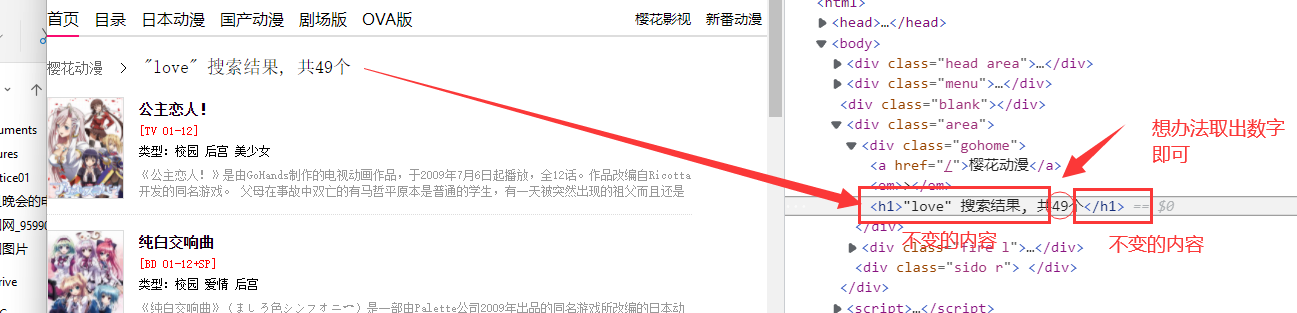
方法1
	# 1.获取所搜结果视频数量

    reStr1 = r'''搜索结果, 共(.*?)个'''  # 正则规则

    # temp = re.findall(reStr1, response_html) # 在 response_html 中查找符合上述正则规则(reStr1)的内容

    # 运行结果为:['49']

    mvNumber = re.findall(reStr1, response_html)[0]  # 取出列表的第一项(索引为0) 设置变量mvNumber(搜索得到的视频数量)

    # 运行结果为:49
方法2(推荐使用)
# 1.获取所搜结果视频数量

    reStr1 = re.compile(r'''搜索结果, 共(.*?)个''')  # 正则规则

    # temp = re.findall(reStr1, response_html) # 在 response_html 中查找符合上述正则规则(reStr1)的内容

    # 运行结果为:['49']

    mvNumber = re.findall(reStr1, response_html)[0]  # 取出列表的第一项(索引为0) 设置变量mvNumber(搜索得到的视频数量)

    # 运行结果为:49
通过视频数量获取页数
通过分析,我们知道,一页有24个视频,视频总数在上面已经求出来了,那么会有多少页呢,这就是一个小学的题了。
视频总数/每页展示视频数=总页数
即:视频总数/24=总页数
注意,如果有余数,则直接+1,结果为整数
 	# 通过视频数量判断有多少页

    # pageNumber = int(mvNumber) / 24

    # 运行结果为:2.0416666666666665

    # 求出页数

    if (int(mvNumber) % 24) == 0:

        pageNumber = int(mvNumber) / 24

    else:

        pageNumber = int(int(mvNumber) / 24) + 1

    # 最终得到页数结果 pageNumber

    # mvNumber是视频总数
将此功能编写为函数
为了方便求页数,我们需要将次功能编写为函数方便我们使用
def xrilag_SearchAll(keyword):

    """

    '获取搜索内容的总页数'

    :param keyword:搜索的关键字

    :return:int 搜索结果的总页数

    """

    # 基础链接

    baseUrl = "https://www.yhdmp.cc/s_all?ex=1&kw="

    Url = baseUrl + keyword

    # 获取网页源码

    response_html = xrilang_UrlToDocument(Url)

    # 1.获取所搜结果视频数量

    reStr1 = re.compile(r'''搜索结果, 共(.*?)个''')  # 正则规则

    # temp = re.findall(reStr1, response_html) # 在 response_html 中查找符合上述正则规则(reStr1)的内容

    # 运行结果为:['49']

    mvNumber = re.findall(reStr1, response_html)[0]  # 取出列表的第一项(索引为0) 设置变量mvNumber(搜索得到的视频数量)

    # 运行结果为:49

    # 通过视频数量判断有多少页

    # pageNumber = int(mvNumber) / 24

    # 运行结果为:2.0416666666666665

    # 求出页数

    if (int(mvNumber) % 24) == 0:

        pageNumber = int(mvNumber) / 24

    else:

        pageNumber = int(int(mvNumber) / 24) + 1

    # 最终得到页数结果 pageNumber

    return pageNumber
学习本文,最重要的是学习思维和处理方式
【Python】【爬虫】【爬狼】003_获取搜索结果的页数的更多相关文章
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- 一个简单的python爬虫,爬取知乎
一个简单的python爬虫,爬取知乎 主要实现 爬取一个收藏夹 里 所有问题答案下的 图片 文字信息暂未收录,可自行实现,比图片更简单 具体代码里有详细注释,请自行阅读 项目源码: # -*- cod ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- 使用python爬虫爬取链家潍坊市二手房项目
使用python爬虫爬取链家潍坊市二手房项目 需求分析 需要将潍坊市各县市区页面所展示的二手房信息按要求爬取下来,同时保存到本地. 流程设计 明确目标网站URL( https://wf.lianjia ...
- python爬虫爬取内容中,-xa0,-u3000的含义
python爬虫爬取内容中,-xa0,-u3000的含义 - CSDN博客 https://blog.csdn.net/aiwuzhi12/article/details/54866310
随机推荐
- 怎么根据token的有⽆去控制路由的跳转?进度条跳转 - 白名单是否有token - 单独封装文件permission .js
vue这边的路由⾃带了路由前置守卫,我们可以在前置守卫⾥拿到token数据,然后根据需求做分⽀判 断,要是token存在就使⽤next⽅法正常放⾏跳转,否则可以强制跳回到登录,让⽤户去获取token ...
- Idea启动多服务时的Dashboard展示
1.提换.idea/workspace.xml文件中的RunDashboard标签 <component name="RunDashboard"> <option ...
- 云原生爱好者周刊:KubeKey v2.1.0 alpha 版发布!
KubeKey v2.1.0-alpha.0 发布啦!该版本的主要特性: 支持三种使用场景的 Etcd 集群(二进制部署,Kubeadm 部署,连接外置已存在的 Etcd 集群). 支持部署 Cont ...
- Vue写一个图片轮播组件【转载】
一.理清思路,理解需求和原理 1. 要写一个什么样的轮播? 在点击右侧箭头时,图片向左滑动到下一张:点击左侧箭头时,图片向右滑到下一张 点击下面的小圆点,滑到对应的图片,相应小圆点的样式也发生改变 要 ...
- DRF请求的生命周期
作为一个工作3年左右的码农,在各种框架的摸爬滚打中,我也接触了不少前端后端的技术栈,其中DRF算是我后端日常工作中的用得最多的框架.今天就简单聊聊DRF请求的生命周期.由于篇幅原因,我在此篇文章中只是 ...
- Java常见面试真题之中级进阶(HashMap篇)
前言 本来想着给自己放松一下,刷刷博客,突然被几道面试题难倒!说说Hashtable 与 HashMap 的区别?HashMap 中的 key 我们可以使用任何类作为 key 吗?HashMap 的长 ...
- 利用DbgHelp获取线程的栈回溯信息
当线程发生异常时,我们如果可以记录下来异常线程的堆栈信息,那么对于我们后续问题处理将会有极大的帮助.这里记录一个操作方法. 1 #include <iostream> 2 #include ...
- mysql skip-name-resolve 的解释
PHP交流群 717902309 为PHP广大爱好者提供技术交流,有问必答,相互学习相互进步! mysql连接很慢,登陆到服务器上查看mysql日志:IP address 'XX.XX.XX.XX' ...
- Flink on Yarn和k8s
Yarn 架构 下图为作业提交到yarn的交互流程: 组件列表 ResourceManager (RM):ResourceManager (RM) 负责处理客户端请求.启动 / 监控 Applicat ...
- end.jenkins的备份和迁移
数据备份: 进入安装目录 cd /var/lib/jenkins 进入到主目录下,可以看到很多文件,是否需要全部打包呢?其实我们只需要打包4个文件就可以了. 如上图所示分别是 config.xml ...