
NodeJs实现简单的爬虫
1.爬虫:爬虫,是一种按照一定的规则,自动地抓取网页信息的程序或者脚本;利用NodeJS实现一个简单的爬虫案例,爬取Boss直聘网站的web前端相关的招聘信息,以广州地区为例;
2.脚本所用到的nodejs模块
express 用来搭建一个服务,将结果渲染到页面
swig 模板引擎
cheerio 用来抓取页面的数据
requests 用来发送请求数据(具体可查:https://www.npmjs.com/package/requests)
async 用来处理异步操作,解决请求嵌套的问题,脚本中只使用了async.whilst(test,iteratee,callback),具体可见:https://caolan.github.io/async/
3.实现流程:
首先先获取到所爬取页面的URL,打开boss直聘网站,搜索web前端既可以获取到https://www.zhipin.com/c101280100-p100901/?page=1&ka=page-next

然后通过Chrome浏览器打开F12,获取到信息中多对应的dom节点,即可知道想要获取信息;
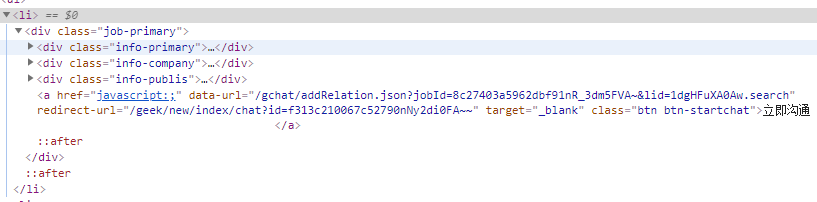
4.代码实现
目录结构:
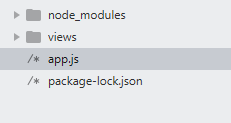
app.js
var cheerio = require('cheerio');

var requests = require('requests');

var async = require('async');

var express = require('express');

var swig = require('swig');

var app = express();

swig.setDefaults({cache:false});

app.set('views','./views/');

app.set('view engine','html');

app.engine('html',swig.renderFile);

app.get('/',function(req,res,next){

    var page = 1;  //当前页数

    var list = []; //保存记录

    async.whilst(

        function(){

            return page < 11;

        },

        function(callback){

            requests(`https://www.zhipin.com/c101280100-p100901/?page=${page}&ka=page-next`)

            .on('data',function(chunk){

            var $ = cheerio.load(chunk.toString());

            $('.job-primary').each(function(){

                var company = $(this).find('.info-company .company-text .name').text();

                var job_title = $(this).find('.info-primary .name .job-title').text();

                var salary = $(this).find('.info-primary .name .red').text();

                var description = $(this).find('.info-company .company-text p').text();

                var area = $(this).find('.info-primary p').text();

                var item = {

                    company:company,

                    job_title:job_title,

                    salary:salary,

                    description:description,

                    area:area

                };

                list.push(item);

            });

            page++;

            callback();

           }).on('end',function(err){

                   if(err){

                       console.log(err);

                   }

                   if(page==10){

                    res.render('index',{

                        lists:list

                    });

                }

           });

        },

        function(err){

            console.log(err);

        }

    );

});

//监听

app.listen(8080);
view/index.html页面
<!DOCTYPE html>

<html lang="en">

<head>

    <meta charset="UTF-8">

    <title>Document</title>

</head>

<style>

    table{

        width:1300px;

        border:1px solid #ccc;

        border-collapse: collapse;

        text-align: center;

        margin:0 auto;

    }

    td,tr,th{

        border:1px solid #ccc;

        border-collapse: collapse;

    }

    tr{

        height:30px;

        line-height: 30px;

    }

</style>

<body>

    <table>

        <thead>

            <tr>

                <th>公司名称</th>

                <th>公司地址</th>

                <th>薪资</th>

                <th>公司描述</th>

                <th>岗位名称</th>

            </tr>

        </thead>

        <tbody>

            {% for list in lists %}

                <tr>

                    <td>{{list.company}}</td>

                    <td>{{list.area}}</td>

                    <td>{{list.salary}}</td>

                    <td>{{list.description}}</td>

                    <td>{{list.job_title}}</td>

                </tr>

            {% endfor %}

        </tbody>

    </table>

</body>

</html>
5.启动
直接通过 node app.js启动即可;
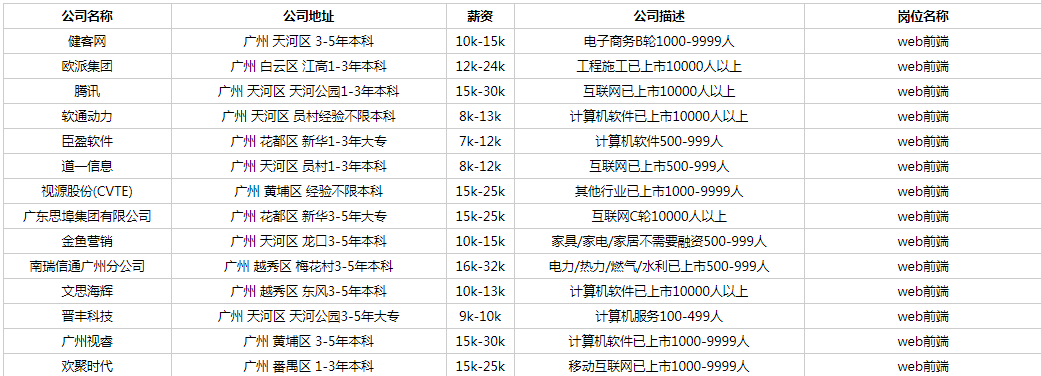
6.运行结果(http://localhost:8080),只截取部分数据
NodeJs实现简单的爬虫的更多相关文章
- 视频博文结合的教程:用nodejs实现简单的爬虫
教学视频地址: https://v.qq.com/x/page/b0643tut4ze.html 前言 本喵最近工作中需要使用node,并也想晋升为全栈工程师,所以开始了node学习之旅,在学习过 ...
- nodeJS实现简单网页爬虫功能
前面的话 本文将使用nodeJS实现一个简单的网页爬虫功能 网页源码 使用http.get()方法获取网页源码,以hao123网站的头条页面为例 http://tuijian.hao123.com/h ...
- nodejs的简单爬虫
闲聊 好久没写博客了,前几天小颖在朋友的博客里看到了用nodejs的简单爬虫.所以小颖就自己试着做了个爬博客园数据的demo.嘻嘻...... 小颖最近养了条泰日天,自从养了我家 ...
- nodejs实现最简单的爬虫
本文将以抓取百度搜索结果中关键词的相关搜索为例子,教会大家以nodejs制作最简单的爬虫: 开始之前呢,先来个公众号求粉: 将使用的node模块及属性介绍: request: ...
- 用nodejs实现简单爬虫
前言 本喵最近工作中需要使用node,并也想晋升为全栈工程师,所以开始了node学习之旅,在学习过程中, 我会总结一些实用的例子,做成博文和视频教程,以实例形式来理解体会node的用法,所以跟小猫 ...
- 每天几分钟跟小猫学前端之node系列:用node实现最简单的爬虫
先来段求分小视频: https://www.iesdouyin.com/share/video/6550631947750608142/?region=CN&mid=6550632036246 ...
- 用node.js从零开始去写一个简单的爬虫
如果你不会Python语言,正好又是一个node.js小白,看完这篇文章之后,一定会觉得受益匪浅,感受到自己又新get到了一门技能,如何用node.js从零开始去写一个简单的爬虫,十分钟时间就能搞定, ...
- Selenium + PhantomJS + python 简单实现爬虫的功能
Selenium 一.简介 selenium是一个用于Web应用自动化程序测试的工具,测试直接运行在浏览器中,就像真正的用户在操作一样 selenium2支持通过驱动真实浏览器(FirfoxDrive ...
- asp.net简单小爬虫
所谓爬虫简单点说,就是把别人网站上的东西爬下来,至于爬做什么用就看你自己了,比如:把别人网站上的东西爬下来放在自己网站中(感觉有点像小偷^v^). 这里随便写了一个爬虫代码(可以自己再去进行完善): ...
随机推荐
- 淘宝NPM镜像源
npm install -g cnpm --registry=https://registry.npm.taobao.org
- 最新php环境搭建,2017年最新PHP环境搭建
使用PHPWAMP8.8.8.8IN纯绿色集成环境搭建php网站很方便,哪怕你系统没安装vc.系统dll丢失或者损坏的时候,phpwamp也可以正常启动,是个很强大的php套件. php环境搭建,支持 ...
- python 网络编程 -- Tcp协议
Socket是网络编程的一个抽象概念.通常我们用一个Socket表示“打开了一个网络链接”,而打开一个Socket需要知道目标计算机的IP地址和端口号,再指定协议类型即可. 客户端 大多数连接都是可靠 ...
- codeforces 17C Balance(动态规划)
codeforces 17C Balance 题意 给定一个串,字符集{'a', 'b', 'c'},操作是:选定相邻的两个字符,把其中一个变成另一个.可以做0次或者多次,问最后可以生成多少种,使得任 ...
- 4、Node.js REPL(交互式解释器)
Node.js REPL(Read Eval Print Loop:交互式解释器) 表示一个电脑的环境,类似 Window 系统的终端或 Unix/Linux shell,我们可以在终端中输入命令,并 ...
- unittest:2 执行多条用例,仅执行一次setUp和tearDown
对象方法setUp()和tearDown() 每个用例执行前后都会被调用.但是有另外一种场景:setUp之后执行完所有用例,最后调用一次tearDown.比如打开网页,多条用例分别验证网页上的元素正确 ...
- WebSocket消息推送
WebSocket协议是基于TCP的一种新的网络协议,应用层,是TCP/IP协议的子集. 它实现了浏览器与服务器全双工(full-duplex)通信,客户端和服务器都可以向对方主动发送和接收数据.在J ...
- Python中的类(一)
Python中的类(一) 一. 应用场景 如果多个函数中有一些相同的参数时,转换成面向对象. 二. 如何创建类 类是用来描述具有相同的属性和方法的对象的集合.它定义了该集合中每个对象所共有的属性和方法 ...
- 6、Spring Cloud -熔断器Hystrix
6.1.什么是Hystrix 在分布式系统中.服务与服务之间的依赖错综复杂,一种不可避免的情况就是某些服务 出现故障,导致依赖于它们的其他服务出现远程调度的线程阻塞. Hystrix是Netfli ...
- WEB安全 ACCESS 注入、盲注脚本
http://www.xxx.cn/cp.asp?classid=3http://www.xxx.cn/cp.asp?classid=3 and //有拦截关键字http://www.xxx.cn/c ...