
sklearn KMeans聚类算法(总结)
基本原理
Kmeans是无监督学习的代表,没有所谓的Y。主要目的是分类,分类的依据就是样本之间的距离。比如要分为K类。步骤是:
- 随机选取K个点。
- 计算每个点到K个质心的距离,分成K个簇。
- 计算K个簇样本的平均值作新的质心
- 循环2、3
- 位置不变,距离完成
距离
Kmeans的基本原理是计算距离。一般有三种距离可选:
- 欧氏距离
\[d(x,u)=\sqrt{\sum_{i=1}^n(x_i-\mu_i)^2}
\] - 曼哈顿距离
\[d(x,u)=\sum_{i=1}^n(|x_i-\mu|)
\] - 余弦距离
\[cos\theta=\frac{\sum_{i=1}^n(x_i*\mu)}{\sqrt{\sum_i^n(x_i)^2}*\sqrt{\sum_1^n(\mu)^2}}
\]
inertia
每个簇内到其质心的距离相加,叫inertia。各个簇的inertia相加的和越小,即簇内越相似。(但是k越大inertia越小,追求k越大对应用无益处)
代码
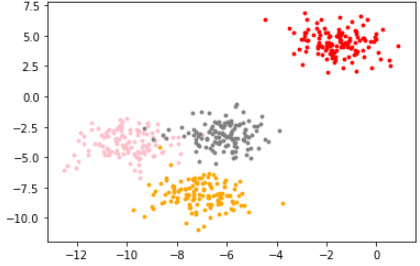
模拟数据:
from sklearn.datasets import make_blobs

import matplotlib.pyplot as plt

X, y = make_blobs(n_samples=500, # 500个样本

                 n_features=2, # 每个样本2个特征

                 centers=4, # 4个中心

                 random_state=1 #控制随机性

                 )
画出图像:
color = ['red', 'pink','orange','gray']

fig, axi1=plt.subplots(1)

for i in range(4):

    axi1.scatter(X[y==i, 0], X[y==i,1],

               marker='o',

               s=8,

               c=color[i]

               )

plt.show()
使用KMeans类建模:
from sklearn.cluster import KMeans

n_clusters=3

cluster = KMeans(n_clusters=n_clusters,random_state=0).fit(X)
也可先用fit, 再用predict,但是可能数据不准确。用于数据量较大时。
此时就可以查看其属性了:质心、inertia.
centroid=cluster.cluster_centers_

centroid # 查看质心
查看inertia:
inertia=cluster.inertia_

inertia
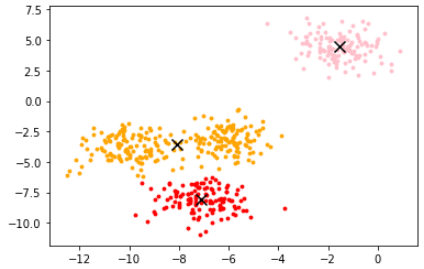
画出所在位置。
color=['red','pink','orange','gray']

fig, axi1=plt.subplots(1)

for i in range(n_clusters):

    axi1.scatter(X[y_pred==i, 0], X[y_pred==i, 1],

               marker='o',

               s=8,

               c=color[i])

axi1.scatter(centroid[:,0],centroid[:,1],marker='x',s=100,c='black')
sklearn KMeans聚类算法(总结)的更多相关文章
- 转载: scikit-learn学习之K-means聚类算法与 Mini Batch K-Means算法
版权声明:<—— 本文为作者呕心沥血打造,若要转载,请注明出处@http://blog.csdn.net/gamer_gyt <—— 目录(?)[+] ================== ...
- 一步步教你轻松学K-means聚类算法
一步步教你轻松学K-means聚类算法(白宁超 2018年9月13日09:10:33) 导读:k-均值算法(英文:k-means clustering),属于比较常用的算法之一,文本首先介绍聚类的理 ...
- 《数据挖掘导论》实验课——实验七、数据挖掘之K-means聚类算法
实验七.数据挖掘之K-means聚类算法 一.实验目的 1. 理解K-means聚类算法的基本原理 2. 学会用python实现K-means算法 二.实验工具 1. Anaconda 2. skle ...
- K-Means 聚类算法
K-Means 概念定义: K-Means 是一种基于距离的排他的聚类划分方法. 上面的 K-Means 描述中包含了几个概念: 聚类(Clustering):K-Means 是一种聚类分析(Clus ...
- k-means聚类算法python实现
K-means聚类算法 算法优缺点: 优点:容易实现缺点:可能收敛到局部最小值,在大规模数据集上收敛较慢使用数据类型:数值型数据 算法思想 k-means算法实际上就是通过计算不同样本间的距离来判断他 ...
- K-Means 聚类算法原理分析与代码实现
前言 在前面的文章中,涉及到的机器学习算法均为监督学习算法. 所谓监督学习,就是有训练过程的学习.再确切点,就是有 "分类标签集" 的学习. 现在开始,将进入到非监督学习领域.从经 ...
- Kmeans聚类算法原理与实现
Kmeans聚类算法 1 Kmeans聚类算法的基本原理 K-means算法是最为经典的基于划分的聚类方法,是十大经典数据挖掘算法之一.K-means算法的基本思想是:以空间中k个点为中心进行聚类,对 ...
- 机器学习六--K-means聚类算法
机器学习六--K-means聚类算法 想想常见的分类算法有决策树.Logistic回归.SVM.贝叶斯等.分类作为一种监督学习方法,要求必须事先明确知道各个类别的信息,并且断言所有待分类项都有一个类别 ...
- 沙湖王 | 用Scipy实现K-means聚类算法
沙湖王 | 用Scipy实现K-means聚类算法 用Scipy实现K-means聚类算法
随机推荐
- [HNOI2008] 玩具装箱 D2 T3 斜率优化DP
Description P教授要去看奥运,但是他舍不下他的玩具,于是他决定把所有的玩具运到北京.他使用自己的压缩器进行压缩,其可以将任意物品变成一堆,再放到一种特殊的一维容器中.P教授有编号为1... ...
- 说说lock到底要锁谁?
波安搬... http://www.cnblogs.com/wolf-sun/p/4209521.html ---------------------------------------------- ...
- 常见的http错误
错误类型: 1xx(临时响应) 表示临时响应并需要请求者继续执行操作的状态代码. 2xx (成功) 表示成功处理了请求的状态代码. 3xx (重定向) 表示要完成请求,需要进一步操作. 通常,这些状态 ...
- EUI库 - 快速入口之项目配置
egretProperties.json exmlRoot 指定exml文件存放根目录,该路径必须为相对路径,目录内只能有exml文件 themes 主题文件数组,配置所有主题文件路径,该 ...
- Floyd--P1119 灾后重建
题目背景 B地区在地震过后,所有村庄都造成了一定的损毁,而这场地震却没对公路造成什么影响.但是在村庄重建好之前,所有与未重建完成的村庄的公路均无法通车.换句话说,只有连接着两个重建完成的村庄的公路才能 ...
- SQL的查询结果复制到Excel 带标题Head 有换行符导致换行错乱 的解决方案
将SQL查询到的结果保存为excel有很多方法,其中最简单的就是直接复制粘贴了 1.带Head的复制粘贴 1)先左击红色区域实现选择所有数据 2)随后右击选择Copy with Headers 再粘 ...
- LIS(最长上升子序列)的 DP 与 (贪心+二分) 两种解法
正好训练赛来了一道最长递减序列问题,所以好好研究了一下最长递增序列问题. B - Testing the CATCHER Time Limit:1000MS Memory Limit:3000 ...
- leetcode - 两数之和Ⅳ 输入BST(653)
题目描述:给定一个二叉搜索树和一个目标结果,如果 BST 中存在两个元素且它们的和等于给定的目标结果,则返回 true. 解题思路:根据二叉搜索树的特点,对二叉搜索树进行中序遍历可以得到一个从小到达排 ...
- 广义高斯分布(GGD)和非对称广义高斯分布(AGGD)
<No-Reference Image Quality Assessment in the Spatial Domain>,BRISQUE. 1. 广义高斯分布,generalized G ...
- js保留的关键字
js保留的关键字 break else new var case finally return void catch for switch while continue function this w ...