
Storm WordCount
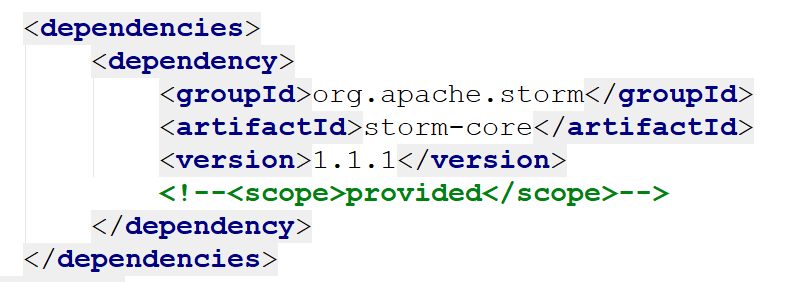
特别注意,在本地运行的时候应该去掉<scope>provided</scope>,否则会报java.lang.ClassNotFoundException: org.apache.storm.topology.IRichSpout
集群环境中运行的时候应该加上
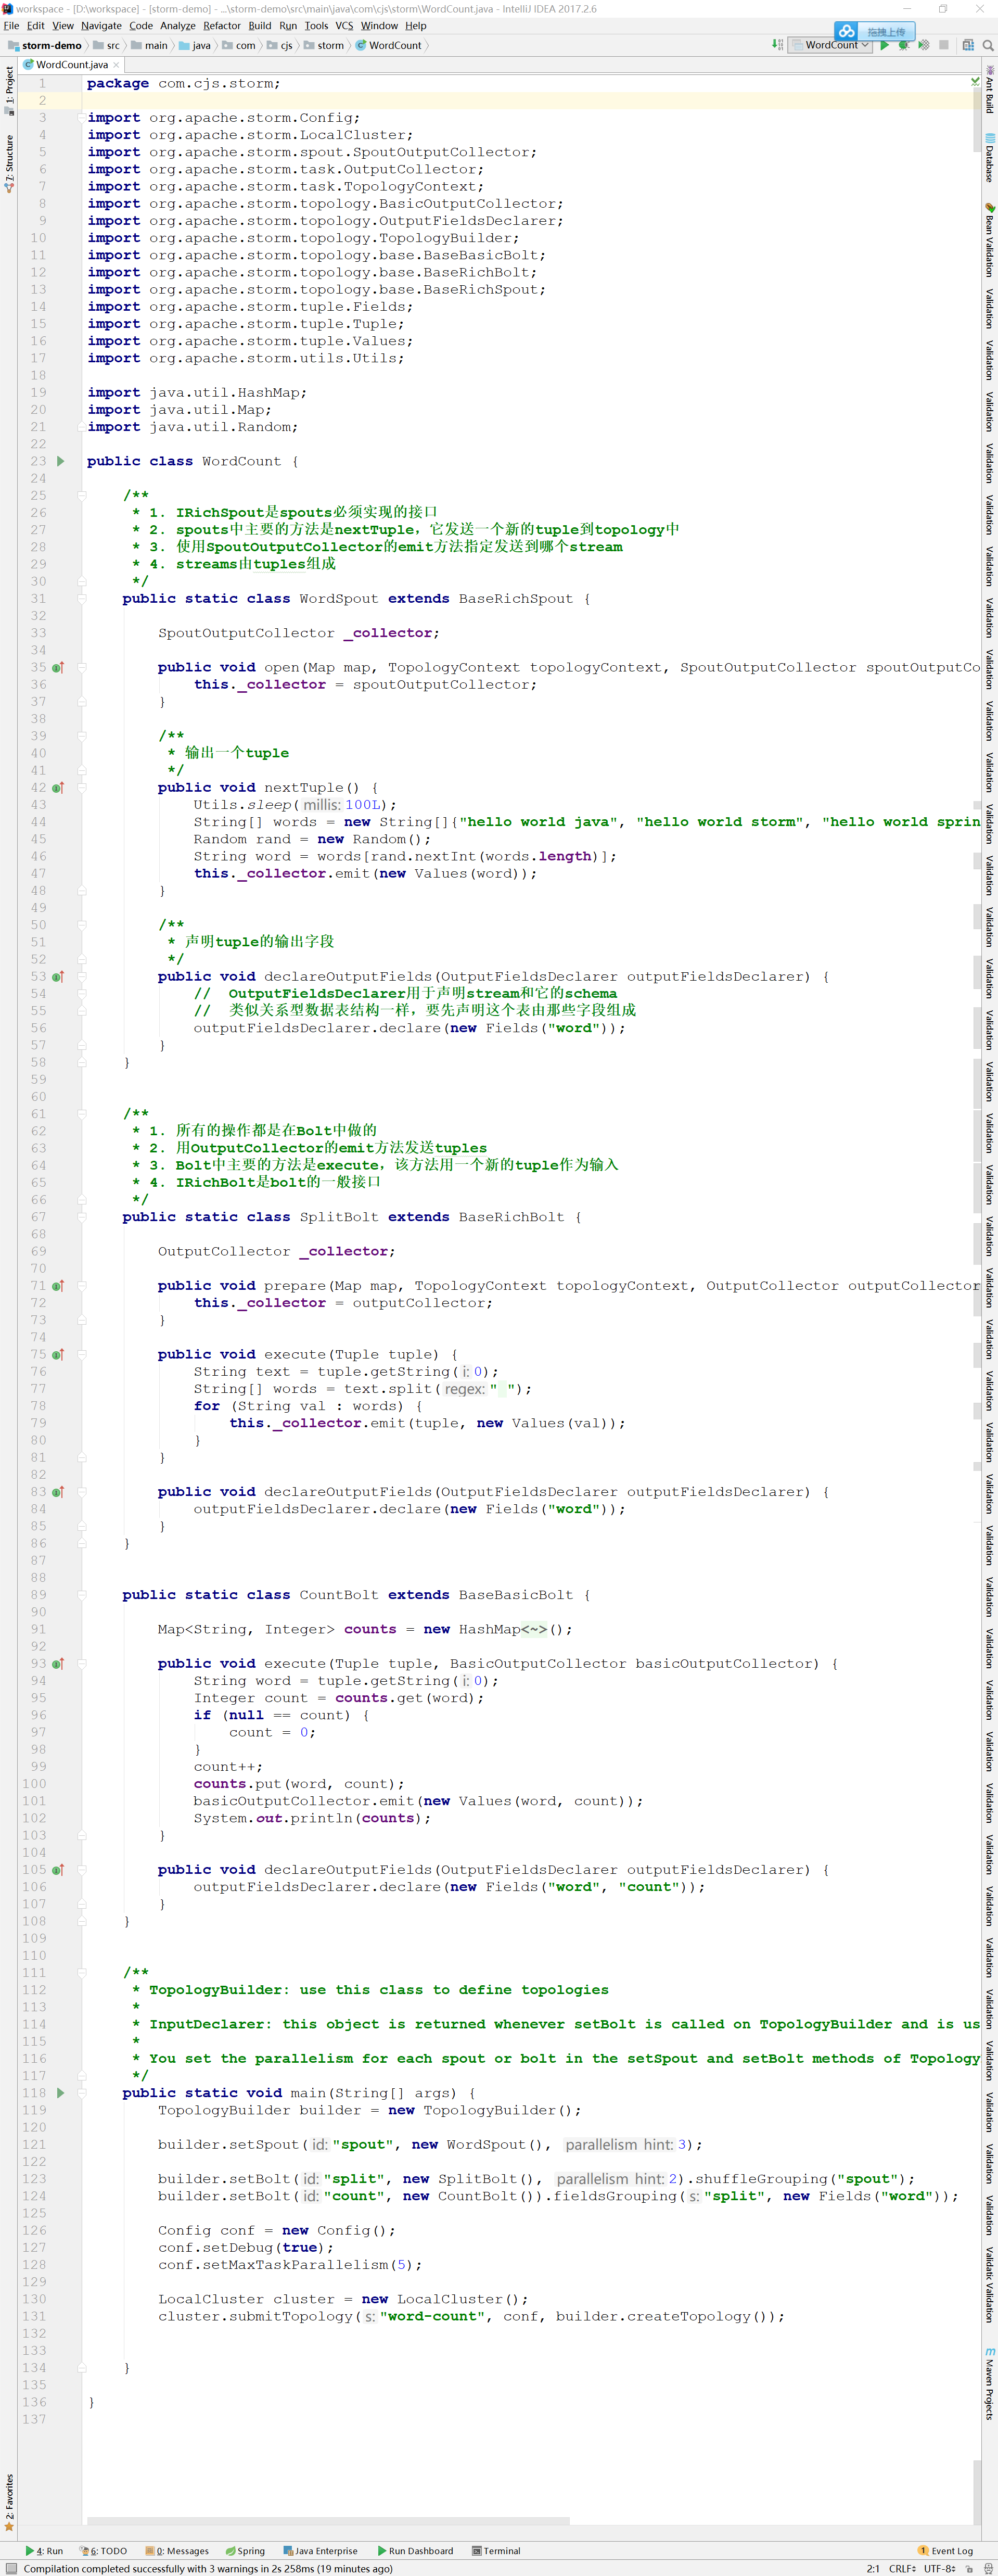
在这个例子中,有一个spout,两个bolt,也就是说这个任务分为两步。spout随机发送一句话到stream,而SplitBolt负责将其分隔成一个一个单词,CountBolt负责计数。运行的时候,spout的并行数是3,SplitBolt的并行数是2,也就是说相当于有3个spout,2个SplitBolt,1个CountBolt。
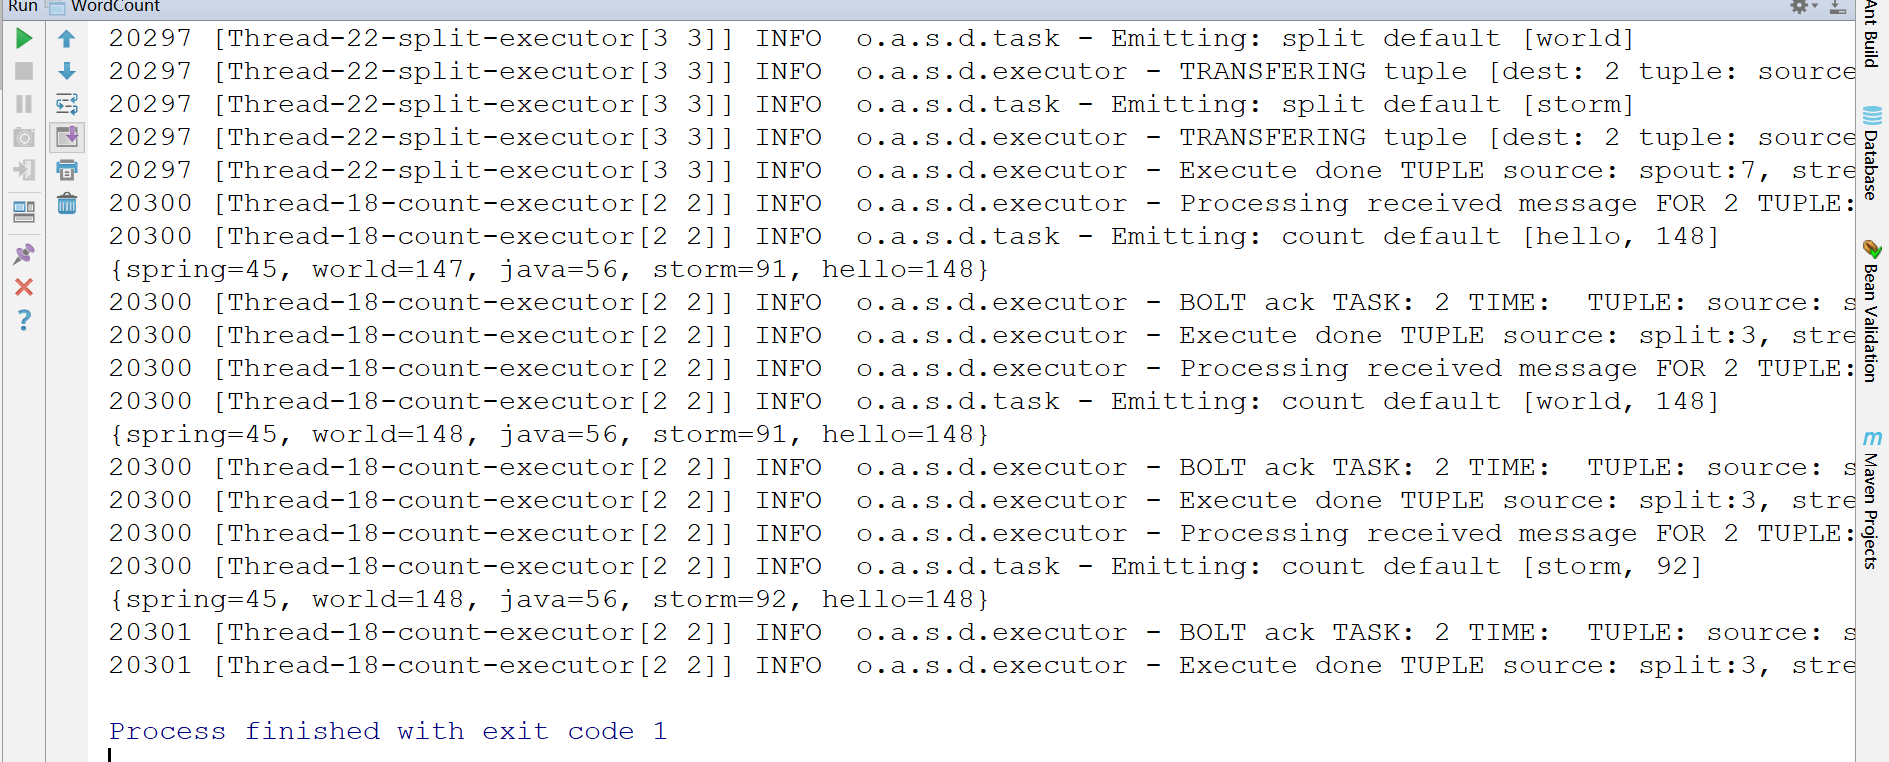
运行的时候,直接右键运行main方法即可,输出结果大概是这样的:
简单的对比hadoop,可以这样理解storm:
Storm中的Topology相当于Hadoop中的Job
Storm中的Spout相当于Hadoop中的输入文件,而Bolt相当于MapReduce任务
Storm中的每一个处理是一个Bolt再到下一个Bolt,而Hadoop中是一个MapReduce任务再下一个MapReduce
如果一个任务需要分多步完成的话,那么在Storm中每一步就相当于一个Bolt,而在Hadoop中每一步相当于一个MapReduce任务
Storm WordCount的更多相关文章
- Storm wordcount Read from file
source code: package stormdemo; import java.io.BufferedReader; import java.io.BufferedWriter; import ...
- 3、SpringBoot 集成Storm wordcount
WordCountBolt public class WordCountBolt extends BaseBasicBolt { private Map<String,Integer> c ...
- Storm WordCount Topology学习
1,分布式单词计数的流程 首先要有数据源,在SentenceSpout中定义了一个字符串数组sentences来模拟数据源.字符串数组中的每句话作为一个tuple发射.其实,SplitBolt接收Se ...
- Storm入门(四)WordCount示例
一.关联代码 使用maven,代码如下. pom.xml 和Storm入门(三)HelloWorld示例相同 RandomSentenceSpout.java /** * Licensed to t ...
- 基于Storm的WordCount
Storm WordCount 工作过程 Storm 版本: 1.Spout 从外部数据源中读取数据,随机发送一个元组对象出去: 2.SplitBolt 接收 Spout 中输出的元组对象,将元组中的 ...
- storm教程
二.安装部署 一.storm伪分布式安装 (一)环境准备1.OS:debian 72.JDK 7.0 (二)安装zookeeper1.下载zookeeper并解压 wget http://mirr ...
- 亿级流量场景下,大型架构设计实现【2】---storm篇
承接之前的博:亿级流量场景下,大型缓存架构设计实现 续写本博客: ****************** start: 接下来,我们是要讲解商品详情页缓存架构,缓存预热和解决方案,缓存预热可能导致整个系 ...
- Flume+Kafka+Storm整合
Flume+Kafka+Storm整合 1. 需求: 有一个客户端Client可以产生日志信息,我们需要通过Flume获取日志信息,再把该日志信息放入到Kafka的一个Topic:flume-to-k ...
- storm编程指南
目录 storm编程指南 (一)创建spout (二)创建split-bolt (三)创建wordcount-bolt (四)创建report-bolt (五)创建topo storm编程指南 @(博 ...
随机推荐
- Servers无法打开
有时候打开MyEclipse莫名Servers窗口挂掉, 出现"Could Not Create The View :An Unexpected Exception Was Thrown&q ...
- MongoDB学习记录(三) - MongoDB的"增查改删"操作之"查"
查找使用的方法: db.collection.find() 查找所有文档 db.collection.find({})或者db.collection.find({}) 指定键值对 db.collect ...
- 分别求二叉树前、中、后序的第k个节点
一.求二叉树的前序遍历中的第k个节点 //求先序遍历中的第k个节点的值 ; elemType preNode(BTNode *root,int k){ if(root==NULL) return ' ...
- P1081 开车旅行(Not Finish)
https://www.luogu.org/problemnew/show/P1081
- python3 爬取搜狗微信的文章
目标地址:http://weixin.sogou.com/weixin? 这个地址是搜狗微信的文章搜索,可以搜索到微信的文章,而我们目标就是这些文章内容 这个url经过测试,当我们没登陆微信只能看到1 ...
- NodeJS (npm) 学习笔记
零, npm是nodeJS的包管理器,下载nodeJS后会自动安装好npm. 一,windows下安装 nodeJS并配置(以及angular安装相关问题) 1, 下载安装 https://nodej ...
- python0301
1 .pycharm的使用 2.格式化输出 # name = input('请输入姓名')# age = input('请输入年龄')# hobby = input('请输入爱好')# msg = ' ...
- mount的几个选项
一.mount -o noatime表示在读文件时不去更改文件的access time属性了,所以该选项会提升mount操作的执行效率. 二.mount --bind:等同于 -o bind可用于挂载 ...
- 公用表表达式 (CTE)、递归、所有子节点、sqlserver
指定临时命名的结果集,这些结果集称为公用表表达式 (CTE).公用表表达式可以包括对自身的引用.这种表达式称为递归公用表表达式. 对于递归公用表达式来说,实现原理也是相同的,同样需要在语句中定义两部分 ...
- .NET CORE迁移踩坑
https://www.cnblogs.com/leolaw/p/10740678.html