
第三百四十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
第三百四十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
Requests请求
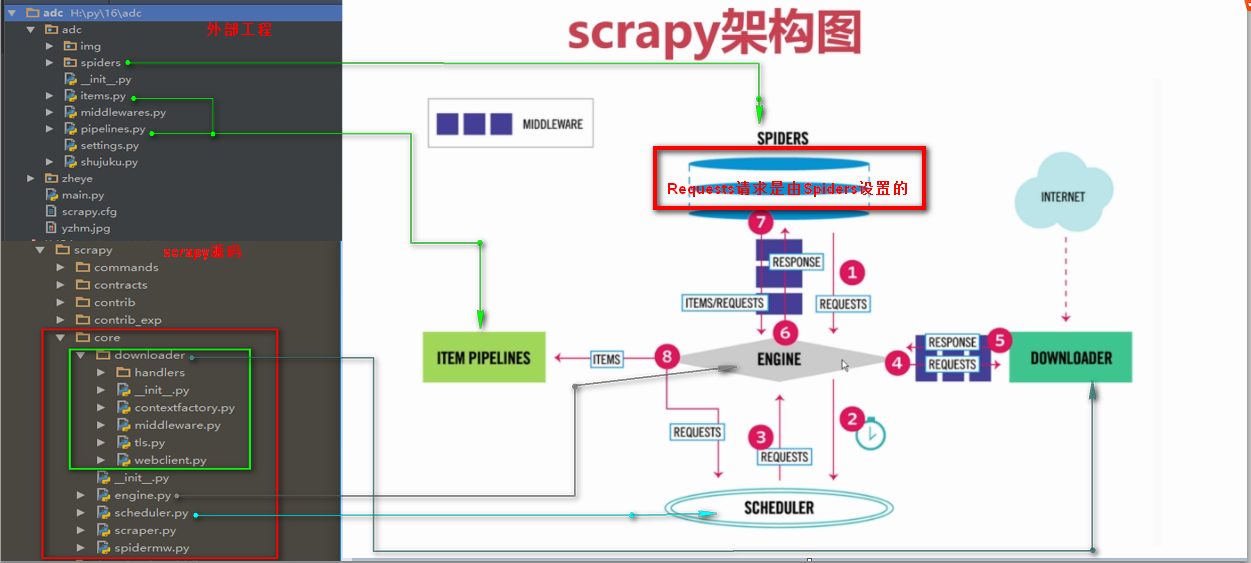
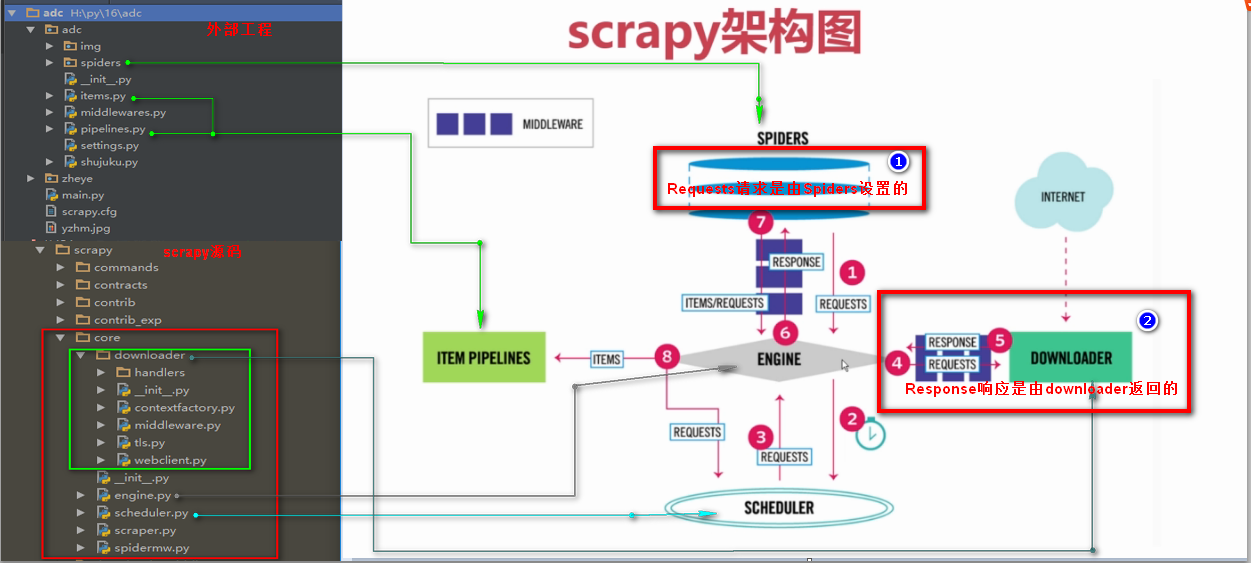
Requests请求就是我们在爬虫文件写的Requests()方法,也就是提交一个请求地址,Requests请求是我们自定义的
Requests()方法提交一个请求
参数:
url= 字符串类型url地址
callback= 回调函数名称
method= 字符串类型请求方式,如果GET,POST
headers= 字典类型的,浏览器用户代理
cookies= 设置cookies
meta= 字典类型键值对,向回调函数直接传一个指定值
encoding= 设置网页编码
priority= 默认为0,如果设置的越高,越优先调度
dont_filter= 默认为False,如果设置为真,会过滤掉当前url
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request,FormRequest

import re

class PachSpider(scrapy.Spider):                            #定义爬虫类,必须继承scrapy.Spider

    name = 'pach'                                           #设置爬虫名称

    allowed_domains = ['www.luyin.org/']                    #爬取域名

    # start_urls = ['']                                     #爬取网址,只适于不需要登录的请求,因为没法设置cookie等信息

    header = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64; rv:54.0) Gecko/20100101 Firefox/54.0'}  #设置浏览器用户代理

    def start_requests(self):    #起始url函数,会替换start_urls

        """第一次请求一下登录页面,设置开启cookie使其得到cookie,设置回调函数"""

        return [Request(

            url='http://www.luyin.org/',

            headers=self.header,

            meta={'cookiejar':1},       #开启Cookies记录,将Cookies传给回调函数

            callback=self.parse

        )]

    def parse(self, response):

        title = response.xpath('/html/head/title/text()').extract()

        print(title)
Response响应
Response响应是由downloader返回的响应

Response响应参数
headers 返回响应头
status 返回状态吗
body 返回页面内容,字节类型
url 返回抓取url
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request,FormRequest

import re

class PachSpider(scrapy.Spider):                            #定义爬虫类,必须继承scrapy.Spider

    name = 'pach'                                           #设置爬虫名称

    allowed_domains = ['www.luyin.org/']                    #爬取域名

    # start_urls = ['']                                     #爬取网址,只适于不需要登录的请求,因为没法设置cookie等信息

    header = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64; rv:54.0) Gecko/20100101 Firefox/54.0'}  #设置浏览器用户代理

    def start_requests(self):    #起始url函数,会替换start_urls

        """第一次请求一下登录页面,设置开启cookie使其得到cookie,设置回调函数"""

        return [Request(

            url='http://www.luyin.org/',

            headers=self.header,

            meta={'cookiejar':1},       #开启Cookies记录,将Cookies传给回调函数

            callback=self.parse

        )]

    def parse(self, response):

        title = response.xpath('/html/head/title/text()').extract()

        print(title)

        print(response.headers)

        print(response.status)

        # print(response.body)

        print(response.url)
第三百四十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍的更多相关文章
- 二十五 Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
Requests请求 Requests请求就是我们在爬虫文件写的Requests()方法,也就是提交一个请求地址,Requests请求是我们自定义的 Requests()方法提交一个请求 参数: ur ...
- 第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP
第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP 设置代理ip只需要,自定义一个中间件,重写process_request方法, request ...
- 第三百四十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy模拟登陆和知乎倒立文字验证码识别
第三百四十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy模拟登陆和知乎倒立文字验证码识别 第一步.首先下载,大神者也的倒立文字验证码识别程序 下载地址:https://gith ...
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
- 第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中
第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中,判断URL是否重复 布隆过滤器(Bloom Filter)详 ...
- 第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启 scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的UR ...
- 第三百三十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—深度优先与广度优先原理
第三百三十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—深度优先与广度优先原理 网站树形结构 深度优先 是从左到右深度进行爬取的,以深度为准则从左到右的执行(递归方式实现)Scrapy默认 ...
- 第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目
第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目 scrapyd模块是专门用于部署scrapy项目的,可以部署和管理scrapy项目 下载地址:h ...
随机推荐
- 菜鸟学Java(五)——JSP内置对象之request
书接上回,上次跟大家概括的说了说JSP的九种常用内置对象.接下来就该聊聊它们各自的特点了,今天先说说request吧. 下面是request的一些常用方法: isUserInRole(String r ...
- lua -- 事件响应与局部变量
-- 这里要注意的点是:虽然nAmount是局部变量,却在控件的响应函数中使用 -- 因为控件的响应函数是在该变量的区域内,所以可以用 -- 如果控件的响应函数在外部,那么该变量就要声明成为全局变量 ...
- 深入源码分析Java线程池的实现原理
程序的运行,其本质上,是对系统资源(CPU.内存.磁盘.网络等等)的使用.如何高效的使用这些资源是我们编程优化演进的一个方向.今天说的线程池就是一种对CPU利用的优化手段. 通过学习线程池原理,明白所 ...
- 每日英语:Bosses May Use Social Media to Discriminate Against Job Seekers
Many companies regularly look up job applicants online as part of the hiring process. A new study su ...
- Zend Studio 12 windows 无限期试用
安装: 1.下载最新版本Zend Studio:http://downloads.zend.com/studio-eclipse/12.0.0/ZendStudio-12.0.0-win32.win3 ...
- 【转】(三)unity4.6Ugui中文教程文档-------概要-UGUI Basic Layout
原创至上,移步请戳:(三)unity4.6Ugui中文教程文档-------概要-UGUI Basic Layout 2. BasicLayout 在这一节我们会看到UI元素相对于画布的位置是怎样的. ...
- spark提示Caused by: java.lang.ClassCastException: scala.collection.mutable.WrappedArray$ofRef cannot be cast to [Lscala.collection.immutable.Map;
spark提示Caused by: java.lang.ClassCastException: scala.collection.mutable.WrappedArray$ofRef cannot b ...
- JSch远程执行脚本
JSch远程执行脚本 2017-02-24 在自动化测试的时候,需要远程操控服务器做一些操作,比如切日.起服务器.执行某些脚本.如何实现? 我们可以利用JSch,远程执行脚本.JSch是Java Se ...
- 插入中国所有省和市的SQL语句--以后用
需要做根据省市过滤查询的,不得已写入数据库,这个留着方便以后用. 首先创建两张表 drop database if exists BSM; create database BSM; use BSM; ...
- 微服务之springCloud-docker-feign-hystrix-ribbon(七)
简介 在上一节中,我们讨论了feign+hystrix在项目开发中,除了考虑正常的调用之外,负载均衡和故障转移也是关注的重点,这也是feign + ribbon+hystrix的优势所在,本节我们就讨 ...