
python爬取酷狗音乐
我们随便访问一个歌曲可以看到url有个hash
https://www.kugou.com/song/#hash=AC9D859362CABB2092AEAA39A072606A&album_id=39211957
但是这个hash是可以得到的

import re

import requests

import json

headers = {

    'cookie': 'kg_mid=7a7f50715e7cbc43187cb14650a074d7; ACK_SERVER_10015=%7B%22list%22%3A%5B%5B%22gzlogin-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10016=%7B%22list%22%3A%5B%5B%22gzreg-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10017=%7B%22list%22%3A%5B%5B%22gzverifycode.service.kugou.com%22%5D%5D%7D; kg_dfid=2lP8Vp1RHLHj0wmucn0XlXFL; kg_dfid_collect=d41d8cd98f00b204e9800998ecf8427e; Hm_lvt_aedee6983d4cfc62f509129360d6bb3d=1600062203; kg_mid_temp=7a7f50715e7cbc43187cb14650a074d7; KuGooRandom=66401600062231494; Hm_lpvt_aedee6983d4cfc62f509129360d6bb3d=1600062409',

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

hash_com = re.compile('"Hash":"(.*?)"',re.I|re.S)

html = requests.get('https://www.kugou.com/yy/html/rank.html',headers=headers)

hash_result = hash_com.findall(html.text)

print(hash_result)
然后我们刷新歌曲这里得网页可以看到都是在这里
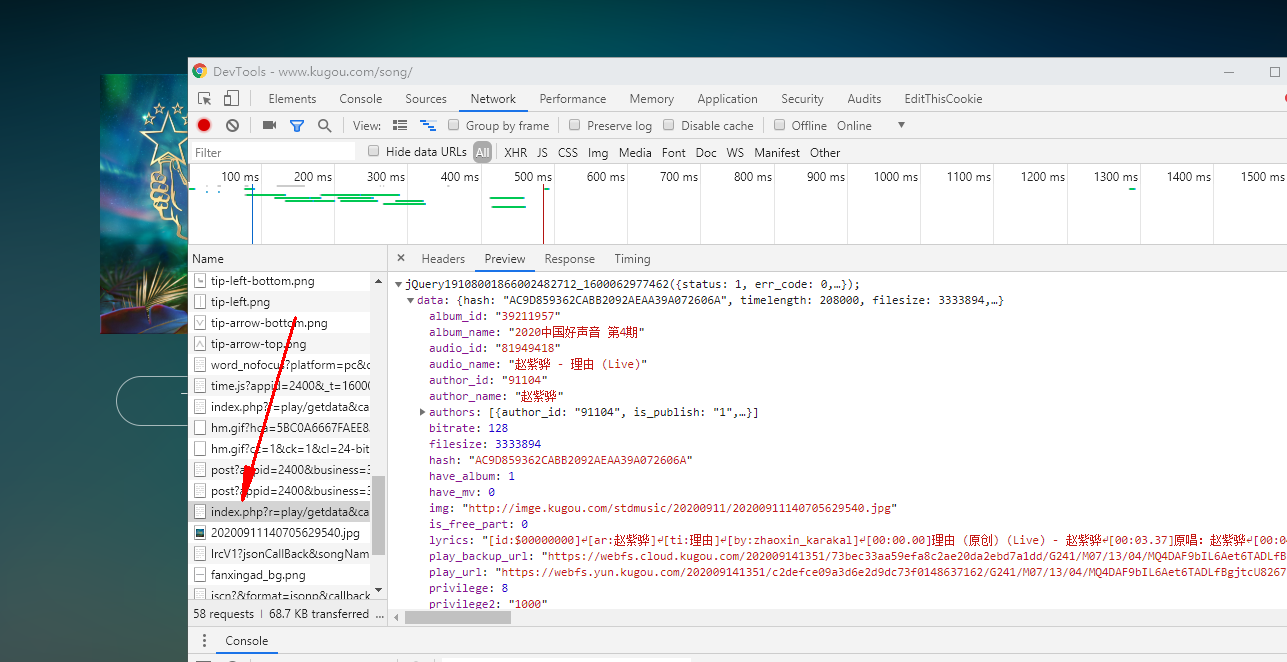
然后我敲门只留hash前面看看能不能访问
https://wwwapi.kugou.com/yy/index.php?r=play/getdata&callback=jQuery19108001866002482712_1600062977462&hash=AC9D859362CABB2092AEAA39A072606A
访问是可以的
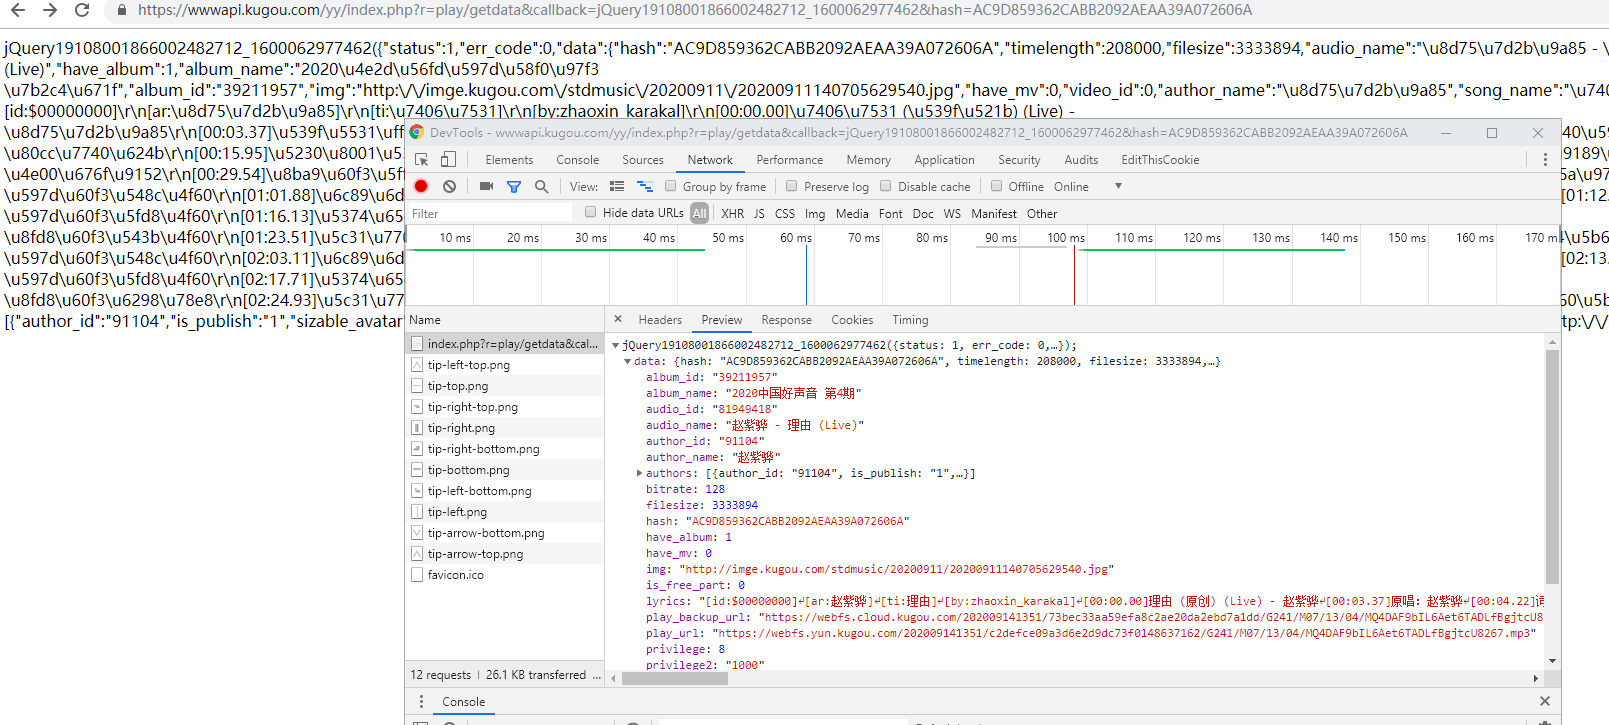
然后我们再拼接一下
import re

import requests

import json

headers = {

    'cookie': 'kg_mid=7a7f50715e7cbc43187cb14650a074d7; ACK_SERVER_10015=%7B%22list%22%3A%5B%5B%22gzlogin-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10016=%7B%22list%22%3A%5B%5B%22gzreg-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10017=%7B%22list%22%3A%5B%5B%22gzverifycode.service.kugou.com%22%5D%5D%7D; kg_dfid=2lP8Vp1RHLHj0wmucn0XlXFL; kg_dfid_collect=d41d8cd98f00b204e9800998ecf8427e; Hm_lvt_aedee6983d4cfc62f509129360d6bb3d=1600062203; kg_mid_temp=7a7f50715e7cbc43187cb14650a074d7; KuGooRandom=66401600062231494; Hm_lpvt_aedee6983d4cfc62f509129360d6bb3d=1600062409',

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

hash_com = re.compile('"Hash":"(.*?)"',re.I|re.S)

html = requests.get('https://www.kugou.com/yy/html/rank.html',headers=headers)

hash_result = hash_com.findall(html.text)

# print(hash_result)

base_url = 'https://wwwapi.kugou.com/yy/index.php?r=play/getdata&callback=jQuery19108001866002482712_1600062977462&hash='

for hash in hash_result:

    url = base_url+hash

    # print(url)
然后再获取url
jsondata = requests.get(url,headers=headers)

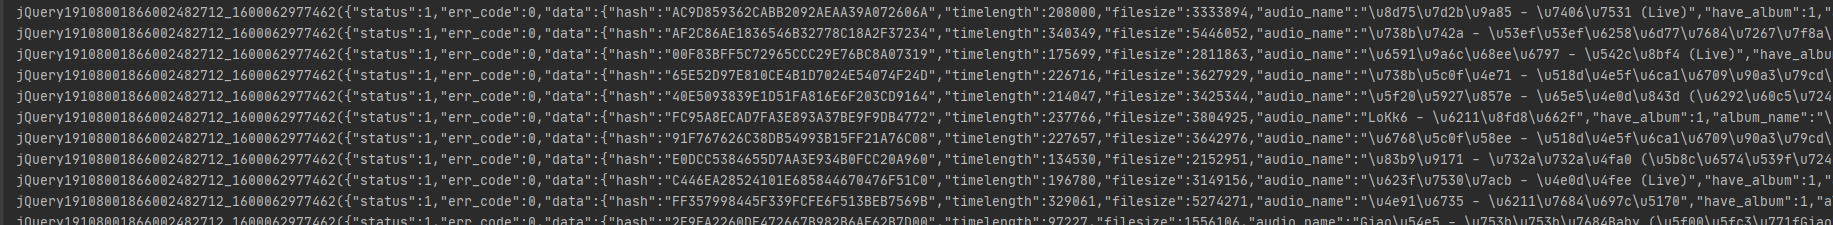
    print(jsondata.text)
输出为
我们来.json()看看
print(jsondata.json())
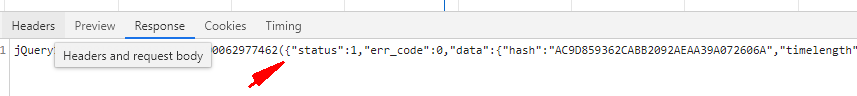
但是返回错误了,所以不是一个合法json,来转换一下,通过find来找到合法的json头部和尾部
他的合法开头再这里
结尾就是 .mp3"}}
start = jsondata.text.find('{"status":1')

end = jsondata.text.find('.mp3"}}')+len('.mp3"}}')

print(jsondata.text[start:end])
这里加上len就是因为[]是左闭右合的,返回

全部代码
import re

import requests

import json

import os

headers = {

    'cookie': 'kg_mid=7a7f50715e7cbc43187cb14650a074d7; ACK_SERVER_10015=%7B%22list%22%3A%5B%5B%22gzlogin-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10016=%7B%22list%22%3A%5B%5B%22gzreg-user.kugou.com%22%5D%5D%7D; ACK_SERVER_10017=%7B%22list%22%3A%5B%5B%22gzverifycode.service.kugou.com%22%5D%5D%7D; kg_dfid=2lP8Vp1RHLHj0wmucn0XlXFL; kg_dfid_collect=d41d8cd98f00b204e9800998ecf8427e; Hm_lvt_aedee6983d4cfc62f509129360d6bb3d=1600062203; kg_mid_temp=7a7f50715e7cbc43187cb14650a074d7; KuGooRandom=66401600062231494; Hm_lpvt_aedee6983d4cfc62f509129360d6bb3d=1600062409',

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

hash_com = re.compile('"Hash":"(.*?)"',re.I|re.S)

html = requests.get('https://www.kugou.com/yy/html/rank.html',headers=headers)

hash_result = hash_com.findall(html.text)

# print(hash_result)

base_url = 'https://wwwapi.kugou.com/yy/index.php?r=play/getdata&callback=jQuery19108001866002482712_1600062977462&hash='

for hash in hash_result:

    url = base_url+hash

    # print(url)

    jsondata = requests.get(url,headers=headers)

    start = jsondata.text.find('{"status":1')

    end = jsondata.text.find('.mp3"}}')+len('.mp3"}}')

    # print(jsondata.text[start:end])

    songurl = json.loads(jsondata.text[start:end])['data']['play_url']

    title = json.loads(jsondata.text[start:end])['data']['audio_name']

    if not os.path.exists('酷狗'):

        os.mkdir('酷狗')

    with open('酷狗/{}.mp3'.format(title),'wb')as f:

        f.write(requests.get(songurl).content)

python爬取酷狗音乐的更多相关文章
- python爬取酷狗音乐排行榜
本文为大家分享了python爬取酷狗音乐排行榜的具体代码,供大家参考,具体内容如下
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- Python爬取酷狗飙升榜前十首(100)首,写入CSV文件
酷狗飙升榜,写入CSV文件 爬取酷狗音乐飙升榜的前十首歌名.歌手.时间,是一个很好的爬取网页内容的例子,对爬虫不熟悉的读者可以根据这个例子熟悉爬虫是如何爬取网页内容的. 需要用到的库:requests ...
- python使用beautifulsoup4爬取酷狗音乐
声明:本文仅为技术交流,请勿用于它处. 小编经常在网上听一些音乐但是有一些网站好多音乐都是付费下载的正好我会点爬虫技术,空闲时间写了一份,截止4月底没有问题的,会下载到当前目录,只要按照bs4库就好, ...
- 使用scrapy 爬取酷狗音乐歌手及歌曲名并存入mongodb中
备注还没来得及写,共爬取八千多的歌手,每名歌手平均三十首歌曲算,大概二十多万首歌曲 run.py #!/usr/bin/env python # -*- coding: utf-8 -*- __aut ...
- 【Python】【爬虫】爬取酷狗音乐网络红歌榜
原理:我的上篇博客 import requests import time from bs4 import BeautifulSoup def get_html(url): ''' 获得 HTML ' ...
- 【Python】【爬虫】爬取酷狗TOP500
好啦好啦,那我们来拉开我们的爬虫之旅吧~~~ 这一只小爬虫是爬取酷狗TOP500的,使用的爬取手法简单粗暴,目的是帮大家初步窥探爬虫长啥样,后期会慢慢变得健壮起来的. 环境配置 在此之前需要下载一个谷 ...
- htmlunit+fastjson抓取酷狗音乐 qq音乐链接及下载
上次学了jsoup之后,发现一些动态生成的网页内容是无法抓取的,于是又学习了htmlunit,下面是抓取酷狗音乐与qq音乐链接的例子: 酷狗音乐: import java.io.BufferedInp ...
- 使用Xpath爬取酷狗TOP500的歌曲信息
使用xpath爬取酷狗TOP500的歌曲信息, 将排名.歌手名.歌曲名.歌曲时长,提取的结果以文件形式保存下来.参考网址:http://www.kugou.com/yy/rank/home/1-888 ...
随机推荐
- J20航模遥控器开源项目系列教程(一)制作教程 | 基础版V1.0发布,从0到1
我们的开源宗旨:自由 协调 开放 合作 共享 拥抱开源,丰富国内开源生态,开展多人运动,欢迎加入我们哈~ 和一群志同道合的人,做自己所热爱的事! 项目开源地址:https://github.com/C ...
- CentOS下删除物理磁盘,删除LVM
1.删除 dmsetup remove LV_name 2.vgreduce VG_name --removemissing 3.vgremove VG_name 4.pvremove disk
- Hadoop上小文件如何存储?
Block是文件块,HDFS中是以Block为单位进行文件的管理的,一个文件可能有多个块,每个块默认是3个副本,这些块分别存储在不同机器上.块与文件之前的映射关系会定时上报Namenode.HDFS中 ...
- 创建human用户登录数据库创建表
根据人力资源管理系统中表的设计,创建human用户登录数据库创建 准备阶段 把运行脚本复制到D:\app\Administrator\product\11.2.0\dbhome_1\demo\sche ...
- 【洛谷日报#26】GCC自带位运算系列函数
文章转自 洛谷 谈到GCC的黑科技,大家想到的一定是这句: #pragma GCC optimize (3)//吸氧 抑或是这句: #pragma GCC diagnostic error " ...
- 【平台开发】— 4.mysql建库建表
本想着把前端脚手架run起来了,然后就可以借着登录来捋一下前后端交互的过程.但是后端导入JPA的时候就发现了,还没有数据库. 既然是本着学习的目的,那咱也不想只在后端写死返回的数据,要做就做全套. 一 ...
- CA定义以及功能说明
当您访问以HTTPS开头的网站时,即表示正在使用CA.CA是Internet的重要组成部分.如果不存在CA,那么将无法安全在线购物以及使用网银在线业务等.什么是CA?CA具体是做什么的,又是如何确保您 ...
- ACboy needs your help (动态规划背包)
ACboy has N courses this term, and he plans to spend at most M days on study.Of course,the profit he ...
- java初探(1)之秒杀的业务简单实现
前言 秒杀的业务场景广泛存在于电商当中,即有一个倒计时的时间限制,当倒计时为0时,秒杀开始,秒杀之后持续很小的一段时间,而且秒杀的商品很少,因此会有大量的顾客进行购买,会产生很大的并发量,从而创造技术 ...
- C++ —— 输出100以内的质数
代码如下: #include<iostream> #include<math.h> using namespace std; int main() { int i; for(i ...