
spark StructType的应用,用在处理mongoDB keyvalue
近期在处理mongoDB 数据的时候,遇到了非常奇怪的格式,账号密码的日志都追加在一条记录里面,要取一个密码的时长和所有密码的平均时长就非常繁琐。
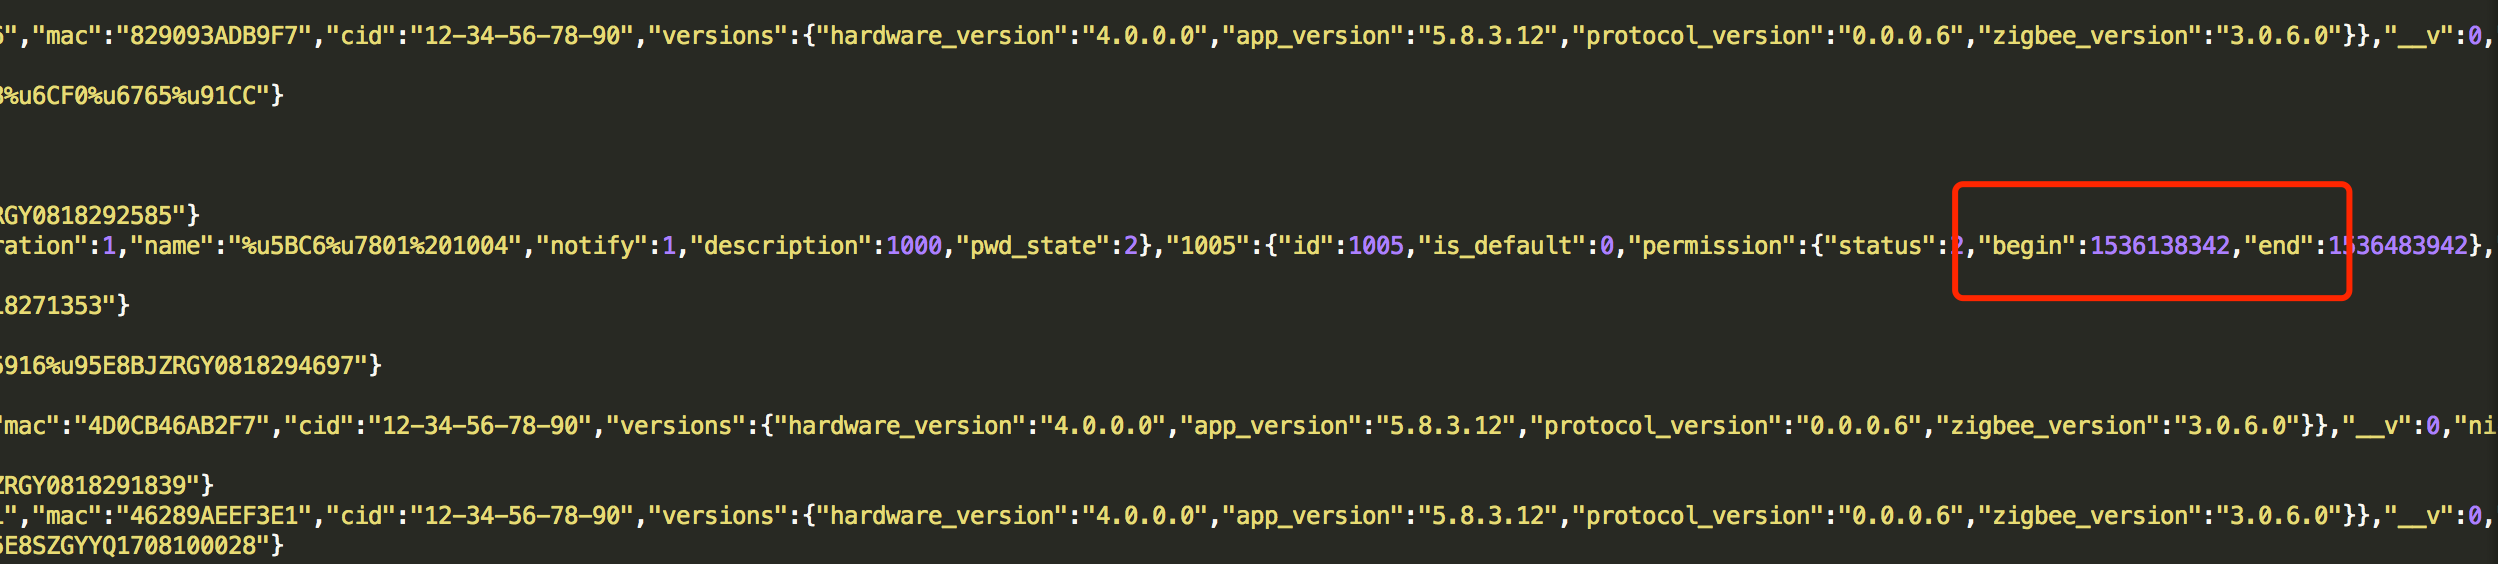
用了各种迭代计算,非常困难,而且printschema出来结构也是不规范的。
和同事一起研究后用了StructType 效率非常高。
代码如下:
import java.sql.{DriverManager, ResultSet}

import mongoDb_foundation_data20180913.url

import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.sql.types._

import org.apache.spark.sql.SparkSession

object devicests_20180916 {

 // spark-submit --driver-class-path /usr/local/jdk/lib/mysql-connector-java-5.1.46.jar  --class  "devicests_20180916"  /testdata/u3.jar

  val url = "jdbc:mysql://192.168.1.10:3306/saas?user=saas&password=saas2018"

  //val url = "jdbc:mysql://134.175.180.116:3306/saas?user=saas&password=saas2018"

  val conn = DriverManager.getConnection(url)

  def main(args: Array[String]): Unit = {

    val conn = DriverManager.getConnection(url)

    val conf = new SparkConf().setAppName("appName").setMaster("local")

    val sc = new SparkContext(conf)

    val spark = SparkSession.builder().appName("Spark SQL basic example").config("spark.debug.maxToStringFields", "200").getOrCreate()

    spark.sql("use saas")

    import spark.implicits._

    import org.apache.spark.sql.types._

    import org.apache.spark.sql.SparkSession

    val statement = conn.createStatement(ResultSet.TYPE_FORWARD_ONLY, ResultSet.CONCUR_UPDATABLE)

  //  val logData=spark.read.textFile("file:////mysqldata/aasdata/2018-08-17/devices_2018-08-17")

//    val log = spark.read.json(logData)

val prop = new java.util.Properties

//

//    log.createOrReplaceTempView("devicests_states")

//

//

//   // df.write.mode("append").jdbc(url, "saas.devicests_states", prop)

//import org.apache.calcite.adapter

    val schema = new StructType()

      .add("__v", StringType)

      .add("_id", new StructType()

        .add("$oid", StringType))

      .add("device_type", StringType)

      .add("hardware_info", new StructType()

        .add("cid", StringType)

        .add("mac", StringType)

        .add("sn", StringType)

        .add("versions", new StructType()

          .add("app_version", StringType)

          .add("hardware_version", StringType)

          .add("zigbee_version", StringType)))

      .add("model_id", StringType)

      .add("name", StringType)

      .add("nickname", StringType)

      .add("parent", StringType)

      .add("services", ArrayType(StringType))

      .add("states", new StructType()

        .add("onoff_line", StringType)

        .add("passwords",

          // spark 默认将 passwords 视为 struct,不便于使用 explode 和 map_values

          // 需要手动定义为 Map[String, Struct]

          MapType(StringType, new StructType()

            .add("description", StringType)

            .add("id", StringType)

            .add("is_default", StringType)

            .add("name", StringType)

            .add("permission", new StructType()

              .add("begin", StringType)

              .add("end", StringType)

              .add("status", StringType))

            .add("status", IntegerType)

            .add("time", StringType)))

        .add("power", StringType))

      .add("status", IntegerType)

      .add("time", StringType)

      .add("uuid", StringType)

    spark.read.schema(schema)

      .json(s"file:///mysqldata/aasdata/2018-09-12/devices_2018-09-12")

      .createOrReplaceTempView("devices")

    val res = spark.sql(

      """

        |SELECT uuid,

        |    COUNT(passwords.permission) AS count,

        |    AVG(passwords.permission.end - passwords.permission.begin) AS avg

        |FROM

        |    (

        |      SELECT uuid,explode(map_values(states.passwords)) AS passwords

        |      FROM devices

        |    )

        |WHERE

        |    passwords.permission.begin IS NOT NULL

        |    AND passwords.permission.end IS NOT NULL group by uuid""".stripMargin)//.collect.head

    res.write.mode("overwrite").jdbc(url, "saas.res_count_avg", prop)

////

////    val count = Long(res(0))

////    val avg = Double(res(1))

  }

}
spark StructType的应用,用在处理mongoDB keyvalue的更多相关文章
- Spark常用算子-KeyValue数据类型的算子
package com.test; import java.util.ArrayList; import java.util.List; import java.util.Map; import or ...
- 上万字详解Spark Core(建议收藏)
先来一个问题,也是面试中常问的: Spark为什么会流行? 原因1:优秀的数据模型和丰富计算抽象 Spark 产生之前,已经有MapReduce这类非常成熟的计算系统存在了,并提供了高层次的API(m ...
- MongoSpark 28799错误
Exception : . The full response is { , "codeName" : "Location28799" } at com.mon ...
- mongo-spark 安装排故 ./sbt check
[error] at com.mongodb.connection.CommandProtocol.execute(CommandProtocol.java:) [error] at com.mong ...
- 大数据才是未来,Oracle、SQL Server成昨日黄花?
1. 引子**** 有人在某个专注SQL的公众号留言如下: 这个留言触碰到一个非常敏感的问题:搞关系型数据库还有前途吗?现在都2020年了,区块链正火热,AI人才已经"过剩",大数 ...
- Storm 流式计算框架
1. 简介 是一个分布式, 高容错的 实时计算框架 Storm进程常驻内存, 永久运行 Storm数据不经过磁盘, 在内存中流转, 通过网络直接发送给下游 流式处理(streaming) 与 批处理( ...
- python爬虫知识点总结(一)库的安装
环境要求: 1.编程语言版本python3: 2.系统:win10; 3.浏览器:Chrome68.0.3440.75:(如果不是最新版有可能影响到程序执行) 4.chromedriver2.41 注 ...
- Update(Stage4):spark_rdd算子:第2节 RDD_action算子_分区_缓存:算子和分区
一.reduce和reduceByKey: 二.:RDD 的算子总结 RDD 的算子大部分都会生成一些专用的 RDD map, flatMap, filter 等算子会生成 MapPartitions ...
- spark读取mongodb数据写入hive表中
一 环境: spark-: hive-; scala-; hadoop--cdh-; jdk-1.8; mongodb-2.4.10; 二.数据情况: MongoDB数据格式{ "_i ...
随机推荐
- 【Newtonsoft.Json】自己实现JsonConverter ,精简返回的数据结果
Newtonsoft.Json的Json数据转换很好用,也提供了很多直接使用的类型
- FFT是个啥?
简单来说就是一个计算多项式乘法的东西呀.. 以下内容基本都是在大黑书<算法导论>上的.. 总述 对于项数为$n$的多项式$A(x)$和项数为$m$的多项式$B(x)$,可以如此表达: $$ ...
- 3ds max学习笔记(十六)-- 摄像机
摄像机添加以及应用技巧:可以更改观察的视点和空间广阔,模拟景深和运动模糊效果: 1,添加:更改观察的角度和位置,增加场景透视感: 基本操作: 景深:
- word2vec skip-gram系列2
Word2Vec的CBOW模型和Skip-gram模型 故事先从NNLM模型说起,网络结构图如下图所示,接下来先具体阐述下这个网络, 输入是个one-hot representation的向量.比如你 ...
- 小甲鱼Python第八讲课后习题
0. 下面的循环会打印多少次"I Love FishC"?
- SDN+DPI文献阅读
MultiClassifier: A combination of DPI and ML for application-layer classification in SDN 来源:Internat ...
- Win7或Win8上安装VS2015报“安装包丢失或损坏”问题的解决办法
原因:microsoft root certificate authority 2010.microsoft root certificate authority 2011证书未安装,导致文件校验未通 ...
- 什么?又是404!趣图助你理解HTTP状态码~
HTTP状态码(一): 注释: 301—永久移动.被请求的资源已被永久移动位置: 302—请求的资源现在临时从不同的 URI 响应请求: 305—使用代理.被请求的资源必须通过指定的代理才能被访问 ...
- JAVA项目中引用Logback的方法
一.简介 本文主要讲JAVA项目中引入Logback的方法. 二.解决 1.引入依赖. <!--Begin LogBack Log--> <!-- https://mvnreposi ...
- Substr与mb_substr区别
<?php $str = substr('helloword',3,4);//从下标3开始截取截取4个字符 $str = substr('helloword',3);//从截取掉前三个字符 ...