
elasticsearch kibana简单查询
kibana CRUD 操作页面
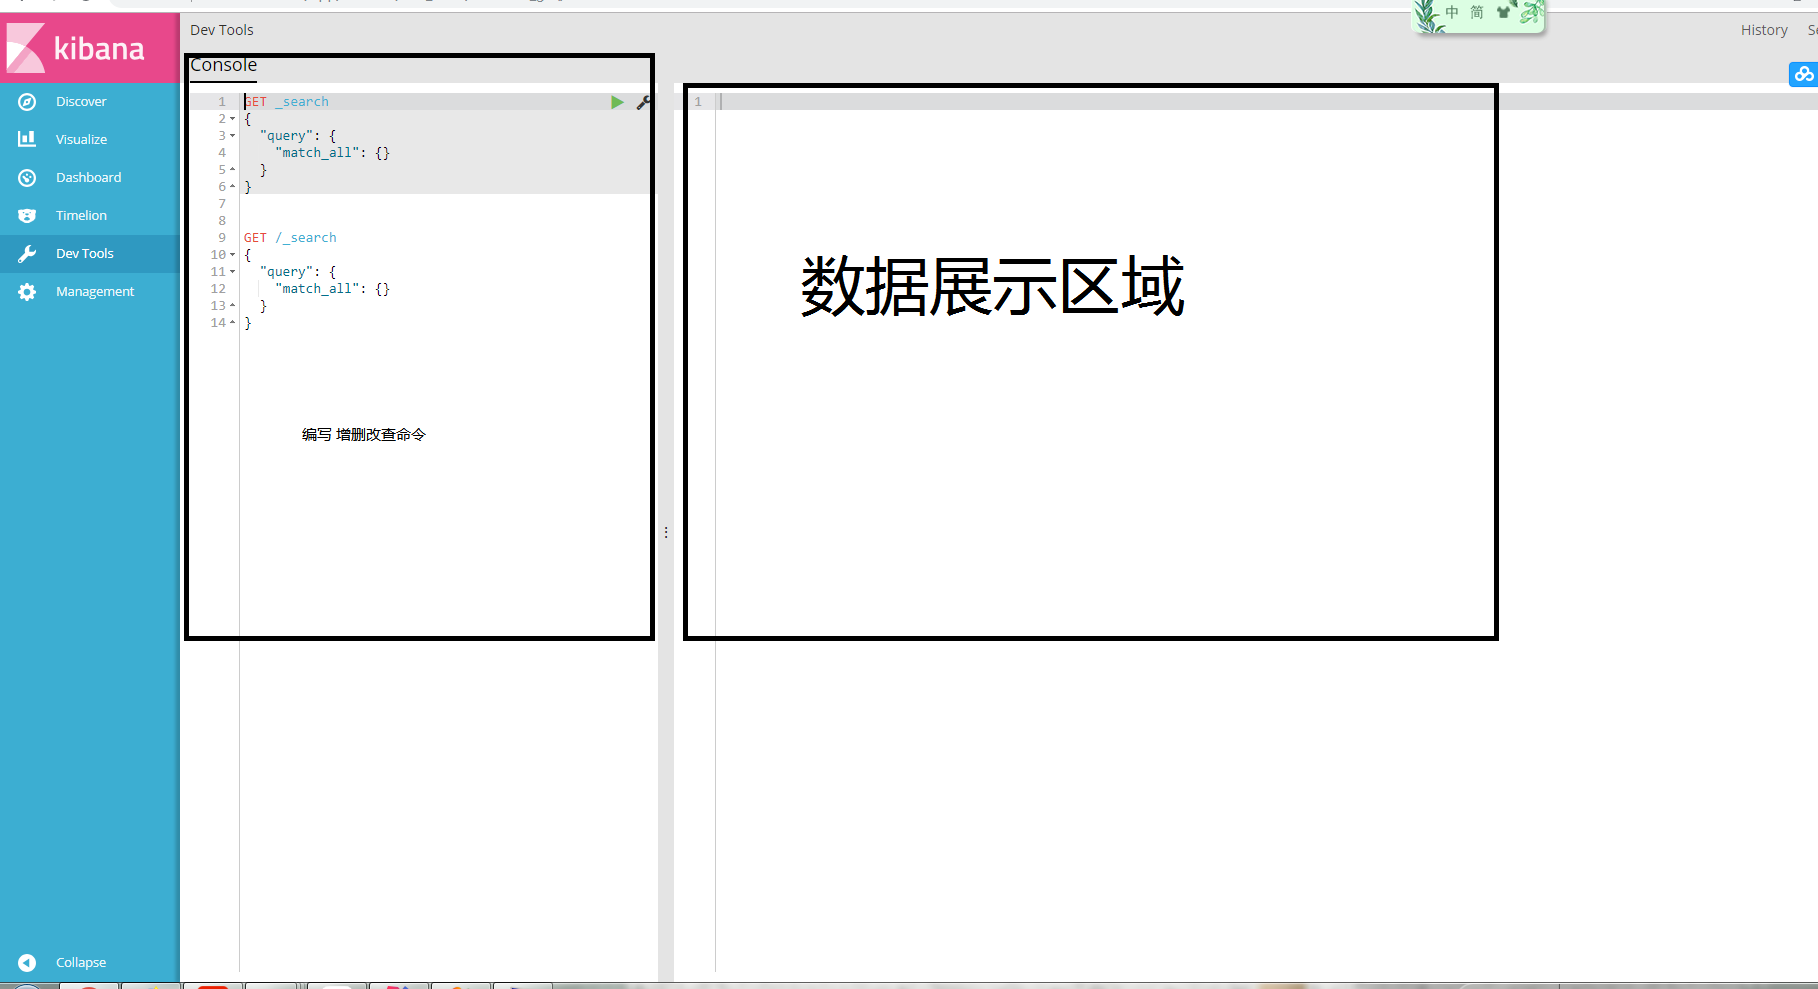
一、简单的CRUD操作
1、添加
PUT /index/type/id
{
"json数据"
}
2、查询
GET /index/type/id
3、修改
POST /index/type/id/_update
{
"doc": {
"FIELD": "值"
}
}
4、删除
DELETE /index/type/id
二、搜索 搜索可以分成六大类
1、query string search
2、query DSL
3、query filter
4、full-text search
5、phrase search
6、highlight search
1)query string search
搜索全部:GET supplier/user/_search
{
"took": 2,
"timed_out": false,
"_shards": {
"total": 5,
"successful": 5,
"failed": 0
},
"hits": {
"total": 3,
"max_score": 1,
"hits": [
{
"_index": "supplier",
"_type": "user",
"_id": "2",
"_score": 1,
"_source": {
"name": "lisi",
"age": 26,
"address": "bei jing tong zhou",
"price": 10000,
"dept": [
"kaifabu"
]
}
},
{
"_index": "supplier",
"_type": "user",
"_id": "1",
"_score": 1,
"_source": {
"name": "zhangsan",
"age": 30,
"address": "bei jing chang chun jie",
"price": 15000,
"dept": [
"kaifabu",
"yanfabu"
]
}
},
{
"_index": "supplier",
"_type": "user",
"_id": "3",
"_score": 1,
"_source": {
"name": "wangwu",
"age": 26,
"address": "bei jing tong zhou yun he ming zhu",
"price": 13000,
"dept": [
"kaifabu"
]
}
}
]
}
}
took:耗费了几毫秒
timed_out:是否超时,这里是没有
_shards:数据拆成了5个分片,所以对于搜索请求,会打到所有的primary shard(或者是它的某个replica shard也可以)
hits.total:查询结果的数量,3个document
hits.max_score:score的含义,就是document对于一个search的相关度的匹配分数,越相关,就越匹配,分数也高
hits.hits:包含了匹配搜索的document的详细数据
2、query DSL
查询所有
GET supplier/user/_search
{
"query": { "match_all": {} }
}
查询全部并且排序
GET suppluer/user/_search
{
"query": {
"match_all": {}
}
, "sort": [
{
"price": {
"order": "desc"
}
}
]
}
分页查询
GET supplier/user/_search
{
"query": { "match_all": {} },
"from": 1,
"size": 1
}
指定要查询显示的field
GET supplier/user/_search
{
"query": { "match_all": {} },
"_source": ["name", "price"]
}
3、query filter
搜索name为‘lisi’并且price大于1500的
GET supplier/user/_search
{
"query" : {
"bool" : {
"must" : {
"match" : {
"name" : "lisi"
}
},
"filter" : {
"range" : {
"price" : { "gt" : 1500}
}
}
}
}
}
4、full-text search(全文检索)
address这个字段,会先被拆解,建立倒排索引
GET /ecommerce/product/_search
{
"query" : {
"match" : {
"address" : "bei jing"
}
}
}
5、phrase search(短语搜索)
跟全文检索相对应,相反,全文检索会将输入的搜索串拆解开来,去倒排索引里面去一一匹配,只要能匹配上任意一个拆解后的单词,就可以作为结果返回
phrase search,要求输入的搜索串,必须在指定的字段文本中,完全包含一模一样的,才可以算匹配,才能作为结果返回
GET /ecommerce/product/_search
{
"query" : {
"match_phrase" : {
"address" : "bei jing"
}
}
}
6、highlight search(高亮搜索结果)
GET /ecommerce/product/_search
{
"query" : {
"match" : {
"address" : "bei jing"
}
},
"highlight": {
"fields" : {
"address" : {}
}
}
}
elasticsearch kibana简单查询的更多相关文章
- Elasticsearch——QueryBuilder简单查询
elasticsearch中存储的全部文档 1.matchAllQuery() matchAllQuery()方法用来匹配全部文档 public class QueryTest { pub ...
- Elasticsearch + Kibana 简单安装使用
1.资料来源官网,参考: https://www.elastic.co/cn/downloads/elasticsearch https://www.elastic.co/cn/downloads/k ...
- 使用kibana来进行ElasticSearch的信息查询检索
大家经常会听到使用ELK搭建日志管理平台.完成日志聚合检索的功能,那么这个平台到底是个什么概念,怎么搭建,怎么使用呢? ELK包括ElasticSearch(数据存储.快速查询).logstash(日 ...
- kibana和ElasticSearch的信息查询检索
使用kibana来进行ElasticSearch的信息查询检索 大家经常会听到使用ELK搭建日志管理平台.完成日志聚合检索的功能,那么这个平台到底是个什么概念,怎么搭建,怎么使用呢? ELK包括Ela ...
- Elasticsearch Kibana查询语法
Elasticsearch Kibana查询语法 2018年06月03日 23:52:30 wangpei1949 阅读数:3992 Elasticsearch Kibana Discover的搜 ...
- elasticsearch简单查询
elasticsearch简单查询示例: { "from": "0", //分页,从第一页开始 "size": "10" ...
- Springboot整合ElasticSearch进行简单的测试及用Kibana进行查看
一.前言 搜索引擎还是在电商项目.百度.还有技术博客中广泛应用,使用最多的还是ElasticSearch,Solr在大数据量下检索性能不如ElasticSearch.今天和大家一起搭建一下,小编是看完 ...
- ElasticSearch+Kibana 索引操作( 附源码)
一 前言 ElasticiSearch 简介 ElasticSearch是一个基于Lucene的搜索服务器.它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口.Elastics ...
- 分布式搜索引擎ElasticSearch+Kibana (Marvel插件安装详解)
在安装插件的过程中,尤其是安装Marvel插件遇到了很多问题,要下载license.Marvel-agent,又要下载安装Kibana 版本需求 Java 7 or later Elasticsear ...
随机推荐
- 一张图5分钟熟悉MarkDown的基本语法
看到zealer上面有介绍MarkDown的,以前在老罗的发布会也听说过,说锤子便签支持MarkDown,但是不知道有什么用,现在来看看,确实不错. MarkDown的好处是让你可以专注于写字本身,而 ...
- 2018年计科五班秋季C语言基础课第1次作业
---恢复内容开始--- 1.翻阅邹欣老师博客关于师生关系博客,并回答下列问题: (1)大学和高中最大的不同是没有人天天看着你,请看大学理想的师生关系是?有何感想? 答:我认为是邹欣老师说的健身教练 ...
- [GO]goexit的使用
package main import "fmt" func test() { defer fmt.Println("cccccccccccc")//在函数退出 ...
- 8) Struts2 2 SpringMVC
git@github.com:witaste/smse.git 数据库脚本: /* Navicat MySQL Data Transfer Source Server : 新服务器 Source Se ...
- Alpha冲刺(七)
Information: 队名:彳艮彳亍团队组长博客:戳我进入作业博客:班级博客本次作业的链接 Details: 组员1(组长)柯奇豪 过去两天完成了哪些任务 改用更易用的springboot+myb ...
- [LintCode笔记了解一下]41.Maximum Subarray
Given an array of integers, find a contiguous subarray which has the largest sum. 首先 當題目涉及到求最大最小值時,最 ...
- [转载]Java线程的两种实现方式
转载:http://baijiahao.baidu.com/s?id=1602265641578157555&wfr=spider&for=pc 前言 线程是程序的一条执行线索,执行路 ...
- 安装了IntelliJ IDEA中文输入法光标不跟随处理办法
安装了IntelliJ IDEA 2017.2.3版本发现搜狗输入法中文输入的时候光标不跟随,而且存在卡屏的现象,网上找了很多办法试了之后都不管用.最后在这里找到了解决方案,亲测可用! 首先,将IDE ...
- VCS简介
VCS -Version Control System 版本控制是一种记录一个或若干文件内容变化,以便将来查阅特定版本修订情况的系统. 特征 1.记录文件的所有历史变化 2.随时可恢复到任何一个历史状 ...
- oracle数据库sqlldr命令的使用
将数据导入 oracle 的方法应该很多 , 对于不同需求有不同的导入方式 , 最近使用oracle的sqlldr命令 导入数据库数据感觉是个挺不错的技术点 . 使用sqlldr命令 将文本文件导入 ...