
Python的scrapy之爬取豆瓣影评和排名
基于scrapy框架的爬影评
爬虫主程序:
import scrapy

from ..items import DoubanmovieItem

class MoviespiderSpider(scrapy.Spider):

    name = 'moviespider'

    allowed_domains = ['douban.com']

    start_urls = ['http://movie.douban.com/top250']

    def parse(self, response):

        movie_items=response.xpath('//div[@class="item"]')

        for item in movie_items:

            #print(type(item))

            movie =DoubanmovieItem()

            movie['rank']=item.xpath('div[@class="pic"]/em/text()').extract()

            movie['title']=item.xpath('div[@class="info"]/div[@class="hd"]/a/span[@class="title"][1]/text()').extract()

            movie['quote'] = item.xpath(

                'div[@class="info"]/div[@class="bd"]/p[@class="quote"]/span[@class="inq"][1]/text()').extract()

            movie['star'] = item.xpath(

                'div[@class="info"]/div[@class="bd"]/div[@class="star"]/span/text()').extract()

            movie['src']=item.xpath(

                'div[@class="pic"]/a/img/@src').extract()

            yield movie

            pass

        #取下一页的地址

        nextPageURL = response.xpath('//span[@class="next"]/a/@href').extract()

        #print(nextPageURL)

        if nextPageURL:

            url = response.urljoin(nextPageURL[-1])

            #print('url', url)

            # 发送下一页请求并调用parse()函数继续解析

            yield scrapy.Request(url, self.parse, dont_filter=False)

            pass

        else:

            print("退出")

        pass
items 对象
import scrapy

class DoubanmovieItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    rank=scrapy.Field()

    title=scrapy.Field()

    quote=scrapy.Field()

    star=scrapy.Field()

    src=scrapy.Field()

    pass
pipelines 输出管道
class DoubanmoviePipeline(object):

    def process_item(self, item, spider):

        print('电影排名:{0}'.format(item['rank'][0]))

        print('电影名称:{0}'.format(item['title'][0]))

        print('电影短评:{0}'.format(item['quote'][0]))

        print('评价分数:{0}'.format(item['star'][0]))

        print('评价人数:{0}'.format(item['star'][1]))
        print('图片链接:{0}'.format(item['src']))
        print('-' * 20)
return item
在控制台输出的结果
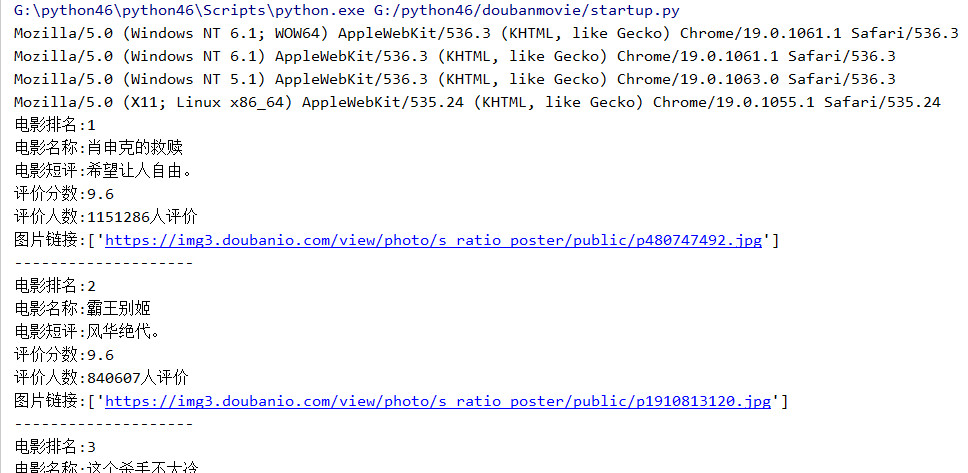
可以通过爬出的图片链接,下载电影的剧照,这就另说了,也可以设置一个插入数据库的管道,将这些数据插入到数据库中
Python的scrapy之爬取豆瓣影评和排名的更多相关文章
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- Scrapy 通过登录的方式爬取豆瓣影评数据
Scrapy 通过登录的方式爬取豆瓣影评数据 爬虫 Scrapy 豆瓣 Fly 由于需要爬取影评数据在来做分析,就选择了豆瓣影评来抓取数据,工具使用的是Scrapy工具来实现.scrapy工具使用起来 ...
- 【python数据挖掘】爬取豆瓣影评数据
概述: 爬取豆瓣影评数据步骤: 1.获取网页请求 2.解析获取的网页 3.提速数据 4.保存文件 源代码: # 1.导入需要的库 import urllib.request from bs4 impo ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- [超详细] Python3爬取豆瓣影评、去停用词、词云图、评论关键词绘图处理
爬取豆瓣电影<大侦探皮卡丘>的影评,并做词云图和关键词绘图第一步:找到评论的网页url.https://movie.douban.com/subject/26835471/comments ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- Python的scrapy之爬取顶点小说网的所有小说
闲来无事用Python的scrapy框架练练手,爬取顶点小说网的所有小说的详细信息. 看一下网页的构造: tr标签里面的 td 使我们所要爬取的信息 下面是我们要爬取的二级页面 小说的简介信息: 下面 ...
- python爬虫scrapy框架——爬取伯乐在线网站文章
一.前言 1. scrapy依赖包: 二.创建工程 1. 创建scrapy工程: scrapy staratproject ArticleSpider 2. 开始(创建)新的爬虫: cd Artic ...
随机推荐
- Ubuntu(Debian)apt-get
Ubuntu(Debian)的aptitude与apt-get的区别和联系 最近在使用Puppet快速部署Openstack,看到一些没见过的工具,例如aptitude,在Ubuntu上有强大的a ...
- CNN 和RNN 中input 长度不一致问题
转自:https://www.jianshu.com/p/86d667ee3c62,感谢分享! pad_sequences & Masking layer 上面提到,文本数据也可以用CNN来处 ...
- selendroid之inspector
http://selendroid.io/inspector.html 寻找元素.断点模式.
- (四)WebDriver常用方法
点击和输入 前面我们已经学习了定位元素, 定位只是第一步, 定位之后需要对这个元素进行操作, 或单击(按钮) 或输入(输入框) , 下面就来认识 WebDriver 中最常用的几个方法: clear( ...
- Oracle 通过undo块查看事务信息
数据库版本:Oracle 11.2.0.3 RAC 实验目的:通过undo块查看Oracle事务信息 实验细节:1 开始一个事务SQL> select * from t1; ID NAME--- ...
- Chrome,本地页面和插件
今天测试一款Chrome插件,这款插件提供了一些本地页面做测试用,在解决一些技术问题之后,在插件的官网上可以测试成功了,但是在本地页面上测试时Chrome始终会拦截插件,即使在右上角的地址栏中允许该本 ...
- JAVA程序员常用软件类库下载地址整理
IT行业是个发展更新特别快的领域,每个程序员在职业生涯中都会经历各类技术和工具的更新迭代. 俗话说:工欲善其事,必先利其器.本着独乐乐不如众乐乐的精神(其实是自己健忘)本人把经常要用到的软件工具官方下 ...
- 写一个简单的shellcode
0x00 前言 漏洞利用中必不可缺的部分就是shellcode,不会编写shellcode和咸鱼有什么区别,跳出咸鱼第一步. 0x01 系统调用 通过系统调用execve函数返回shell C语言实现 ...
- maven学习记录二——依赖管理
5 依赖管理 Jar包的管理 需求:整合struts2 页面上传一个客户id 跳转页面 5.1 添加依赖: 打开maven仓库的视图: 5.2 重建索引 1. 创建m ...
- jsp的4个作用域区别( pageScope、requestScope、sessionScope、applicationScope)
简单描述 page里的变量没法从index.jsp传递到test.jsp.只要页面跳转了,它们就不见了. request里的变量可以跨越forward前后的两页.但是只要刷新页面,它们就重新计算了. ...