
ubuntu之路——day10.2单一数字评估指标与满足和优化的评估指标
单一数字评估指标:
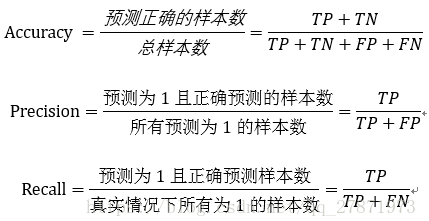
FP:错误地标记为正,即算法预测它是好西瓜,但这个西瓜真实情况是坏西瓜;
FN:错误地标记为负,即算法预测为坏西瓜,(F算法预测的不对)但这个西瓜真实情况是好西瓜(双重否定也是肯定);
TN:正确地标记为负,即算法标记为坏西瓜,(T算法预测的正确)这个西瓜真实情况是坏西瓜。
所以有:
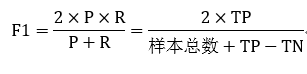

当beta>1时查全率重要,beta<1时查准率重要
以上关于精度、查准率、查全率的论述转自https://blog.csdn.net/qq_27871973/article/details/81065074 总结的很好所以我没有改动。
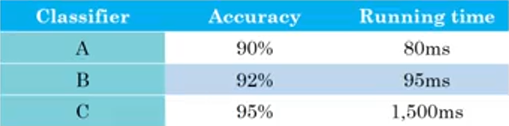
首先Accuracy也可以是上述单一数字评估指标中的任何一种,然后我们又得到了算法的时间性能running time。在这两种条件下如何综合衡量模型的好坏呢?
第一种方法:
线性叠加的思路:cost = Accuracy - 0.5Running time
当然这种线性加权求和的方式显得有些武断
第二种方法:
满足和优化的思路:cost = max(Accuracy) && Running time < 100
这种思路下,认为Accuracy是一种优化指标optimizing metric,同时Running time是一种满足指标satisficing metric,因为只要其满足了条件之后无论多好我们不再关注。
总结一下:当你有N个指标去考量的时候,通常选取其中的1种作为优化指标,剩下的N-1都是满足指标
ubuntu之路——day10.2单一数字评估指标与满足和优化的评估指标的更多相关文章
- ubuntu之路——day10.7 提高模型的表现
总结一下就是在提升偏差的方面(即贝叶斯最优误差和训练误差的差距) 1.尝试更大更深的网络 2.加入优化算法比如前面提过的momentum.RMSprop.Adam等 3.使用别的神经网络架构比如RNN ...
- ubuntu之路——day10.6 如何理解人类表现和超过人类表现
从某种角度来说,已知的人类最佳表现其实可以被当做贝叶斯最优错误,对于医学图像分类可以参见下图中的例子. 那么如何理解超过人类表现,在哪些领域机器已经做到了超越人类呢?
- ubuntu之路——day10.5 可避免偏差
可避免偏差: 总结一下就是当贝叶斯最优误差接近于训练误差的时候,比如下面的例子B,我们不会说我们的训练误差是8%,我们会说我可避免偏差是0.5%.
- ubuntu之路——day10.4 什么是人的表现
结合吴恩达老师前面的讲解,可以得出一个结论: 在机器学习的早期阶段,传统的机器学习算法在没有赶超人类能力的时候,很难比较这些经典算法的好坏.也许在不同的数据场景下,不同的ML算法有着不同的表现. 但是 ...
- ubuntu之路——day10.3 train/dev/test的划分、大小和指标更新
train/dev/test的划分 我们在前面的博文中已经提到了train/dev/test的相关做法.比如不能将dev和test混为一谈.同时要保证数据集的同分布等. 现在在train/dev/t ...
- ubuntu之路——day10.1 ML的整体策略——正交化
orthogonalization 正交化的概念就是指,将你可以调整的参数设置在不同的正交的维度上,调整其中一个参数,不会或几乎不会影响其他维度上的参数变化,这样在机器学习项目中,可以让你更容易更快速 ...
- [DeeplearningAI笔记]ML strategy_1_1正交化/单一数字评估指标
机器学习策略 ML strategy 觉得有用的话,欢迎一起讨论相互学习~Follow Me 1.1 什么是ML策略 机器学习策略简介 情景模拟 假设你正在训练一个分类器,你的系统已经达到了90%准确 ...
- Python之路,Day10 - 异步IO\数据库\队列\缓存
Python之路,Day9 - 异步IO\数据库\队列\缓存 本节内容 Gevent协程 Select\Poll\Epoll异步IO与事件驱动 Python连接Mysql数据库操作 RabbitM ...
- python之路-Day10
操作系统发展史介绍 进程.与线程区别 python GIL全局解释器锁 线程 语法 join 线程锁之Lock\Rlock\信号量 将线程变为守护进程 Event事件 queue队列 生产者消费者模型 ...
随机推荐
- MFC_选择目录对话框_选择文件对话框_指定目录遍历文件
选择目录对话框 void C资源共享吧视频广告清理工具Dlg::OnBnClickedCls() { // 清空编辑框内容 m_Edit.SetWindowTextW(L""); ...
- django learn step
django开发: 1 安装python环境 官网下载后安装 或者安装anacondaconda env list anaconda相关操作: 查看环境 conda env list 创建环境 con ...
- 跨服务器查询sql语句样例(转)
若2个数据库在同一台机器上: insert into DataBase_A..Table1(col1,col2,col3----) select col11,col22,col33-- from Da ...
- layui.table前端+后台处理+分页
前端 注:监听工具条没有详细写,但路子一样的 @section head{ <script src="~/Content/jquery-easyui-1.5.5.4/jquery.ea ...
- MyCAT+MySQL搭建高可用企业级数据库集群视频课程
原文地址:https://www.guangboyuan.cn/mycatmysql%E6%90%AD%E5%BB%BA%E9%AB%98%E5%8F%AF%E7%94%A8%E4%BC%81%E4% ...
- c# 计算目录的大小
- 自动网页截图并指定元素位置裁剪图片并保存到excel表格
# coding=utf-8 import os import time from selenium import webdriver from selenium.webdriver.chrome.o ...
- JQuery EasyUI treegrid展开与折叠,以及数据加载两次的问题
问题:做项目的时候遇到代码生成的页面,只默认展开了一级节点,每次操作之后刷新还要手动一级一级展开,太麻烦了 官方API:http://www.jeasyui.net/plugins/186.html ...
- 定时任务at
1. at一次性执行定时任务 1.1 at服务管理与访问控制 at命令要想正确执行,需要atd服务的支持.atd服务是独立的服务 [root@centos2 ~]# systemctl status ...
- CentOS 7.6最小化安装(系统盘和数据盘分离安装)
CentOS 7.6最小化安装(系统盘和数据盘分离安装) 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.创建虚拟机 鉴于大家使用的平台操作系统可能不尽相同,博主精力有限,仅演示 ...