
使用Spark进行搜狗日志分析实例——统计每个小时的搜索量
 package sogolog

 import org.apache.spark.rdd.RDD

 import org.apache.spark.{SparkConf, SparkContext}

 /**

   * 统计每小时搜索次数

   */

 /*

 搜狗日志示例

 访问时间(时:分:秒)    用户ID                [查询词]        该URL在返回结果中的排名    用户点击的顺序号    用户点击的URL

 00:00:00    2982199073774412    [360安全卫士]    8 3    download.it.com.cn/softweb/software/firewall/antivirus/20067/17938.html

 00:00:00    07594220010824798    [哄抢救灾物资]    1 1    news.21cn.com/social/daqian/2008/05/29/4777194_1.shtml

 00:00:00    5228056822071097    [75810部队]    14 5    www.greatoo.com/greatoo_cn/list.asp?link_id=276&title=%BE%DE%C2%D6%D0%C2%CE%C5

 00:00:00    6140463203615646    [绳艺]    62 36    www.jd-cd.com/jd_opus/xx/200607/706.html

 */

 object CountByHours {

   def main(args: Array[String]): Unit = {

     //1、启动spark上下文、读取文件

     val conf = new SparkConf().setAppName("sougo count by hours").setMaster("local")

     val sc = new SparkContext(conf)

     var orgRdd = sc.textFile("C:\\Users\\KING\\Desktop\\SogouQ.reduced\\SogouQ.reduced")

     println("总行数:"+orgRdd.count())

     //2、map操作,遍历处理每一行数据

     var map:RDD[(String,Integer)] = orgRdd.map(line=>{

         //拿到小时

         var h:String = line.substring(0,2)

         (h,1)

     })

     //3、reduce操作,将上面的 map结果按KEY进行合并、叠加

     var reduce:RDD[(String,Integer)] = map.reduceByKey((x,y)=>{

       x+y

     })

     //打印出按小时排序后的统计结果

     reduce.sortByKey().collect().map(println)

   }

 }
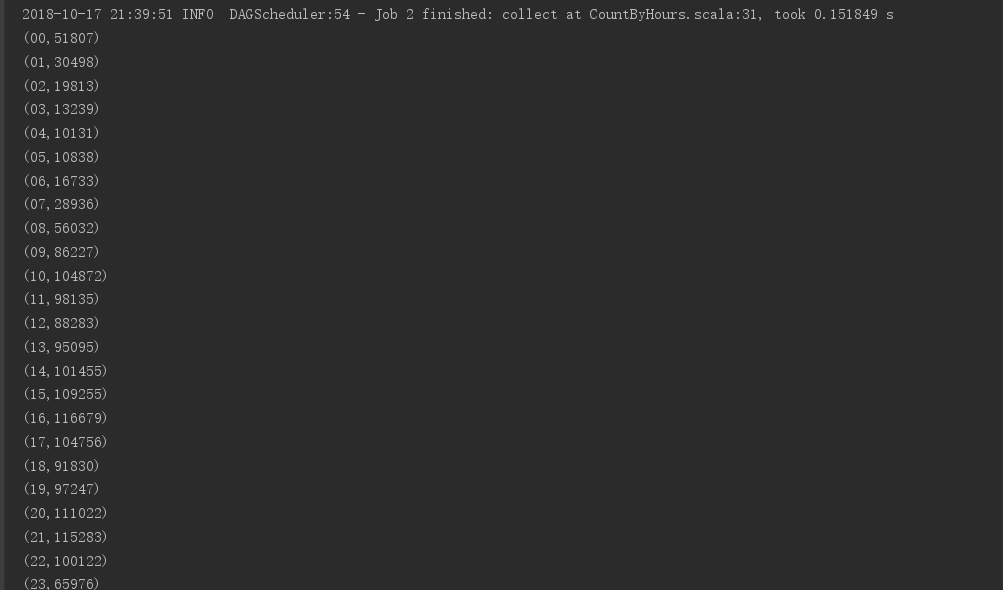
运行结果:
搜狗日志下载地址:http://www.sogou.com/labs/resource/q.php
使用Spark进行搜狗日志分析实例——统计每个小时的搜索量的更多相关文章
- 使用Spark进行搜狗日志分析实例——map join的使用
map join相对reduce join来说,可以减少在shuff阶段的网络传输,从而提高效率,所以大表与小表关联时,尽量将小表数据先用广播变量导入内存,后面各个executor都可以直接使用 pa ...
- 使用Spark进行搜狗日志分析实例——列出搜索不同关键词超过10个的用户及其搜索的关键词
package sogolog import org.apache.hadoop.io.{LongWritable, Text} import org.apache.hadoop.mapred.Tex ...
- ELK 日志分析实例
ELK 日志分析实例一.ELK-web日志分析二.ELK-MySQL 慢查询日志分析三.ELK-SSH登陆日志分析四.ELK-vsftpd 日志分析 一.ELK-web日志分析 通过logstash ...
- 基于Spark的网站日志分析
本文只展示核心代码,完整代码见文末链接. Web Log Analysis 提取需要的log信息,包括time, traffic, ip, web address 进一步解析第一步获得的log信息,如 ...
- Spark之搜狗日志查询实战
1.下载搜狗日志文件: 地址:http://www.sogou.com/labs/resource/chkreg.php 2.利用WinSCP等工具将文件上传至集群. 3.创建文件夹,存放数据: mk ...
- 日志分析-mime统计
提取日志中未落入标准字段的mime,分adx,adtype 统计mime的数量和包含js的数量占比 require 'date' require 'net/http' require 'uri' re ...
- spark提交异常日志分析
java.lang.NoSuchMethodError: org.apache.spark.sql.SQLContext.sql(Ljava/lang/String;)Lorg/apache/spar ...
- nginx日志分析及其统计PV、UV、IP
一.nginx日志结构 nginx中access.log 的日志结构: $remote_addr 客户端地址 211.28.65.253 $remote_user 客户端用户名称 -- $time_l ...
- 日志分析_统计每日各时段的的PV,UV
第一步: 需求分析 需要哪些字段(时间:每一天,各个时段,id,url,guid,tracTime) 需要分区为天/时 PV(统计记录数) UV(guid去重) 第二步: 实施步骤 建Hive表,表列 ...
随机推荐
- JAVA学习过程的基础笔记
1.JDK的安装与环境变量的设置与测试2.STS简单使用3.CMD控制器的使用4.JAVA的编译与反编译的执行过程5.一,变量与变量的使用 1.变量是在程序运行中其值可以改变的量,java程序的一个基 ...
- Mysql 通用知识 2019-03-27
充电mysql 官网 https://www.mysql.com/ 以上是mysql的产品线,多数是收费的.只有社区版是免费的. 所以下面只说社区版community. MySQL Community ...
- C++ 基本数据类型,常量,变量
基本数据类型 整数类型 基本的整数类型(int) 按符号分 符号的 (signed) 无符号的(unsigned) 按照数据范围分 短整数(short) 长整数(long) 长长整数(long lon ...
- Redis(二)--Jedis使用
1.Jedis是连接java和redis的jar,这里用maven来添加jar包 # 在eclipse中新建maven project,填写GroupID.Artifactid # 在百度搜索mave ...
- 'ascii' codec can't decode byte 0xe5 in position 10: ordinal not in range(128)
python2.7 向Excel中写入数据中含有中文就一直报错 'ascii' codec can't decode byte 0xe5 in position 10: ordinal not in ...
- nameode启动过程
namenode在内存和磁盘中都保存了fsimage和edits文件 内存中保证hdfs文件系统的访问效率,磁盘中保证hdfs文件系统的安全性 namenode的文件组成: fsimage文件:保存文 ...
- [record]WebLogic域之创建-文本界面
WebLogic域的创建方式主要有图形界面.文本方式(字符界面).脚本方式(WLST脚本)等,本文用文本方式来创建域. 一.启动Configuration Wizard •config.cmd/con ...
- windows服务器安全管理工具——IISCrypto
官方网站地址:https://www.nartac.com/Products/IISCrypto/ 下载地址:https://www.nartac.com/Products/IISCrypto/Dow ...
- kafka producer batch 发送消息
1. 使用 KafkaProducer 发送消息,是按 batch 发送的,producer 首先把消息放入 ProducerBatch 中: org.apache.kafka.clients.pro ...
- Eclipse无法正常启动,弹出对话框内容为 A Java Runtime...
1.Eclipse无法正常启动,弹出对话框内容为 A Java Runtime...如下图: 原因分析:由于软件版本的更新或者安装其他开发软件无意之间修改了配置文件中的路径,众所周知,Java虚拟机( ...