
Spark之搜狗日志查询实战
1、下载搜狗日志文件:
地址:http://www.sogou.com/labs/resource/chkreg.php
2、利用WinSCP等工具将文件上传至集群。
3、创建文件夹,存放数据:
mkdir /home/usr/hadoopdata
4、将搜狗日志数据移到(mv命令)3中创建的目录下,并解压
tar -zxvf SogouQ.mini.tar.gz
5、查看解压后文件格式
file SogouQ.sample
显示:
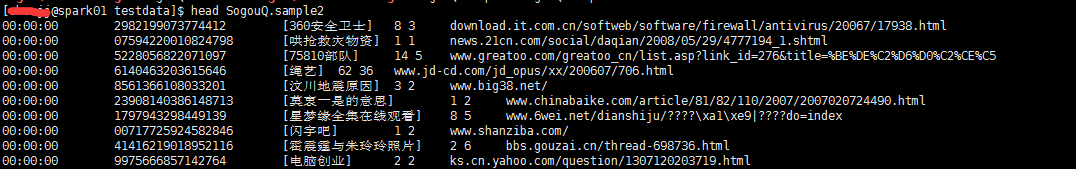
不是UTF-8,用head/cat命名查看,中文乱码(影响后续进程),需对文件格式进行转换:
iconv -f gb2312 SogouQ.sample -o SogouQ.sample2
再次查看即可正常显示中文。
6、启动集群(Hadoop、spark)。启动后,进入hadoop安装目录下,在hdfs上新建存放数据的目录,并将5中已进行格式转换后的日志文件放到hdfs上,再查看文件是否上传成功,命令如下:
cd /home/usr/hadoop/hadoop-2.8.

hadoop fs -mkdir /sogoumini

hadoop fs -put /home/chenjj/hadoopdata/testdata/SogouQ.sample2 /sogoumini

hadoop fs -ls /sogoumini/SogouQ.sample2
结果:

7、进入spark安装目录下bin,启动spark-shell,由于本集群采用yarn模式部署的,故启动时选取yarn,其他参数可自行配置。
cd spark/spark-2.1.-bin-hadoop2./bin

./spark-shell --master yarn --executor-memory 2g --driver-memory 2g
8、进入spark-shell后,执行以下操作,在每句后面有说明
val path="hdfs:///sogoumini/SogouQ.sample2"——声明路径

val sogouminirdd=sc.textFile(path)——读取hdfs上搜狗日志文件

sogouminirdd.count()——查看文件总共多少条记录

val mapsogouminirdd=sogouminirdd.map(_.split("\\s")).filter(_.length==)——筛选出格式正确的数据

mapsogouminirdd.count()——查看格式正确的有多少条,是否所有数据均正确

val firstmapsogouminirdd=mapsogouminirdd.filter(_().toInt==).filter(_().toInt==)——筛选出当日搜索结果排名第一同时点击结果排名也是第一的数据量

firstmapsogouminirdd.count()——查看结果是第多少条数据
注:(1) 元数据文件格式和官网描述不一致问题,官方说明排名和用户点击的顺序号之间是以Tab键分隔的,而实际是以空格分隔。
解决方法: spark分词时用split("\\s")代替split("\t"))。
9、使用toDebugString查看RDD血统(lineage)
firstmapsogouminirdd.toDebugString
结果如下:
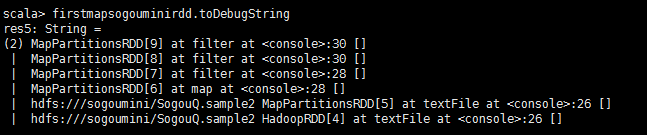
可见其血统关系是:HadoopRDD->MappedRDD->MappedRDD->FilteredRDD->FilteredRDD->FilteredRDD。
10、用户ID查询次数排行榜:
val sortrdd=mapsogouminirdd.map(x=>(x(),)).reduceByKey(_+_).map(x=>(x._2,x._1)).sortByKey(false).map(x=>(x._2,x._1))
sortrdd.count()
11、将结果存放在hdfs中:
val outputpath="hdfs:///sogoumini/SogouQresult.txt"——存放路径及文件名

sortrdd.saveAsTextFile(outputpath)——存结果
Spark之搜狗日志查询实战的更多相关文章
- 使用Spark进行搜狗日志分析实例——统计每个小时的搜索量
package sogolog import org.apache.spark.rdd.RDD import org.apache.spark.{SparkConf, SparkContext} /* ...
- 使用Spark进行搜狗日志分析实例——map join的使用
map join相对reduce join来说,可以减少在shuff阶段的网络传输,从而提高效率,所以大表与小表关联时,尽量将小表数据先用广播变量导入内存,后面各个executor都可以直接使用 pa ...
- 使用Spark进行搜狗日志分析实例——列出搜索不同关键词超过10个的用户及其搜索的关键词
package sogolog import org.apache.hadoop.io.{LongWritable, Text} import org.apache.hadoop.mapred.Tex ...
- Spark RDD/Core 编程 API入门系列之动手实战和调试Spark文件操作、动手实战操作搜狗日志文件、搜狗日志文件深入实战(二)
1.动手实战和调试Spark文件操作 这里,我以指定executor-memory参数的方式,启动spark-shell. 启动hadoop集群 spark@SparkSingleNode:/usr/ ...
- 《图解Spark:核心技术与案例实战》介绍及书附资源
本书中所使用到的测试数据.代码和安装包放在百度盘提供 下载 ,地址为https://pan.baidu.com/s/1o8ydtKA 密码:imaa 另外在百度盘提供本书附录 下载 ,地址为http ...
- 《图解Spark:核心技术与案例实战》作者经验谈
1,看您有维护博客,还利用业余时间著书,在技术输出.自我提升以及本职工作的时间利用上您有没有什么心得和大家分享?(也可以包含一些您写书的小故事.)回答:在工作之余能够写博客.著书主要对技术的坚持和热爱 ...
- Spark Streaming 进阶与案例实战
Spark Streaming 进阶与案例实战 1.带状态的算子: UpdateStateByKey 2.实战:计算到目前位置累积出现的单词个数写入到MySql中 1.create table CRE ...
- 日志检索实战 grep sed
日志检索实战 grep sed 参考 sed命令 使用 grep -5 'parttern' inputfile //打印匹配行的前后5行 grep -C 5 'parttern' inputfile ...
- Spark SQL知识点大全与实战
Spark SQL概述 1.什么是Spark SQL Spark SQL是Spark用于结构化数据(structured data)处理的Spark模块. 与基本的Spark RDD API不同,Sp ...
随机推荐
- Hat’s Words
Hat’s Words Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Total ...
- JS模块化-requireJS
1. 为什么要使用require.js 刚开始的时候,网页需要用到很多不同的插件,都是依次加载,需要注意其中的加载顺序即依赖关系. <script src="1.js"> ...
- Python 判断是否为质数或素数
一个大于1的自然数,除了1和它本身外,不能被其他自然数(质数)整除(2, 3, 5, 7等),换句话说就是该数除了1和它本身以外不再有其他的因数. 首先我们来第一个传统的判断思路: def handl ...
- java中的缓冲流BufferedWriter和BufferedReader
java中的缓冲流有BufferedWriter和BufferedReader 在java api 手册中这样说缓冲流: 从字符输入流中读取文本,缓冲各个字符,从而实现字符.数组和行的高效读取.可以指 ...
- ldap数据库--ODSEE--复制协议
简单介绍一下ODSEE的复制拓扑的建立,复制协议可以通过管理界面进行创建,也可以通过命令行创建.在此之前需要了解一些复制协议的相关概念,这里针对OESEE. 1,复制角色 master(提供者,也可以 ...
- 将非常规Json字符串转换为常用的json对象
如下所示,这是一个已经转换为Json对象的非常规Json字符串,原来是一个Json类型的字符串,在转换为Json对象时,查询资料发现有两种转换法,.parse()和.eval()方法,但是前辈们都极其 ...
- 为JS内置对象添加常用方法
1.字符串全部替换: String.prototype.replaceAll = function(s1,s2){ return this.replace(new RegExp(s1,"gm ...
- 初识Java网络编程
事实上网络编程简单的理解就是两台计算机相互通讯数据而已,对于程序员而言,去掌握一种编程接口并使用一种编程模型相对就会显得简单的多了,Java SDK提供一些相对简单的Api来完成这些工作.Socket ...
- 熊掌号:"搜索+信息流"双引擎与"百家号+熊掌号"双品牌内容平台
一. 熊掌号是什么?熊掌号简单来说,就是"搜索 + 信息流"双引擎与"百家号 + 熊掌号"双品牌内容平台,上线了,对站长还是企业,都是一件好事.只要写出优质的原 ...
- 【功能代码】---2.patchca生成验证码
Java使用patchca生成验证码 Patchca是Piotr Piastucki写的一个java验证码开源库,打包成jar文件发布,patchca使用简单但功能强大. 本例实现了自定 ...