
使用Spark进行搜狗日志分析实例——列出搜索不同关键词超过10个的用户及其搜索的关键词
 package sogolog

 import org.apache.hadoop.io.{LongWritable, Text}

 import org.apache.hadoop.mapred.TextInputFormat

 import org.apache.spark.rdd.RDD

 import org.apache.spark.{SparkConf, SparkContext}

 class RddFile {

   def readFileToRdd(path: String): RDD[String] = {

     val conf = new SparkConf().setMaster("local").setAppName("sougoDemo")

     val sc = new SparkContext(conf);

     //使用这种方法能够避免中文乱码

     sc.hadoopFile("J:\\scala\\workspace\\first-spark-demo\\sougofile\\SogouQ.reduced",classOf[TextInputFormat], classOf[LongWritable], classOf[Text]).map{

       pair =>  new String(pair._2.getBytes, 0, pair._2.getLength, "GBK")}

   }

 }
 package sogolog

 import org.apache.spark.rdd.RDD

 /**

   * 列出搜索不同关键词超过3个的用户及其搜索的关键词

   */

 object userSearchKeyWordLT3 {

   def main(args: Array[String]): Unit = {

     //1、读入文件

     val textFile = new RddFile().readFileToRdd("J:\\scala\\workspace\\first-spark-demo\\sougofile\\SogouQ.reduced")

     //2、map操作,将每行的用户、关键词读入新的RDD中

     val userKeyWordTuple:RDD[(String,String)] = textFile.map(line=>{

       val arr = line.split("\t")

       (arr(1),arr(2))

     })

     //3、reduce操作,将相同用户的关键词进行合并

     val userKeyWordReduced = userKeyWordTuple.reduceByKey((x,y)=>{

       //去重

       if(x.contains(y)){

         x

       }else{

         x+","+y

       }

     })

     //4、使用filter进行最终过滤

     val finalResult = userKeyWordReduced.filter(x=>{

       //过滤小于10个关键词的用户

       x._2.split(",").length>=10

     })

     //5、打印出结果

     finalResult.collect().foreach(println)

   }

 }
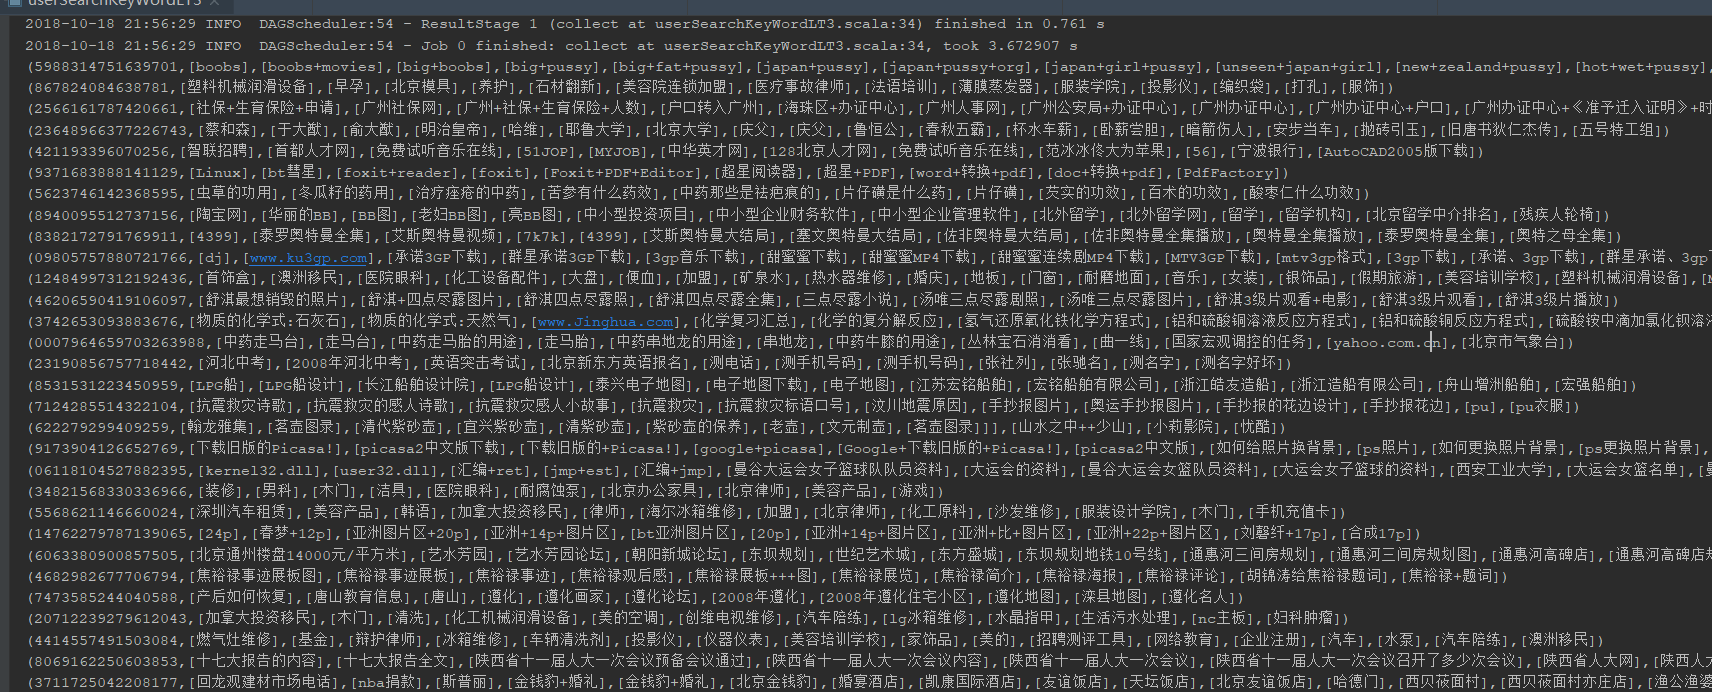
运行结果:
使用Spark进行搜狗日志分析实例——列出搜索不同关键词超过10个的用户及其搜索的关键词的更多相关文章
- 使用Spark进行搜狗日志分析实例——统计每个小时的搜索量
package sogolog import org.apache.spark.rdd.RDD import org.apache.spark.{SparkConf, SparkContext} /* ...
- 使用Spark进行搜狗日志分析实例——map join的使用
map join相对reduce join来说,可以减少在shuff阶段的网络传输,从而提高效率,所以大表与小表关联时,尽量将小表数据先用广播变量导入内存,后面各个executor都可以直接使用 pa ...
- ELK 日志分析实例
ELK 日志分析实例一.ELK-web日志分析二.ELK-MySQL 慢查询日志分析三.ELK-SSH登陆日志分析四.ELK-vsftpd 日志分析 一.ELK-web日志分析 通过logstash ...
- Spark之搜狗日志查询实战
1.下载搜狗日志文件: 地址:http://www.sogou.com/labs/resource/chkreg.php 2.利用WinSCP等工具将文件上传至集群. 3.创建文件夹,存放数据: mk ...
- 基于Spark的网站日志分析
本文只展示核心代码,完整代码见文末链接. Web Log Analysis 提取需要的log信息,包括time, traffic, ip, web address 进一步解析第一步获得的log信息,如 ...
- spark提交异常日志分析
java.lang.NoSuchMethodError: org.apache.spark.sql.SQLContext.sql(Ljava/lang/String;)Lorg/apache/spar ...
- (转载)shell日志分析常用命令
shell日志分析常用命令总结 时间:2016-03-09 15:55:29来源:网络 导读:shell日志分析的常用命令,用于日志分析的shell脚本,统计日志中百度蜘蛛的抓取量.抓取最多的页面.抓 ...
- Spark RDD/Core 编程 API入门系列之动手实战和调试Spark文件操作、动手实战操作搜狗日志文件、搜狗日志文件深入实战(二)
1.动手实战和调试Spark文件操作 这里,我以指定executor-memory参数的方式,启动spark-shell. 启动hadoop集群 spark@SparkSingleNode:/usr/ ...
- [spark案例学习] WEB日志分析
数据准备 数据下载:美国宇航局肯尼迪航天中心WEB日志 我们先来看看数据:首先将日志加载到RDD,并显示出前20行(默认). import sys import os log_file_path =' ...
随机推荐
- bzoj3527: [Zjoi2014]力 fft
bzoj3527: [Zjoi2014]力 fft 链接 bzoj 思路 但是我们求得是 \(\sum\limits _{i<j} \frac{q_i}{(i-j)^2}-\sum_{i> ...
- fiddler -- 一个强大的抓包工具
一.fiddler常用功能: 1. Fiddler 是位于客户端和服务器端的http代理,也是目前最常用的http抓包工具之一.它能够记录客户端和服务器之间的所有http请求,可以针对特定的http请 ...
- 第 9 章 数据管理 - 074 - 如何安装和配置 Rex-Ray?
Rex-Ray 安装和配置方法 Rex-Ray 是一个优秀的 Docker volume driver 安装和配置方法 Rex-Ray 以 standalone 进程的方式运行在 Docker 主机上 ...
- PHP常用工具类
<?php namespace isslib\Util; use think\Config; /** * 常用工具类 * User: xaxiong * Date: 2016/12/19 * T ...
- EM公式推导
纯手写,字很丑,人也很丑.. E步公式是怎么来的呢?推导步骤如下, EM算法核心思想是先给定初始θ,求样本X,和隐变量z的期望(实际上是个函数),可以画一个曲线,M步:然后不断滑动θ,找到使得期望最大 ...
- QSS 记录
1.border-style 属性分别有 none 定义无边框. hidden 与 "none" 相同.不过应用于表时除外,对于表,hidden 用于解决边框冲突. dotted ...
- JSP介绍
1.JSP简介 JSP全名为Java Server Pages,中文名叫java服务器页面,其根本是一个简化的Servlet设计,它是由Sun Microsystems公司倡导.许多公司参与一起建立的 ...
- es索引管理工具-curator
elasticsearch-curator 是官方收购的开源社区周边产品,用来管理es的索引和快照. 官方文档:https://www.elastic.co/guide/en/elasticsear ...
- 用node+webpack+vue新建vue项目步骤
1. 安装node,命令行输入node-v命令查看是否安装成功. 2. 安装vue:npm install vue-cli -g(全局安装). 3. 在想要创建vue项目的目录下,按住shift+右键 ...
- wpf 实现 css3 中 boxshadow inset 效果
using System; using System.Linq; using System.Windows; using System.Windows.Controls; using System.W ...