
吴裕雄--天生自然python爬虫:使用requests模块的get和post方式抓取中国旅游网站和有道翻译网站翻译内容数据
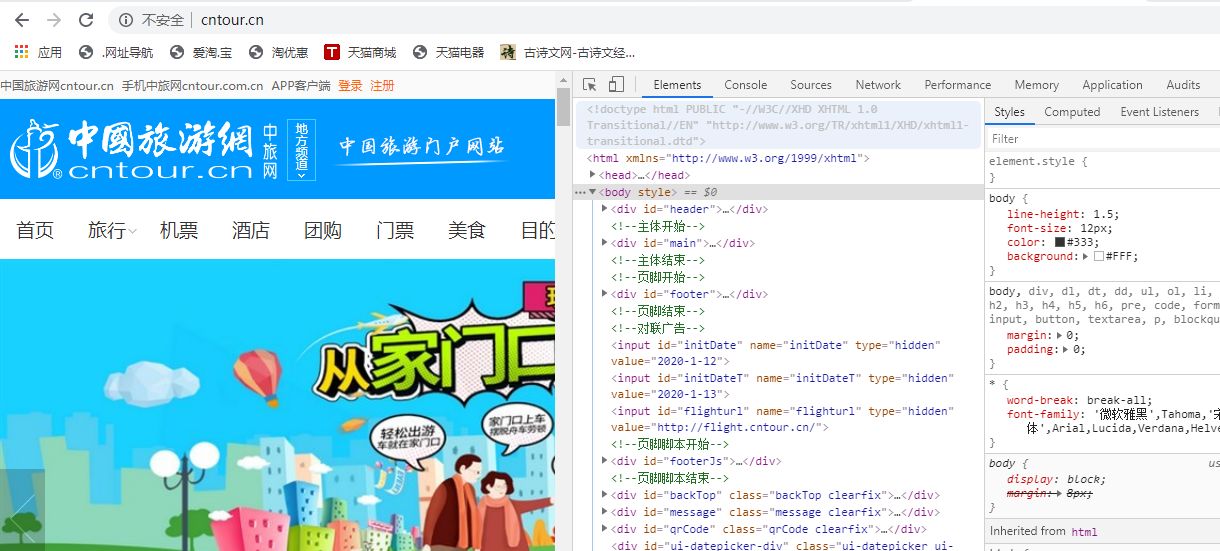
import requests

url = 'http://www.cntour.cn/'

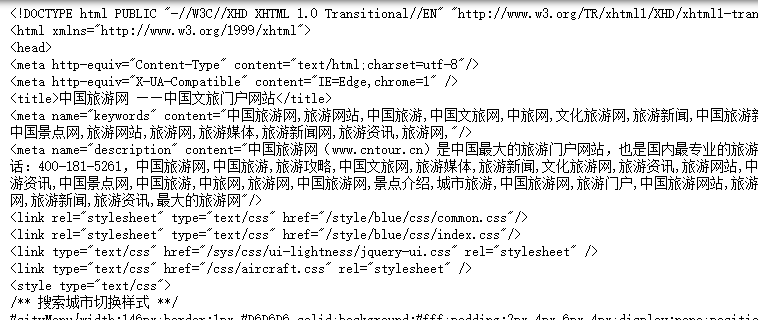
strhtml = requests.get(url)

print(strhtml.text)
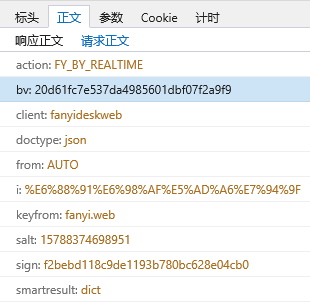
URL='http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule'

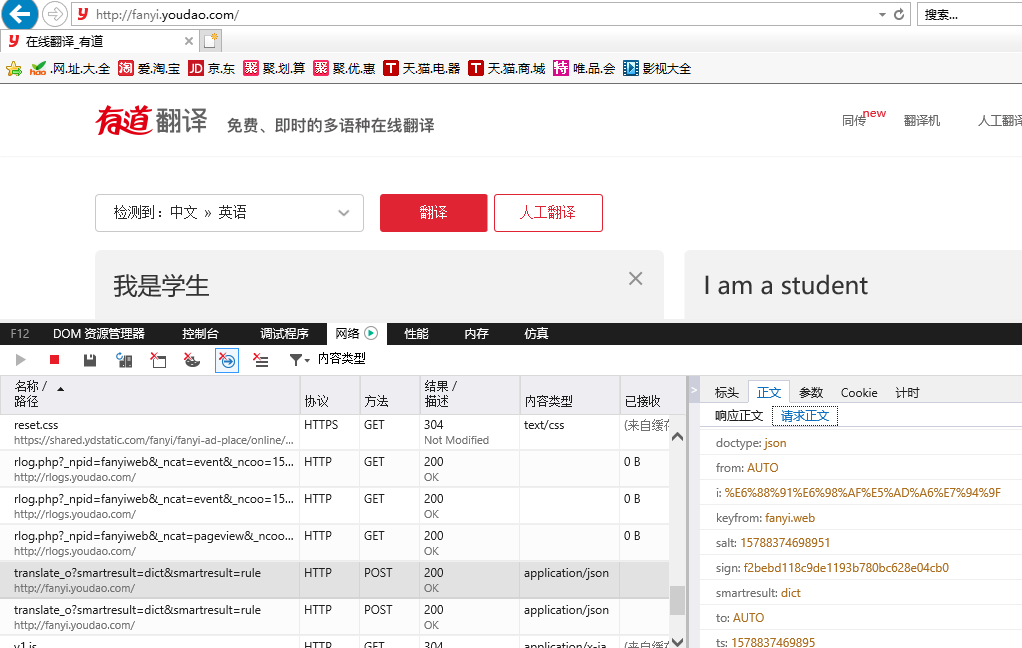
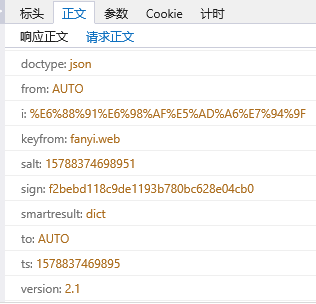
#post请求需要写请求访问,请求内容可以在对应网页的开发者模式中获取,谷歌浏览器显示不出来,我使用的是IE浏览器

Form_data = {

    'action': 'FY_BY_REALTlME',

    'bv': '20d61fc7e537da4985601dbf07f2a9f9',

    'client': 'fanyideskweb',

    'doctype': 'json',

    'from': 'AUTO',

    'i': '我是学生',

    'keyfrom': 'fanyi.web',

    'salt': '',

    'sign': 'f2bebd118c9de1193b780bc628e04cb0',

    'smartresult': 'dict',

    'to': 'AUTO',

    'ts': '',

    'version': '2.1'

}

import requests

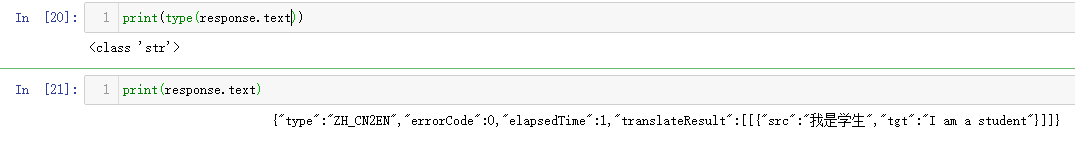
response = requests.post(URL,data=Form_data)
import json

import requests

def get_translate_date(word=None):

    url='http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule'

    Form_data = {'i':word, 'from':'AUTO','to': 'AUTO','smartresult': 'dict', 'client':'fanyideskweb',

                    'salt':'','sign':'78181ebbdcb38de9b4a3f4cd1d38816b','doctype':'json',

                    'version': '2.1','keyfrom':'fanyi.web','action':'FY_BY_CLICKBUTTION','typoResult':'false'}

    response = requests.post(url, data=Form_data)                # 请求表单数据

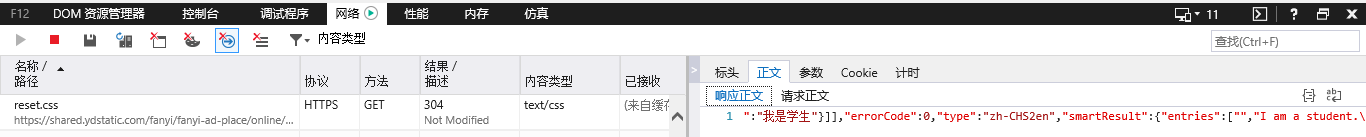
    print(response.text)

    content = json.loads(response.text)                  # 将JSON格式字符串转字典

    print(content['translateResult'][0][0]['tgt'])             # 打印翻译后的数据

if __name__ == '__main__':

    get_translate_date('我爱数据')

吴裕雄--天生自然python爬虫:使用requests模块的get和post方式抓取中国旅游网站和有道翻译网站翻译内容数据的更多相关文章
- 吴裕雄--天生自然PYTHON爬虫:使用Selenium爬取大型电商网站数据
用python爬取动态网页时,普通的requests,urllib2无法实现.例如有些网站点击下一页时,会加载新的内容,但是网页的URL却没有改变(没有传入页码相关的参数),requests.urll ...
- 吴裕雄--天生自然PYTHON爬虫:使用Scrapy抓取股票行情
Scrapy框架它能够帮助提升爬虫的效率,从而更好地实现爬虫.Scrapy是一个为了抓取网页数据.提取结构性数据而编写的应用框架,该框架是封装的,包含request异步调度和处理.下载器(多线程的Do ...
- 吴裕雄--天生自然PYTHON爬虫:爬虫攻防战
我们在开发者模式下不仅可以找到URL.Form Data,还可以在Request headers 中构造浏览器的请求头,封装自己.服务器识别浏览器访问的方法就是判断keywor是否为Request h ...
- 吴裕雄--天生自然PYTHON爬虫:安装配置MongoDBy和爬取天气数据并清洗保存到MongoDB中
1.下载MongoDB 官网下载:https://www.mongodb.com/download-center#community 上面这张图选择第二个按钮 上面这张图直接Next 把bin路径添加 ...
- 吴裕雄--天生自然PYTHON爬虫:爬取某一大型电商网站的商品数据(效率优化以及代码容错处理)
这篇博文主要是对我的这篇https://www.cnblogs.com/tszr/p/12198054.html爬虫效率的优化,目的是为了提高爬虫效率. 可以根据出发地同时调用多个CPU,每个CPU运 ...
- 吴裕雄--天生自然PYTHON爬虫:用API爬出天气预报信息
天气预报网址:https://id.heweather.com/,这个网站是需要注册获取一个个人认证后台密钥key的,并且每个人都有访问次数的限制,这个key就是访问API的钥匙. 这个key现在是要 ...
- 吴裕雄--天生自然PYTHON爬虫:使用BeautifulSoup解析中国旅游网页数据
import requests from bs4 import BeautifulSoup url = "http://www.cntour.cn/" strhtml = requ ...
- 吴裕雄--天生自然python编程:turtle模块绘图(3)
turtle(海龟)是Python重要的标准库之一,它能够进行基本的图形绘制.turtle图形绘制的概念诞生于1969年,成功应用于LOGO编程语言. turtle库绘制图形有一个基本框架:一个小海龟 ...
- 吴裕雄--天生自然python编程:turtle模块绘图(1)
Turtle库是Python语言中一个很流行的绘制图像的函数库,想象一个小乌龟,在一个横轴为x.纵轴为y的坐标系原点,(0,0)位置开始,它根据一组函数指令的控制,在这个平面坐标系中移动,从而在它爬行 ...
随机推荐
- React项目中遇到的那些坑
1.react中路由跳转后页面不置顶问题 问题: 从页面A跳转到页面B,页面A滚动到中间位置,跳转后页面B也会在中间位置 解决方法:在顶部组件的生命周期中进行判断,例如 componentWillRe ...
- Git 安装配置及工作流程
在使用Git前我们需要先安装 Git.Git 目前支持 Linux/Unix.Solaris.Mac和 Windows 平台上运行. Git 各平台安装包下载地址为:http://git-scm.co ...
- VBA 学习笔记 - 消息框
学习资料:https://www.yiibai.com/vba/vba_macro_comments.html 注释 单引号或 REM 开头 丸子:多行注释咋办? 消息框(MsgBox) 函数功能:显 ...
- 理解Linux内核注释
内核是Linux的心脏,它是在引导时装入的程序,用来提供用户层程序和硬件之间的接口,执行发生在多任务系统中的实际任务转换,处理读写磁盘的需求,处理网络接口,以及管理内存.一般情况下,自动安装的内核无需 ...
- 《Web安全攻防 渗透测试实战指南》 学习笔记 (四)
Web安全攻防 渗透测试实战指南 学习笔记 (四) Nmap Network Mapper 是一款开放源代码的网 ...
- left join 、right join 和inner join之间的区别
SQL的left join .right join 和inner join之间的区别 left join(左联接) 返回包括左表中的所有记录和右表中联结字段相等的记录 right join(右联接) ...
- JavaScript 对象数字键特性实现桶排序
桶排序: 对象中,数字键按照升序排列.依据这一特性将数组的值作为对象的键和值存入对象实现排序 因为对象的键不重复,因此不支持数组有重复元素存在的排序场景,也可以看作是实现数组的去重排序 functio ...
- Java IO流详解(二)——File类
在上一章博客中简单的介绍了Java IO流的一些特征.也就是对文件的输入输出,既然至始至终都离不开文件,所以Java IO流的使用得从File这个类讲起. File类的描述:File类是文件和目录路径 ...
- Update(Stage4):sparksql:第5节 SparkSQL_出租车利用率分析案例
目录: 1. 业务2. 流程分析3. 数据读取5. 数据清洗6. 行政区信息 6.1. 需求介绍 6.2. 工具介绍 6.3. 具体实现7. 会话统计 导读 本项目是 SparkSQL 阶段的练习项目 ...
- iOS 根据域名查询 IP 地址
在 iOS 开发中,如果需要知道网站的 IP 地址: #include <netdb.h> #include <arpa/inet.h> NSString *webSiteSt ...