
Python之爬虫(十八) Scrapy框架中Item Pipeline用法
当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理
每个item pipeline组件是实现了简单的方法的python类,负责接收到item并通过它执行一些行为,同时也决定此Item是否继续通过pipeline,或者被丢弃而不再进行处理
item pipeline的主要作用:
- 清理html数据
- 验证爬取的数据
- 去重并丢弃
- 讲爬取的结果保存到数据库中或文件中
编写自己的item pipeline
process_item(self,item,spider)
每个item piple组件是一个独立的pyhton类,必须实现以process_item(self,item,spider)方法
每个item pipeline组件都需要调用该方法,这个方法必须返回一个具有数据的dict,或者item对象,或者抛出DropItem异常,被丢弃的item将不会被之后的pipeline组件所处理
下面的方法也可以选择实现
open_spider(self,spider)
表示当spider被开启的时候调用这个方法
close_spider(self,spider)
当spider挂去年比时候这个方法被调用
from_crawler(cls,crawler)
这个和我们在前面说spider的时候的用法是一样的,可以用于获取settings配置文件中的信息,需要注意的这个是一个类方法,用法例子如下:
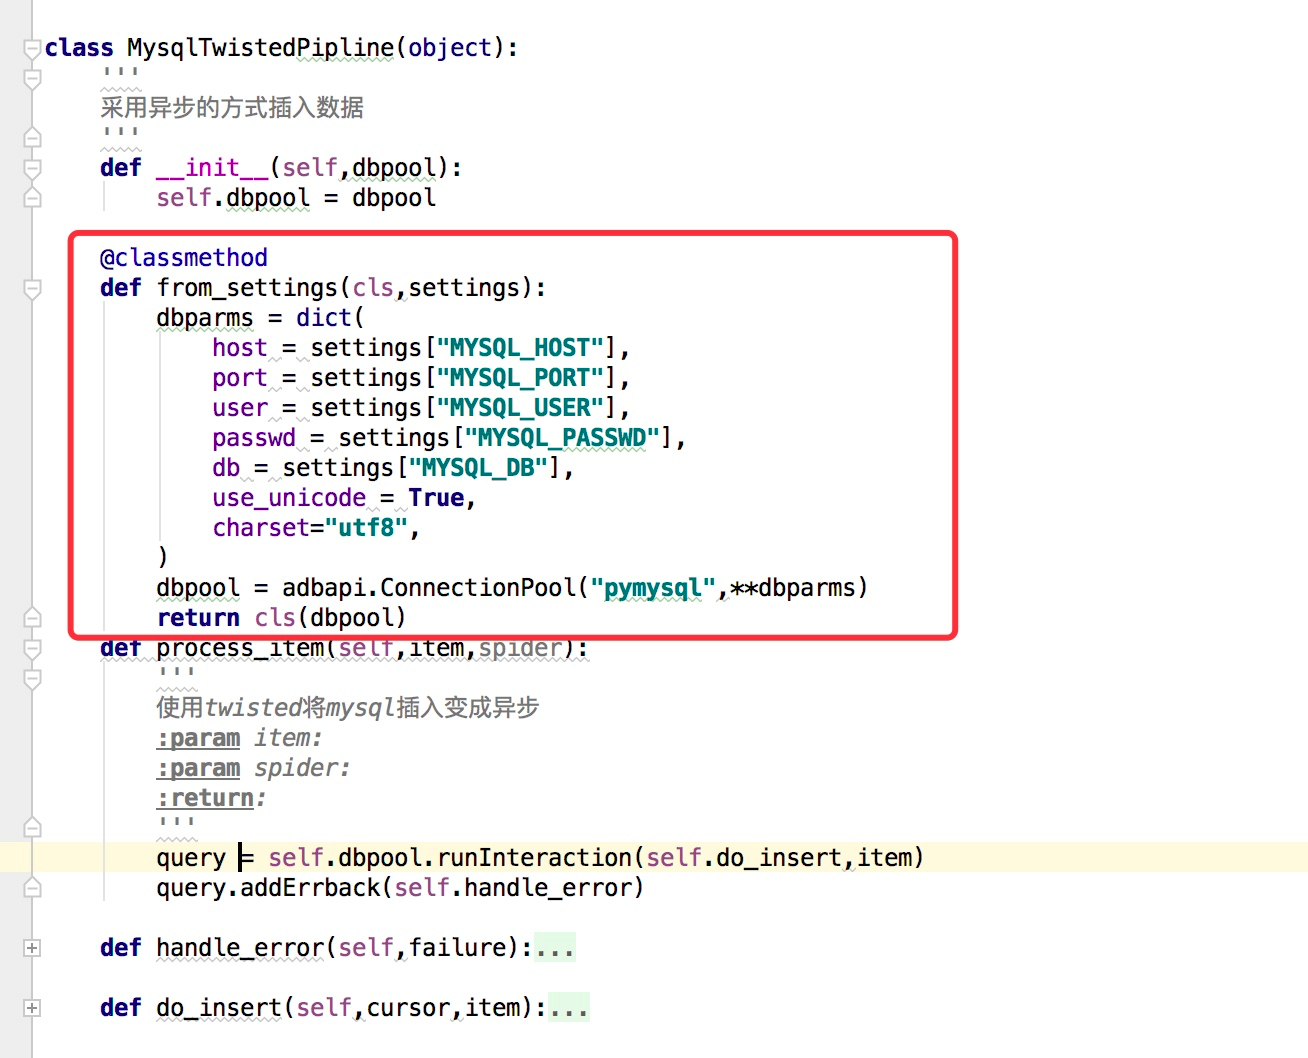
一些item pipeline的使用例子(官网说明)
例子1
这个例子实现的是判断item中是否包含price以及price_excludes_vat,如果存在则调整了price属性,都让item['price'] = item['price'] * self.vat_factor,如果不存在则返回DropItem
from scrapy.exceptions import DropItem

class PricePipeline(object):

    vat_factor = 1.15

    def process_item(self, item, spider):

        if item['price']:

            if item['price_excludes_vat']:

                item['price'] = item['price'] * self.vat_factor

            return item

        else:

            raise DropItem("Missing price in %s" % item)
例子2
这个例子是将item写入到json文件中
import json

class JsonWriterPipeline(object):

    def __init__(self):

        self.file = open('items.jl', 'wb')

    def process_item(self, item, spider):

        line = json.dumps(dict(item)) + "\n"

        self.file.write(line)

        return item
例子3
将item写入到MongoDB,同时这里演示了from_crawler的用法
import pymongo

class MongoPipeline(object):

    collection_name = 'scrapy_items'

    def __init__(self, mongo_uri, mongo_db):

        self.mongo_uri = mongo_uri

        self.mongo_db = mongo_db

    @classmethod

    def from_crawler(cls, crawler):

        return cls(

            mongo_uri=crawler.settings.get('MONGO_URI'),

            mongo_db=crawler.settings.get('MONGO_DATABASE', 'items')

        )

    def open_spider(self, spider):

        self.client = pymongo.MongoClient(self.mongo_uri)

        self.db = self.client[self.mongo_db]

    def close_spider(self, spider):

        self.client.close()

    def process_item(self, item, spider):

        self.db[self.collection_name].insert(dict(item))

        return item
例子4:去重
一个用于去重的过滤器,丢弃那些已经被处理过的item,假设item有一个唯一的id,但是我们spider返回的多个item中包含了相同的id,去重方法如下:这里初始化了一个集合,每次判断id是否在集合中已经存在,从而做到去重的功能
from scrapy.exceptions import DropItem

class DuplicatesPipeline(object):

    def __init__(self):

        self.ids_seen = set()

    def process_item(self, item, spider):

        if item['id'] in self.ids_seen:

            raise DropItem("Duplicate item found: %s" % item)

        else:

            self.ids_seen.add(item['id'])

            return item
启用一个item Pipeline组件
在settings配置文件中y9ou一个ITEM_PIPELINES的配置参数,例子如下:
ITEM_PIPELINES = {

    'myproject.pipelines.PricePipeline': 300,

    'myproject.pipelines.JsonWriterPipeline': 800,

}
每个pipeline后面有一个数值,这个数组的范围是0-1000,这个数值确定了他们的运行顺序,数字越小越优先
Python之爬虫(十八) Scrapy框架中Item Pipeline用法的更多相关文章
- scrapy框架中Item Pipeline用法
scrapy框架中item pipeline用法 当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的pyt ...
- Python爬虫从入门到放弃(十六)之 Scrapy框架中Item Pipeline用法
当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的python类,负责接收到item并通过它执行一些行为, ...
- 6-----Scrapy框架中Item Pipeline用法
当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的python类,负责接收到item并通过它执行一些行为, ...
- Scrapy框架中选择器的用法【转】
Python爬虫从入门到放弃(十四)之 Scrapy框架中选择器的用法 请给作者点赞 --> 原文链接 Scrapy提取数据有自己的一套机制,被称作选择器(selectors),通过特定的Xpa ...
- scrapy框架中Download Middleware用法
scrapy框架中Download Middleware用法 Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给sp ...
- scrapy框架中选择器的用法
scrapy框架中选择器的用法 Scrapy提取数据有自己的一套机制,被称作选择器(selectors),通过特定的Xpath或者CSS表达式来选择HTML文件的某个部分Xpath是专门在XML文件中 ...
- PYTHON网络爬虫与信息提取[scrapy框架应用](单元十、十一)
scrapy 常用命令 startproject 创建一个新的工程 scrapy startproject <name>[dir] genspider 创建一个爬虫 ...
- 转:十八、java中this的用法
http://blog.csdn.net/liujun13579/article/details/7732443 我知道很多朋友都和我一样:在JAVA程序中似乎经常见到“this”,自己也偶尔用到它, ...
- Python之爬虫(十九) Scrapy框架中Download Middleware用法
这篇文章中写了常用的下载中间件的用法和例子.Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给spiders的时候,所以 ...
随机推荐
- loadrunner安装负载机
1,安装docker 2,下载最新版本的load_generator镜像,命令如下: docker pull hpsoftware/load_generator 3,load_generator镜像实 ...
- node实现文件属性批量修改(时间属性)
前言 在默认情况下,一个文件的创建时间和修改时间是系统自己设定的,我们不能修改该的.但我们有时为了某种特殊需要,为了不让别人一眼看出文件已经给修改了,我们又需要修改文件的创建时间和修改时间.那么如何修 ...
- MySQL5.7.X 的下载和安装
1 MySQL的下载 这里是mysql5.7.30的版本下载地址 https://dev.mysql.com/downloads/mysql/5.7.html#downloads 根据自己电脑选择合适 ...
- 多语言工作者の十日冲刺<7/10>
这个作业属于哪个课程 软件工程 (福州大学至诚学院 - 计算机工程系) 这个作业要求在哪里 团队作业第五次--Alpha冲刺 这个作业的目标 团队进行Alpha冲刺--第七天(05.06) 作业正文 ...
- gatewayworker 安装 pcntl 扩展
安装其它扩展也是如此. 第一步,查看php版本: /phpstudy/server/php/bin/php -v 第二步,下载扩展文件: http://php.net/releases/ 这里面寻找 ...
- SpringBoot--使用Spring Cache整合redis
一.简介 Spring Cache是Spring对缓存的封装,适用于 EHCache.Redis.Guava等缓存技术. 二.作用 主要是可以使用注解的方式来处理缓存,例如,我们使用redis缓存时, ...
- jQuery创建表格并实现删除
利用jQuery创建一个简单的表格,并添加一个简单的删除按钮 <!DOCTYPE html> <html lang="en"> <head> & ...
- centos6.4 卸载 vim7.2 安装vim7.4
一.# rpm -qa|grep vim vim-minimal-7.2.-1.8.el6.x86_64 vim-enhanced-7.2.-1.8.el6.x86_64 vim-common-7.2 ...
- suprious weakup
线程wait情况下,有可能没有中断,没有唤醒,而返回, 称为spurious wakeup. wait在循环中,通过对condition的判断来决定是否继续wait. 概率比较低.
- Sass简单、快速上手_Sass快速入门学习笔记总结
Sass是世界上最成熟.稳定和强大的专业级css扩展语言 ,除了Sass是css的一种预处理器语言,类似的语言还有Less,Stylus等. 这篇文章关于Sass快速入门学习笔记. 资源网站大全 ht ...