
使用scrapy爬虫,爬取今日头条搜索吉林疫苗新闻(scrapy+selenium+PhantomJS)
这一阵子吉林疫苗案,备受大家关注,索性使用爬虫来爬取今日头条搜索吉林疫苗的新闻
依然使用三件套(scrapy+selenium+PhantomJS)来爬取新闻
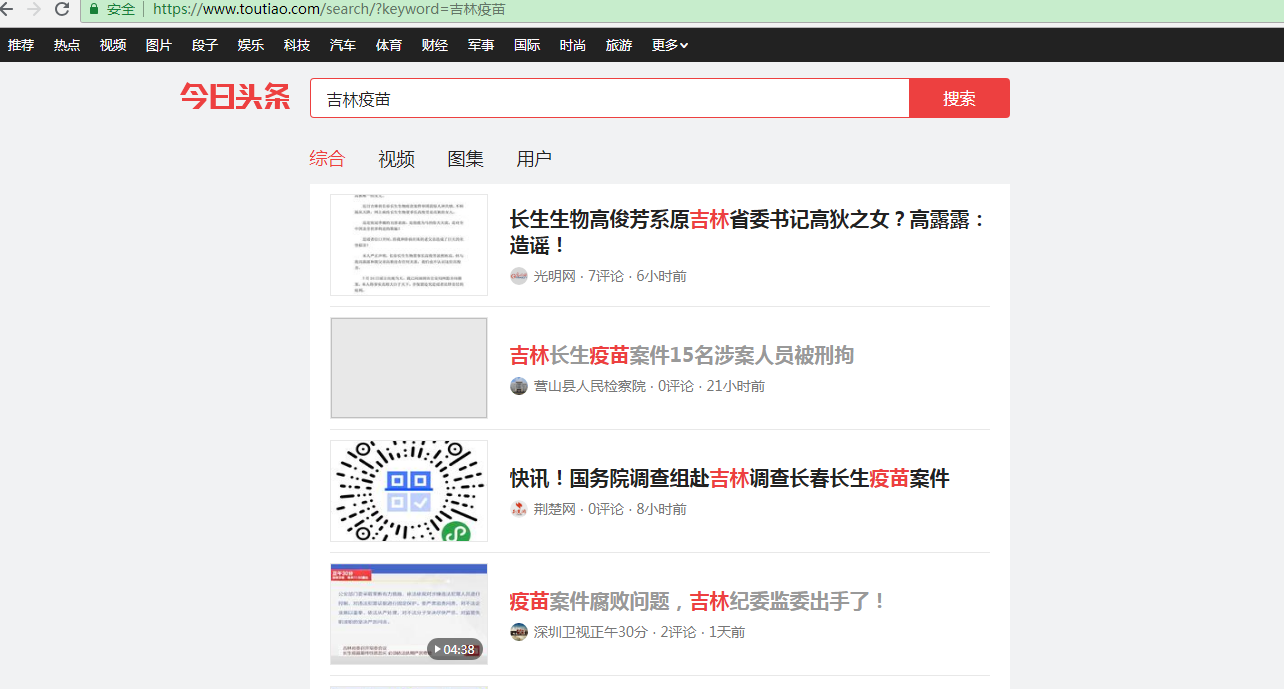
以下是搜索页面,得到吉林疫苗的搜索信息,里面包含了新闻信息和视频信息
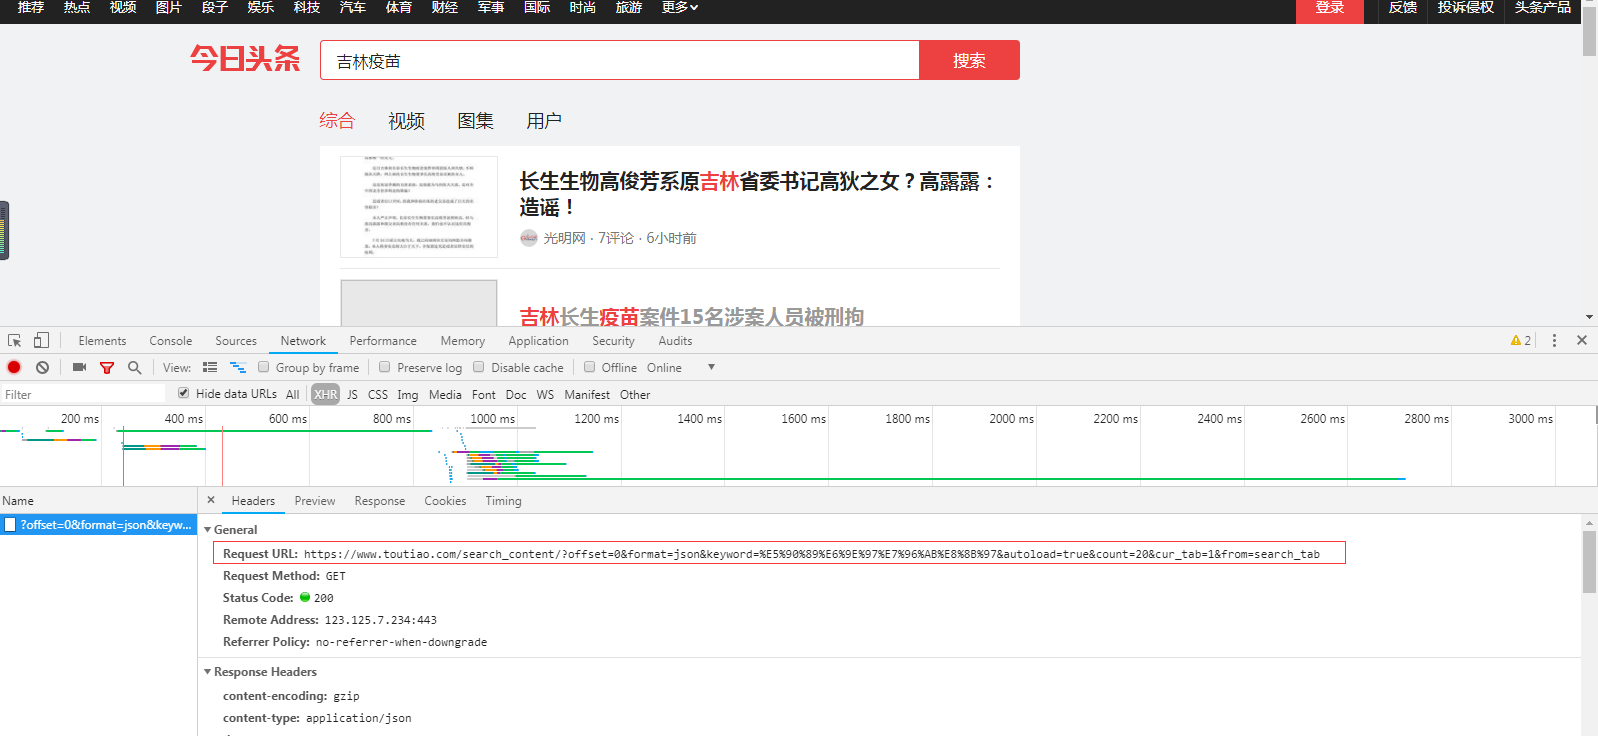
通过F12中network得到了接口url信息:https://www.toutiao.com/search_content/?offset=0&format=json&keyword=%E5%90%89%E6%9E%97%E7%96%AB%E8%8B%97&autoload=true&count=20&cur_tab=1&from=search_tab
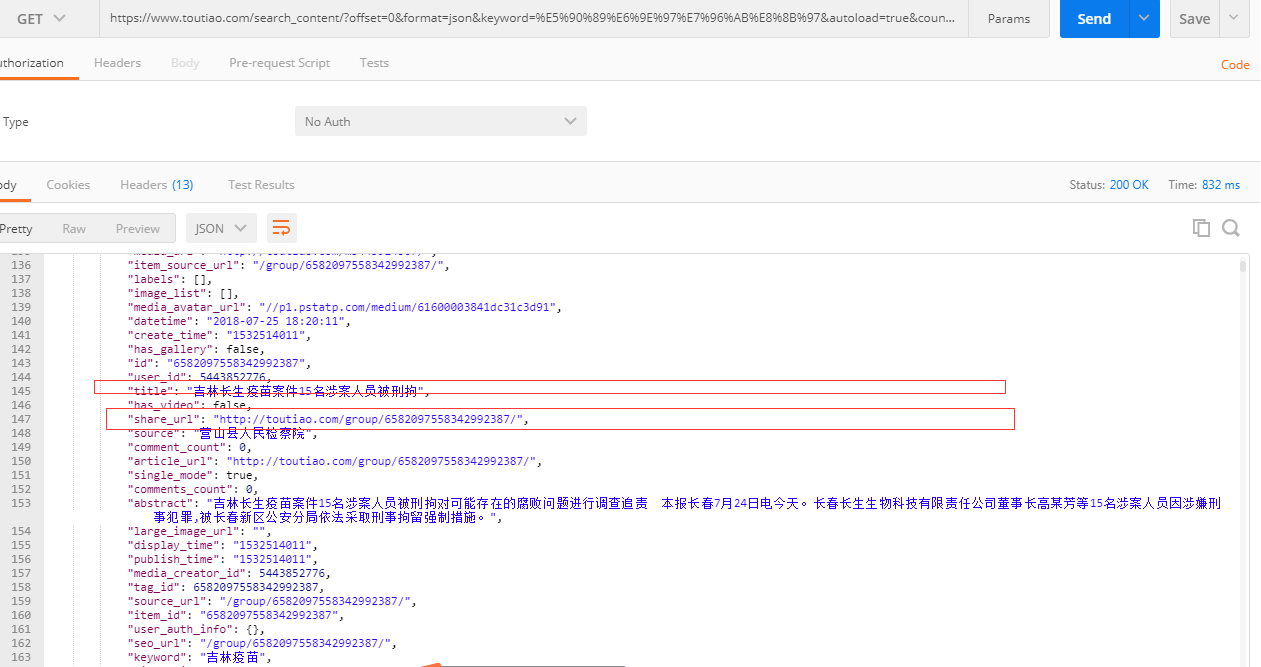
在Postman里面访问接口信息得到json信息(信息里面包含了文章的标题和链接)
基于这些信息来开发爬虫核心代码
# -*- coding: utf-8 -*-

import scrapy

from selenium import webdriver

import time

import  json

from toutiao.items import ToutiaoItem

class ToutiaoSerachSpider(scrapy.Spider):

    name = 'toutiao_serach'

    allowed_domains = ['toutiao.com']

   ###接口信息,这里为了方便把 &keyword=   挪到了最后边

    start_urls = ['https://www.toutiao.com/search_content/?offset=0&format=json&autoload=true&count=20&cur_tab=1&from=search_tab&keyword=']

    def parse(self, response):

        new_key_word=response.url+'吉林疫苗'

        yield scrapy.Request(new_key_word,callback=self.main_parse)

    def main_parse(self,response):

        search_content_data=json.loads(response.text)

        for aa in  search_content_data['data']:

            if 'open_url' in aa.keys() and 'play_effective_count'not in aa.keys(): ### 去除搜索后得到的综合里面 保留文章信息类型,去除视频信息类型

                yield scrapy.Request(aa['article_url'],callback=self.content_parse)

    def content_parse(self,response):

        driver = webdriver.PhantomJS()

        driver.get(response.url)

        time.sleep(3)

        title = driver.find_element_by_class_name('article-title').text

        content=driver.find_element_by_class_name('article-content').text

        item=ToutiaoItem()

        item['title'] =title

        item['content']=content

        yield item
最后得到新闻信息

使用scrapy爬虫,爬取今日头条搜索吉林疫苗新闻(scrapy+selenium+PhantomJS)的更多相关文章
- 使用scrapy爬虫,爬取今日头条首页推荐新闻(scrapy+selenium+PhantomJS)
爬取今日头条https://www.toutiao.com/首页推荐的新闻,打开网址得到如下界面 查看源代码你会发现 全是js代码,说明今日头条的内容是通过js动态生成的. 用火狐浏览器F12查看得知 ...
- Python 爬虫爬取今日头条街拍上的图片
# 今日头条--街拍 import requests from urllib.parse import urlencode import os from hashlib import md5 from ...
- PYTHON 爬虫笔记九:利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集(实战项目二)
利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集 目标站点分析 今日头条这类的网站制作,从数据形式,CSS样式都是通过数据接口的样式来决定的,所以它的抓取方法和其他网页的抓取方 ...
- 爬虫七之分析Ajax请求并爬取今日头条
爬取今日头条图片 这里只讨论出现的一些问题,代码在最下面github链接里. 首先,今日头条取消了"图集"这一选项,因此对于爬虫来说效率降低了很多: 在所有代码都完成后,也许是爬取 ...
- Python3从零开始爬取今日头条的新闻【一、开发环境搭建】
Python3从零开始爬取今日头条的新闻[一.开发环境搭建] Python3从零开始爬取今日头条的新闻[二.首页热点新闻抓取] Python3从零开始爬取今日头条的新闻[三.滚动到底自动加载] Pyt ...
- Python3从零开始爬取今日头条的新闻【四、模拟点击切换tab标签获取内容】
Python3从零开始爬取今日头条的新闻[一.开发环境搭建] Python3从零开始爬取今日头条的新闻[二.首页热点新闻抓取] Python3从零开始爬取今日头条的新闻[三.滚动到底自动加载] Pyt ...
- Python3从零开始爬取今日头条的新闻【三、滚动到底自动加载】
Python3从零开始爬取今日头条的新闻[一.开发环境搭建] Python3从零开始爬取今日头条的新闻[二.首页热点新闻抓取] Python3从零开始爬取今日头条的新闻[三.滚动到底自动加载] Pyt ...
- Python3从零开始爬取今日头条的新闻【二、首页热点新闻抓取】
Python3从零开始爬取今日头条的新闻[一.开发环境搭建] Python3从零开始爬取今日头条的新闻[二.首页热点新闻抓取] Python3从零开始爬取今日头条的新闻[三.滚动到底自动加载] Pyt ...
- 用Ajax爬取今日头条图片集
Ajax原理 在用requests抓取页面时,得到的结果可能和浏览器中看到的不一样:在浏览器中可以正常显示的页面数据,但用requests得到的结果并没有.这是因为requests获取的都是原始 ...
随机推荐
- JVN的理解
写的很不错,通俗易懂:http://www.cnblogs.com/leefreeman/p/7344460.html
- C#之委托与事件(转载)
委托 1. 委托是事件的基础,使用关键字delegate,通过委托与命名方法或匿名方法关联,可以实现委托的实例化.必须使用具有兼容返回类型和输入参数的方法或 lambda 表达式实例化委托. pri ...
- 2016湖南省赛 [Cloned]
A.2016 给出正整数 n 和 m,统计满足以下条件的正整数对 (a,b) 的数量: 1. 1≤a≤n,1≤b≤m; 2. a×b 是 2016 的倍数. Input 输入包含不超过 30 组数 ...
- 米卡 Mica Logo 存放处
- Async/Await 学习与示例
参考:Async/await学习 es 7 提供了对 promise 对象的更好的操作,省去了很多丧心病狂的链式异步请求,promise 是回调地狱的福音,而 Async/Await 则是 promi ...
- UOJ22 UR #1外星人(动态规划)
https://www.cnblogs.com/Gloid/p/10629779.html 这一场的D. #include<bits/stdc++.h> using namespace s ...
- session常用对象
1.object getArrtibute(String name) 获取与名字name相联系的属性 2.void setArrtibute(String name,object) 设置指定名字的属性 ...
- JAVA helloworld!
idea创建java项目 https://jingyan.baidu.com/article/48b558e3f8f6637f39c09a44.html 本地文档运行 java helloworld ...
- Java基础--面向对象编程2(封装)
1.封装的定义: 封装:将类的某些信息隐藏在类内部,不允许外部程序直接访问,而是通过该类提供的方法来实现对隐藏信息的操作和访问. 2. 为什么需要封装?封装的作用和含义? 首先思考一个问题:当我们要 ...
- 001 UI介绍
UI全称:User Interface,即用户界面 UI的职责:负责人机之间的交互,它需要将关键信息,操作逻辑等展示给用户 UI在游戏中承担的职责: 1.游戏美术风格的重要组成部分 2.承担着重要的美 ...