
7-----Scrapy框架中Download Middleware用法
这篇文章中写了常用的下载中间件的用法和例子。
Downloader Middleware处理的过程主要在调度器发送 requests请求的时候以及网页将 response结果返回给 spiders的时候,所以从这里我们可以知道下载中间件是介于 Scrapy的 request/response处理的钩子,用于修改 Scrapy request和 response。
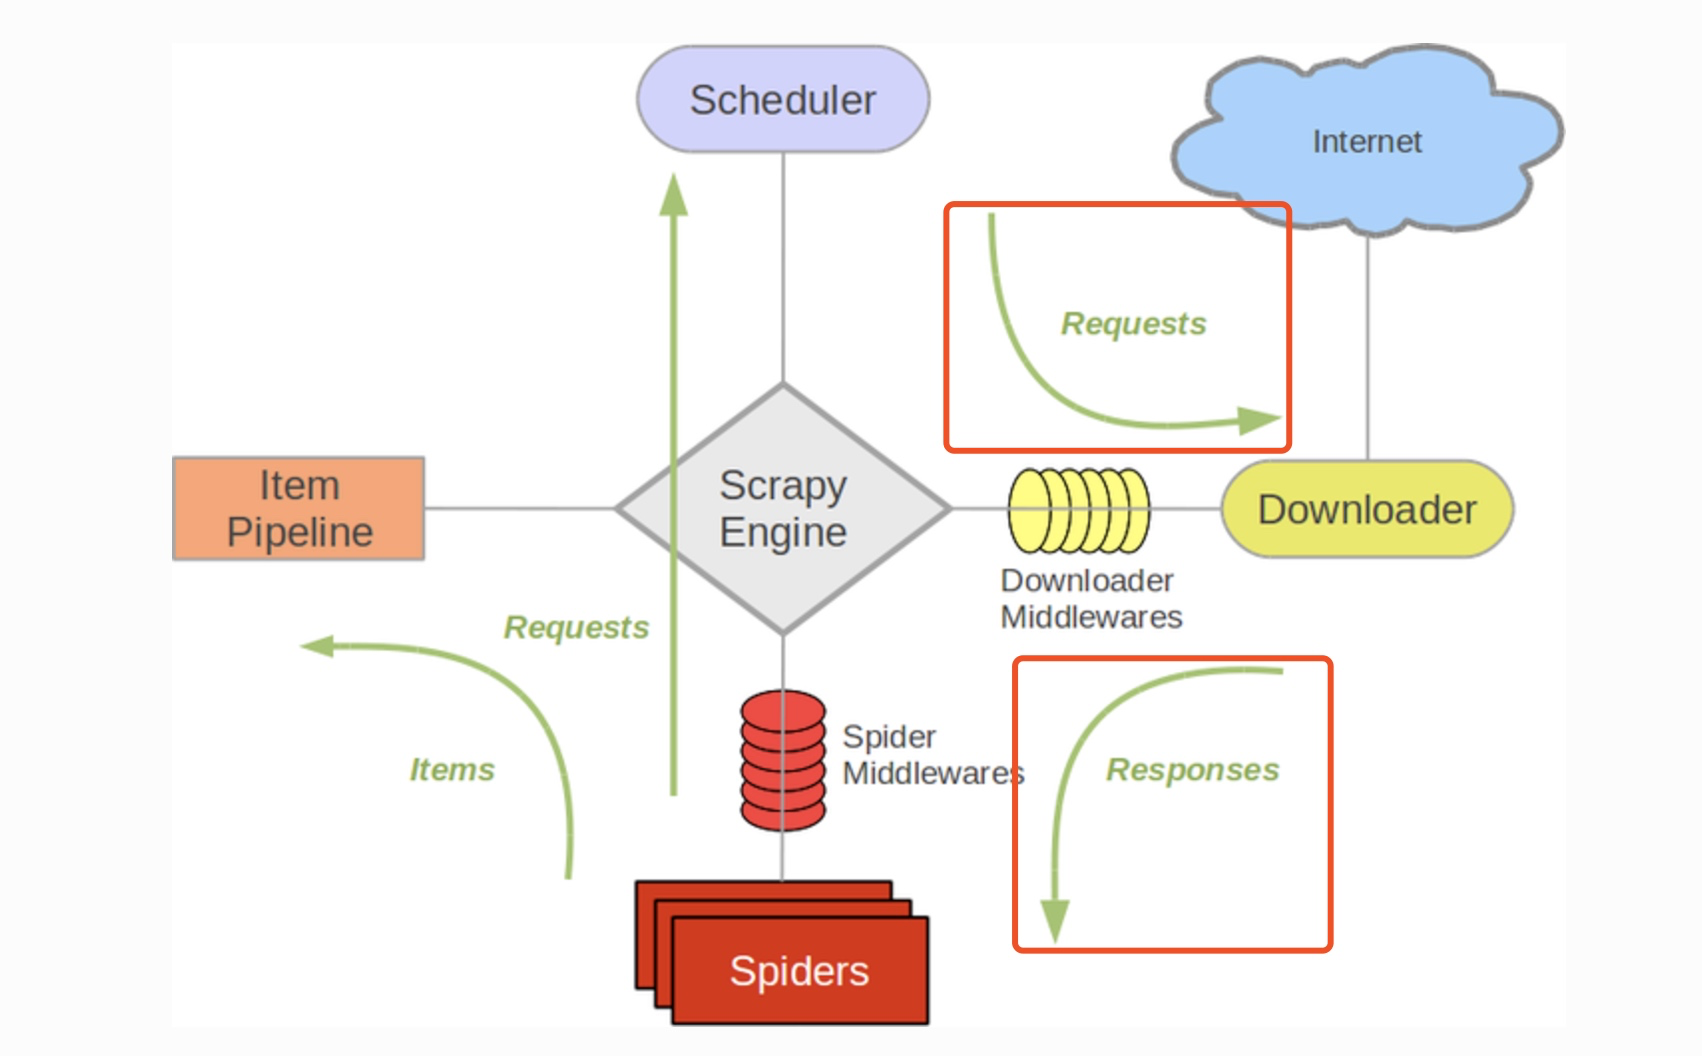
编写自己的下载器中间件
编写下载器中间件,需要定义以下一个或者多个方法的python类
为了演示这里的中间件的使用方法,这里创建一个项目作为学习,这里的项目是关于爬去 httpbin.org这个网站
scrapy startproject httpbintest
cd httpbintest
scrapy genspider example example.com
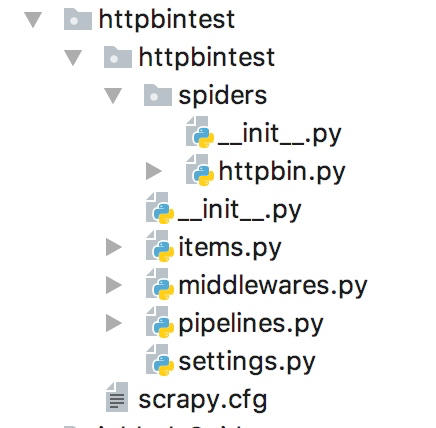
创建好后的目录结构如下:
这里我们先写一个简单的代理中间件来实现ip的伪装
创建好爬虫之后我们讲httpbin.py中的parse方法改成:
def parse(self, response):

        print(response.text)
然后通过命令行启动爬虫:scrapy crawl httpbin
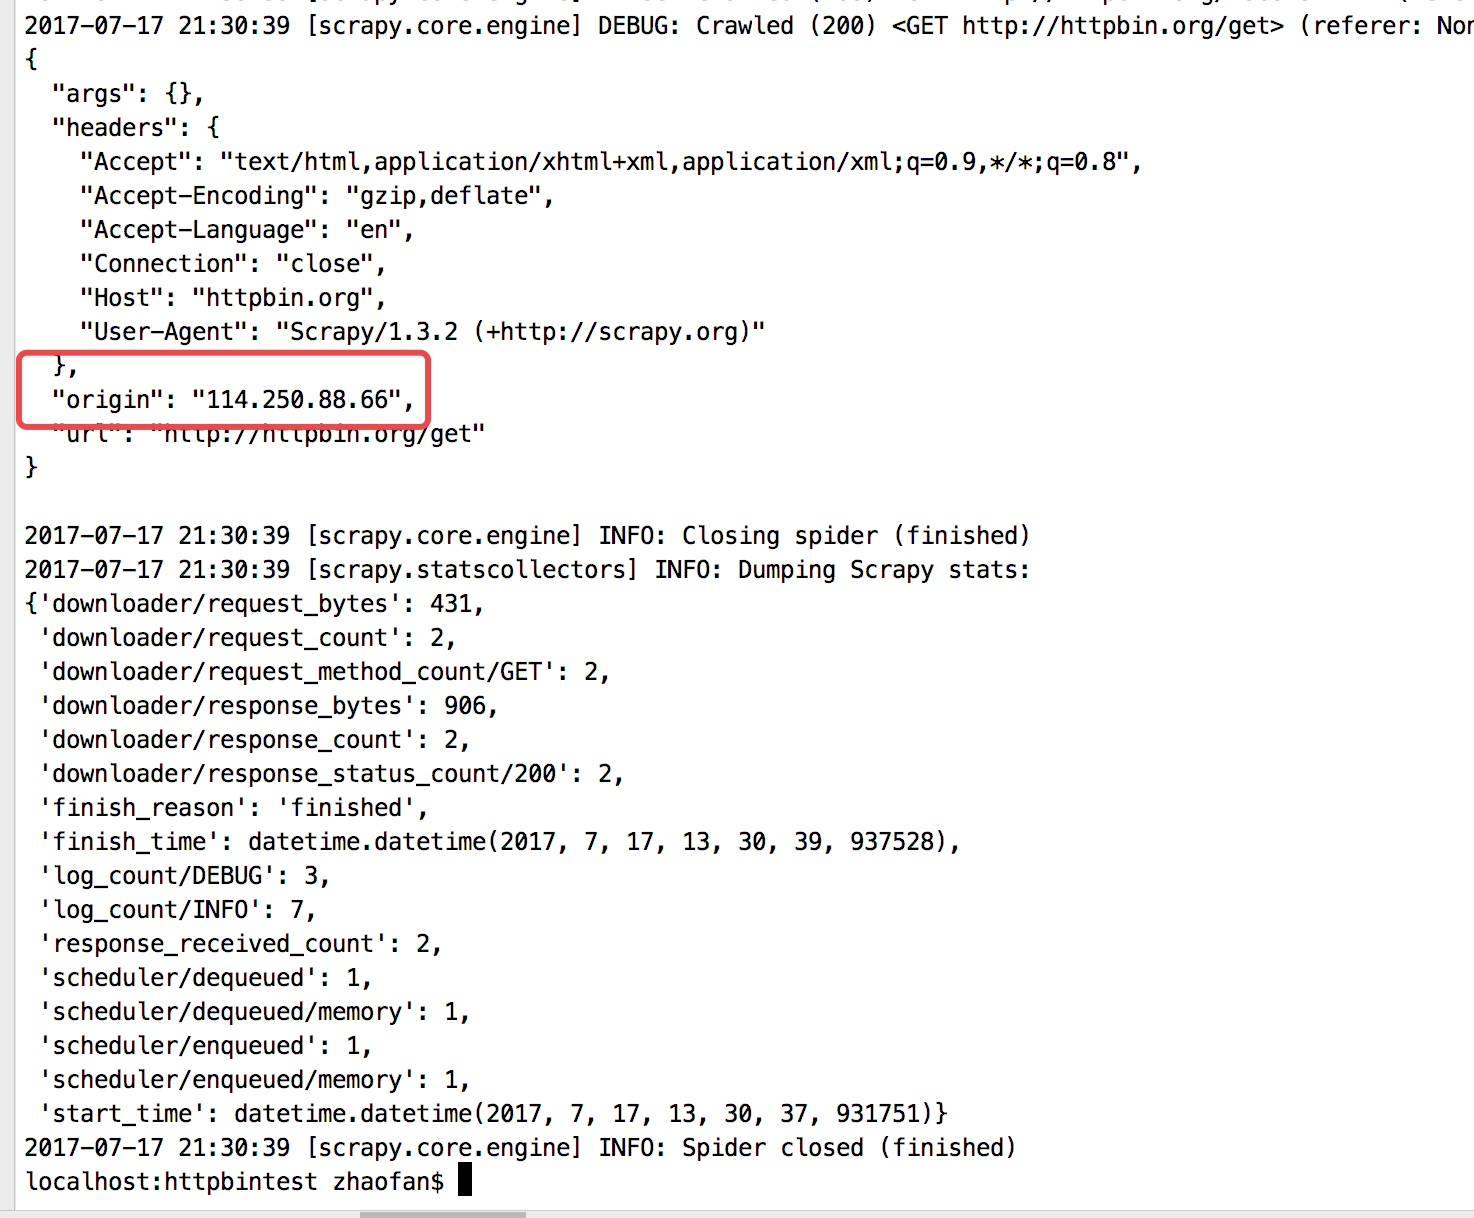
在最下面我们可以看到"origin": "114.250.88.66"
我们在查看自己的ip:

而我们要做就是通过代理中间件来实现ip的伪装,在middleares.py中写如下的中间件类:
class ProxyMiddleare(object):

    logger = logging.getLogger(__name__)

    def process_request(self,request, spider):

        self.logger.debug("Using Proxy")

        request.meta['proxy'] = 'http://127.0.0.1:9743'

        return None
这里因为我本地有一个代理FQ地址为:http://127.0.0.1:9743
所以直接设置为代理用,代理的地址为日本的ip
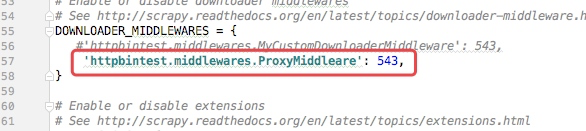
然后在settings.py配置文件中开启下载中间件的功能,默认是关闭的
然后我们再次启动爬虫:scrapy crawl httpbin
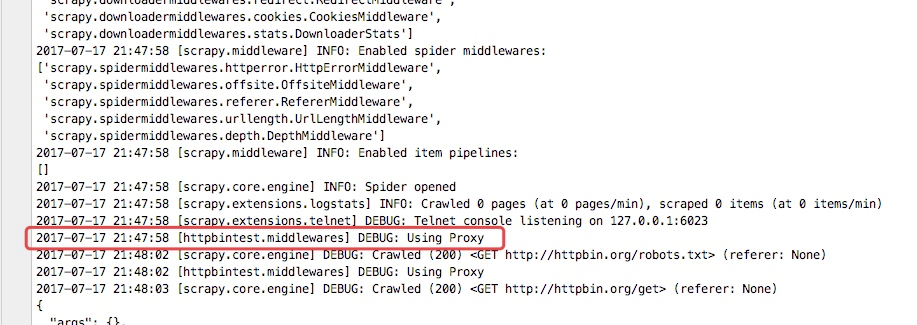
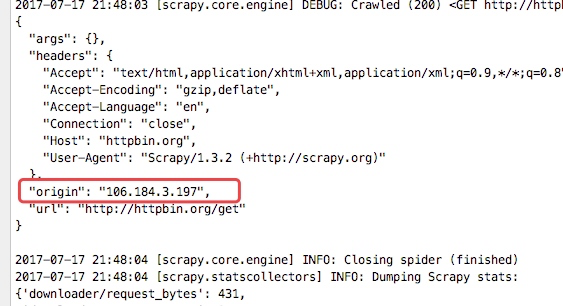
从下图的输入日志中我们可以看书我们定义的中间件已经启动,并且输入了我们打印的日志信息,并且我们查看origin的ip地址也已经成了日本的ip地址,这样我们的代理中间件成功了


详细说明
class Scrapy.downloadermiddleares.DownloaderMiddleware
process_request(request,spider)
当每个request通过下载中间件时,该方法被调用,这里有一个要求,该方法必须返回以下三种中的任意一种:None,返回一个Response对象,返回一个Request对象或raise IgnoreRequest。三种返回值的作用是不同的。
None:Scrapy将继续处理该request,执行其他的中间件的相应方法,直到合适的下载器处理函数(download handler)被调用,该request被执行(其response被下载)。
Response对象:Scrapy将不会调用任何其他的process_request()或process_exception() 方法,或相应地下载函数;其将返回该response。 已安装的中间件的 process_response() 方法则会在每个response返回时被调用。
Request对象:Scrapy则停止调用 process_request方法并重新调度返回的request。当新返回的request被执行后, 相应地中间件链将会根据下载的response被调用。
raise一个IgnoreRequest异常:则安装的下载中间件的 process_exception() 方法会被调用。如果没有任何一个方法处理该异常, 则request的errback(Request.errback)方法会被调用。如果没有代码处理抛出的异常, 则该异常被忽略且不记录。
process_response(request, response, spider)
process_response的返回值也是有三种:response对象,request对象,或者raise一个IgnoreRequest异常
如果其返回一个Response(可以与传入的response相同,也可以是全新的对象), 该response会被在链中的其他中间件的 process_response() 方法处理。
如果其返回一个 Request 对象,则中间件链停止, 返回的request会被重新调度下载。处理类似于 process_request() 返回request所做的那样。
如果其抛出一个 IgnoreRequest 异常,则调用request的errback(Request.errback)。 如果没有代码处理抛出的异常,则该异常被忽略且不记录(不同于其他异常那样)。
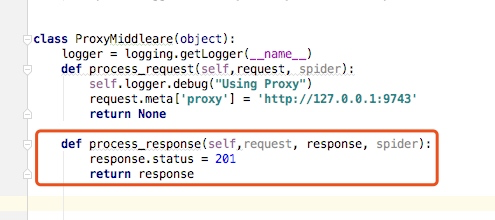
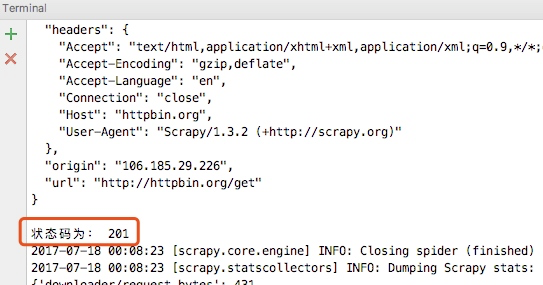
这里我们写一个简单的例子还是上面的项目,我们在中间件中继续添加如下代码:
然后在spider中打印状态码:
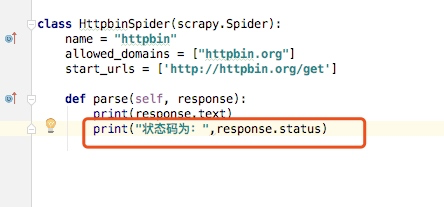
这样当我们重新运行爬虫的时候就可以看到如下内容
process_exception(request, exception, spider)
当下载处理器(download handler)或 process_request() (下载中间件)抛出异常(包括 IgnoreRequest 异常)时,Scrapy调用 process_exception()。
process_exception() 也是返回三者中的一个: 返回 None 、 一个 Response 对象、或者一个 Request 对象。
如果其返回 None ,Scrapy将会继续处理该异常,接着调用已安装的其他中间件的 process_exception() 方法,直到所有中间件都被调用完毕,则调用默认的异常处理。
如果其返回一个 Response 对象,则已安装的中间件链的 process_response() 方法被调用。Scrapy将不会调用任何其他中间件的 process_exception() 方法。
如果其返回一个 Request 对象, 则返回的request将会被重新调用下载。这将停止中间件的 process_exception() 方法执行,就如返回一个response的那样。 这个是非常有用的,就相当于如果我们失败了可以在这里进行一次失败的重试,例如当我们访问一个网站出现因为频繁爬取被封ip就可以在这里设置增加代理继续访问,我们通过下面一个例子演示
scrapy genspider google www.google.com 这里我们创建一个谷歌的爬虫,
然后启动scrapy crawl google,可以看到如下情况:
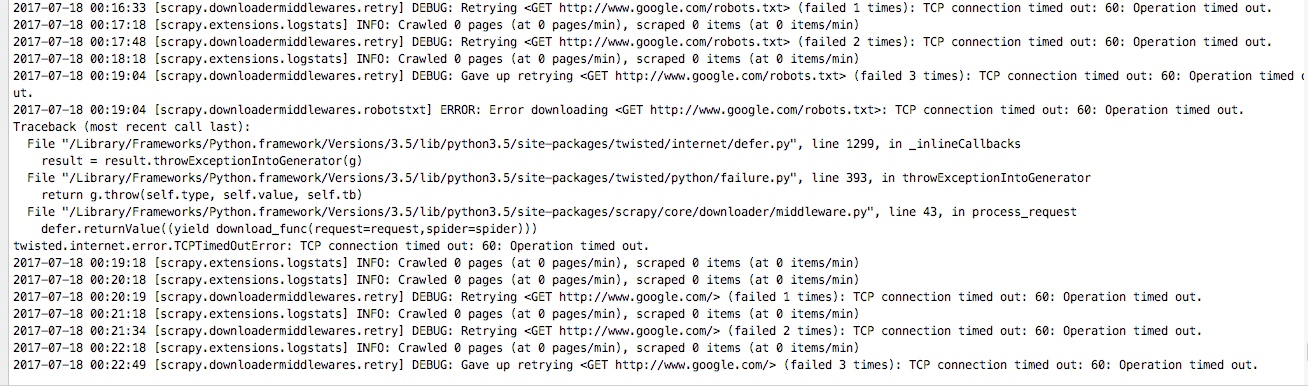
这里我们就写一个中间件,当访问失败的时候增加代理
首先我们把google.py代码进行更改,这样是白超时时间设置为10秒要不然等待太久,这个就是我们将spider里的时候的讲过的make_requests_from_url,这里我们把这个方法重写,并将等待超时时间设置为10s

这样我重新启动爬虫:scrapy crawl google,可以看到如下:

这里如果我们不想让重试,可以把重试中间件关掉:
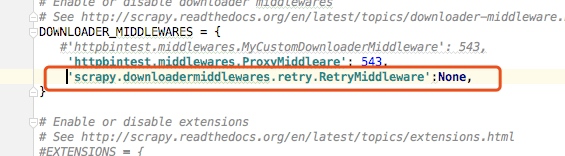
这样设置之后我们就把失败重试的中间件给关闭了,设置为None就表示关闭这个中间件,重新启动爬虫我们也可以看出没有进行重试直接报错了

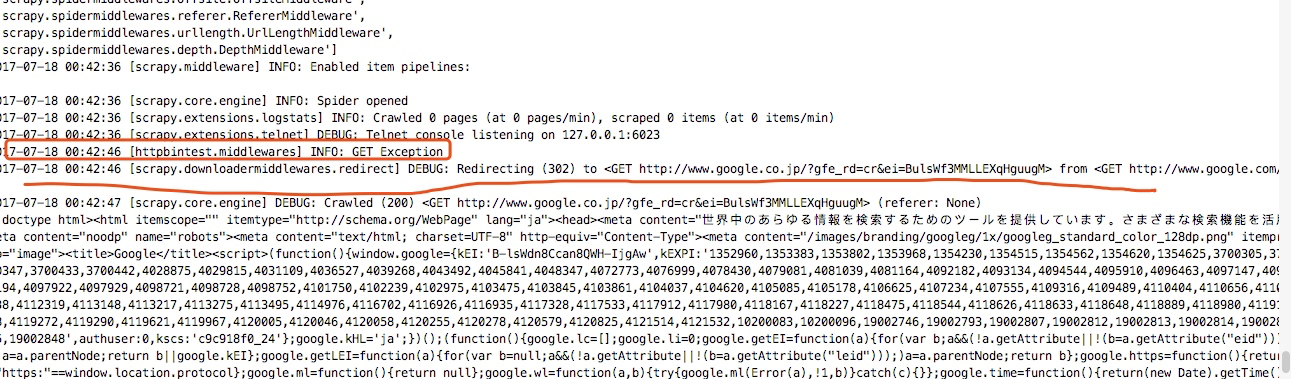
我们将代理中间件的代理改成如下,表示遇到异常的时候给请求加上代理,并返回request,这个样就会重新请求谷歌

重新启动谷歌爬虫,我们可以看到,我们第一次返回我们打印的日志信息GET Exception,然后加上代理后成功访问了谷歌,这里我的代理是日本的代理节点,所以访问到的是日本的谷歌站
7-----Scrapy框架中Download Middleware用法的更多相关文章
- scrapy框架中Download Middleware用法
scrapy框架中Download Middleware用法 Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给sp ...
- Python爬虫从入门到放弃(十七)之 Scrapy框架中Download Middleware用法
这篇文章中写了常用的下载中间件的用法和例子.Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给spiders的时候,所以 ...
- Python爬虫从入门到放弃 之 Scrapy框架中Download Middleware用法
这篇文章中写了常用的下载中间件的用法和例子.Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给spiders的时候,所以 ...
- Python之爬虫(十九) Scrapy框架中Download Middleware用法
这篇文章中写了常用的下载中间件的用法和例子.Downloader Middleware处理的过程主要在调度器发送requests请求的时候以及网页将response结果返回给spiders的时候,所以 ...
- Scrapy框架中选择器的用法【转】
Python爬虫从入门到放弃(十四)之 Scrapy框架中选择器的用法 请给作者点赞 --> 原文链接 Scrapy提取数据有自己的一套机制,被称作选择器(selectors),通过特定的Xpa ...
- scrapy框架中Item Pipeline用法
scrapy框架中item pipeline用法 当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的pyt ...
- scrapy框架中选择器的用法
scrapy框架中选择器的用法 Scrapy提取数据有自己的一套机制,被称作选择器(selectors),通过特定的Xpath或者CSS表达式来选择HTML文件的某个部分Xpath是专门在XML文件中 ...
- Python爬虫从入门到放弃(十四)之 Scrapy框架中选择器的用法
Scrapy提取数据有自己的一套机制,被称作选择器(selectors),通过特定的Xpath或者CSS表达式来选择HTML文件的某个部分Xpath是专门在XML文件中选择节点的语言,也可以用在HTM ...
- Python爬虫从入门到放弃(十六)之 Scrapy框架中Item Pipeline用法
当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的python类,负责接收到item并通过它执行一些行为, ...
随机推荐
- SQLServer+.net 事务锁表问题
最近操作Sqlserver遇到一个锁表问题.找了好久才搞明白原因和解决办法. 故障现象: 每次启动事务后,执行了删除或者修改操作以后,再执行查询操作就锁表. 解决过程: 1:最初以为SQLServer ...
- win10 requireAdministrator设置开机自启动无效的解决方案
开发了一个wpf程序,需要管理员权限,设置了requireAdministrator 同时需要开机自启动,所以添加了注册表: using (RegistryKey key = Registry.Cur ...
- EZOJ #78
传送门 分析 AC自动机板子题qwq 不过似乎可以哈希(因为所有模式串的长度相同,所以哈希乱搞就可以) 代码 #include<iostream> #include<cstdio&g ...
- python3-file的修改实现类似shell中sed的功能
# Auther: Aaron Fan '''思路:目的是为了修改yesterday这个文件,但是因为无法直接去修改这个文件,所以需要先把修改好的内容写入高yesterday.new这个文件中,然后再 ...
- Git 之 修复bug
前面介绍了Git版本控制,为我们省去了很多不必要的麻烦. 回滚 有没有想过,在我们开发过程中,修改需要是常有的事,如果我们现在不想要这个功能了,那么如何回到之前的版本呢?回滚,回到上一个版本. 那如果 ...
- 树莓派研究笔记(2)-- 安装Nginx 服务器,PHP 和 SQLite
1. 安装nginx web 服务器 sudo apt-get install nginx 2. 启动nginx,nginx的www目录默认在/usr/share/nginx/html中 sudo / ...
- oracle数据库之多表查询二
多表查询解题思路: 1.分析题目要查询的结果涉及到那几张表 2.将每张表建立关联条件,否则会产生笛卡尔积 3.分清楚查询的条件,然后使用and将条件链接 4.涉及到分组查询的需要使用聚合函数 5.分组 ...
- undefined reference to `clock_gettime
下面这个错误通常是因为链接选项里漏了-lrt,但有时发现即使加了-lrt仍出现这个问题,使用nm命令一直,会发现-lrt最终指向的文件没有包含任何symbol,这个时候,可以找相应的静态库版本libr ...
- python--输出spwm的数组
python的功能是非常强大的,这个例子使用python编写的输出spwm数组(不对,在C语言或者其他语言叫做数组,在这里叫做list.)的程序,我们在单片机程序里调用这个程序,可以达到输出spwm波 ...
- GridView内按钮Click获取记录主键值 在GridView控件中,每行记录内会放置一个铵钮,当用
在GridView控件中,每行记录内会放置一个铵钮,当用户点击这个铵钮时,获取当笔记录的主键值.可看演示(是一个gif动画,重新播放尝试刷新网页): 实现这个功能,你需要为GridView控件设置Da ...