
吴裕雄--天生自然 人工智能机器学习实战代码:LASSO回归
import numpy as np

import matplotlib.pyplot as plt

from sklearn import datasets, linear_model

from sklearn.model_selection import train_test_split

def load_data():

    diabetes = datasets.load_diabetes()

    return train_test_split(diabetes.data,diabetes.target,test_size=0.25,random_state=0)

#Lasso回归

def test_Lasso(*data):

    X_train,X_test,y_train,y_test=data

    regr = linear_model.Lasso()

    regr.fit(X_train, y_train)

    print('Coefficients:%s, intercept %.2f'%(regr.coef_,regr.intercept_))

    print("Residual sum of squares: %.2f"% np.mean((regr.predict(X_test) - y_test) ** 2))

    print('Score: %.2f' % regr.score(X_test, y_test))

# 产生用于回归问题的数据集

X_train,X_test,y_train,y_test=load_data()

# 调用 test_Lasso

test_Lasso(X_train,X_test,y_train,y_test)

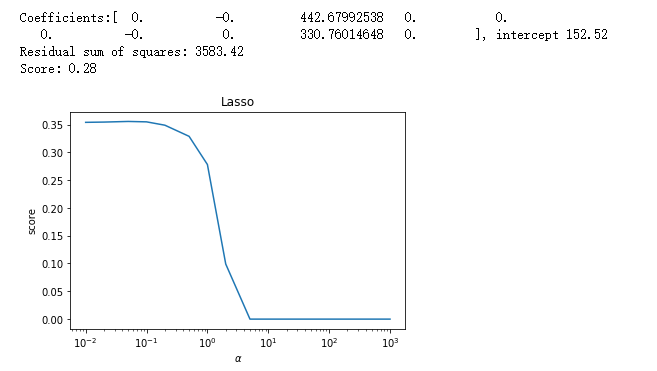
def test_Lasso_alpha(*data):

    X_train,X_test,y_train,y_test=data

    alphas=[0.01,0.02,0.05,0.1,0.2,0.5,1,2,5,10,20,50,100,200,500,1000]

    scores=[]

    for i,alpha in enumerate(alphas):

        regr = linear_model.Lasso(alpha=alpha)

        regr.fit(X_train, y_train)

        scores.append(regr.score(X_test, y_test))

    ## 绘图

    fig=plt.figure()

    ax=fig.add_subplot(1,1,1)

    ax.plot(alphas,scores)

    ax.set_xlabel(r"$\alpha$")

    ax.set_ylabel(r"score")

    ax.set_xscale('log')

    ax.set_title("Lasso")

    plt.show()

# 调用 test_Lasso_alpha

test_Lasso_alpha(X_train,X_test,y_train,y_test)
吴裕雄--天生自然 人工智能机器学习实战代码:LASSO回归的更多相关文章
- 吴裕雄--天生自然 人工智能机器学习实战代码:线性判断分析LINEARDISCRIMINANTANALYSIS
import numpy as np import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot ...
- 吴裕雄--天生自然 人工智能机器学习实战代码:ELASTICNET回归
import numpy as np import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot ...
- 吴裕雄--天生自然python机器学习实战:K-NN算法约会网站好友喜好预测以及手写数字预测分类实验
实验设备与软件环境 硬件环境:内存ddr3 4G及以上的x86架构主机一部 系统环境:windows 软件环境:Anaconda2(64位),python3.5,jupyter 内核版本:window ...
- 吴裕雄--天生自然python机器学习:使用Logistic回归从疝气病症预测病马的死亡率
,除了部分指标主观和难以测量外,该数据还存在一个问题,数据集中有 30%的值是缺失的.下面将首先介绍如何处理数据集中的数据缺失问题,然 后 再 利 用 Logistic回 归 和随机梯度上升算法来预测 ...
- 吴裕雄--天生自然python机器学习:决策树算法
我们经常使用决策树处理分类问题’近来的调查表明决策树也是最经常使用的数据挖掘算法. 它之所以如此流行,一个很重要的原因就是使用者基本上不用了解机器学习算法,也不用深究它 是如何工作的. K-近邻算法可 ...
- 吴裕雄--天生自然python机器学习:使用K-近邻算法改进约会网站的配对效果
在约会网站使用K-近邻算法 准备数据:从文本文件中解析数据 海伦收集约会数据巳经有了一段时间,她把这些数据存放在文本文件(1如1^及抓 比加 中,每 个样本数据占据一行,总共有1000行.海伦的样本主 ...
- 吴裕雄--天生自然python机器学习:支持向量机SVM
基于最大间隔分隔数据 import matplotlib import matplotlib.pyplot as plt from numpy import * xcord0 = [] ycord0 ...
- 吴裕雄--天生自然python机器学习:朴素贝叶斯算法
分类器有时会产生错误结果,这时可以要求分类器给出一个最优的类别猜测结果,同 时给出这个猜测的概率估计值. 概率论是许多机器学习算法的基础 在计算 特征值取某个值的概率时涉及了一些概率知识,在那里我们先 ...
- 吴裕雄--天生自然python机器学习:机器学习简介
除却一些无关紧要的情况,人们很难直接从原始数据本身获得所需信息.例如 ,对于垃圾邮 件的检测,侦测一个单词是否存在并没有太大的作用,然而当某几个特定单词同时出现时,再辅 以考察邮件长度及其他因素,人们 ...
随机推荐
- [Algo] 132. Deep Copy Undirected Graph
Make a deep copy of an undirected graph, there could be cycles in the original graph. Assumptions Th ...
- 17.3.12----OS模块ya
1---他是一xu个python系统编程的操作模块,可以处理文件和目录这些我们日常手动需要做的操作. import os#导入这个os模块,其实python模块就是C元的包含很多函数的文件 2---o ...
- 安装完Ubuntu后没有设置过root密码,想要进入root账户怎么办?
安装完Ubuntu后没有设置过root密码,想要进入root账户怎么办? Ubuntu的默认root密码是随机的,即每次开机都有一个新的root密码.我们可以在终端输入命令 sudo passwd,然 ...
- zip和rar文件的contentType
zip.rar.msi等文件使用Chrome提交的ContentType都为null,IE可以正确获取
- python-day2爬虫基础之爬虫基本架构
今天主要学习了爬虫的基本架构,下边做一下总结: 1.首先要有一个爬虫调度端,来启动爬虫.停止爬虫或者是监视爬虫的运行情况,在爬虫程序中有三个模块,首先是URL管理器来对将要爬取的URL以及爬取过的UR ...
- 关于 TCP 和 UDP 协议
TCP\UDP 两者区别总结:https://blog.csdn.net/striveb/article/details/84063712 图解HTTP,状态码,TCP.UDP等网络协议相关总结(持续 ...
- 题解-------P4053 [JSOI2007]建筑抢修
传送门 贪心+左偏树 贪心思路:先修快炸的楼 所以我们可以按照$T2$从大到小做一遍排序,然后从$1\cdots n$一个一个去修,如果这栋楼不能修(也就是当前时间已经超过$T2_{i}$),那我们就 ...
- springBoot中mybatis错误之 Property 'configuration' and 'configLocation' can not specified with together 解决
mybatis.config-location与mybatis.config-locations不同 mybatis.config-location不加载全局配置文件
- linux查看显卡
查看 nvidia 显卡 $ lspci | grep -i nvidia 02:00.0 3D controller: nVidia Corporation Device 1023 (rev a1) ...
- UML-设想
样例: