
【NLP_Stanford课堂】分词
一、如何定义一个单词
在统计一句话有多少个单词的时候,首要问题是如何定义一个单词,通常有三种情况:
- 是否认为句中的停顿词比如Uh是一个单词,我们称之为fragment,或者filled pause。
- 是否认为一个单词的不同形态是一个单词。
- 是否认为一个完整的词组,比如San Francisco是一个单词
以上三种在不同任务下有不同的处理方法。
二、统计什么信息
在统计时,我们统计如下信息:
- word types:词汇表中的一个元素,不重复
- word token:文本中该type的一个实例,可重复
一般如下表示:
corpora:语料库,也就是文本的数据集
N:token的数目
V:单词表,也就是type的集合
三、数据预处理
- 将所有的大写字母转为小写
- 将缩写词扩写,比如We're 扩写为We are
- 将连接符去掉,比如state-of-the-art 改写为 state of the are
- 将自连的单词切分开,比如Lowercase改写为lower case
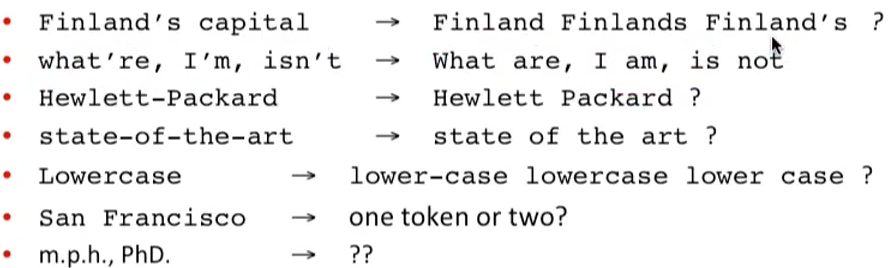
四、中文分词
对于中文来说,分词更困难,因为没有空格隔开,一般的baseline方法是Maximum Matching(也称作贪心)
Maximum Matching:
- 给定一个中文单词表和一个要分词的字符串
- 从字符串的最开始建立一个指针
- 在单词表中找到指针所指字符所能匹配的最长的单词
- 移动指针到这个单词的下一个字符
- 重复步骤3
【NLP_Stanford课堂】分词的更多相关文章
- 【NLP_Stanford课堂】情感分析
一.简介 实例: 电影评论.产品评论是positive还是negative 公众.消费者的信心是否在增加 公众对于候选人.社会事件等的倾向 预测股票市场的涨跌 Affective States又分为: ...
- 【NLP_Stanford课堂】文本分类2
一.实验评估参数 实验数据本身可以分为是否属于某一个类(即correct和not correct),表示本身是否属于某一类别上,这是客观事实:又可以按照我们系统的输出是否属于某一个类(即selecte ...
- 【NLP_Stanford课堂】文本分类1
文本分类实例:分辨垃圾邮件.文章作者识别.作者性别识别.电影评论情感识别(积极或消极).文章主题识别及任何可分类的任务. 一.文本分类问题定义: 输入: 一个文本d 一个固定的类别集合C={c1,c2 ...
- 【NLP_Stanford课堂】拼写校正
在多种应用比如word中都有拼写检查和校正功能,具体步骤分为: 拼写错误检测 拼写错误校正: 自动校正:hte -> the 建议一个校正 建议多个校正 拼写错误类型: Non-word Err ...
- 【NLP_Stanford课堂】语言模型4
平滑方法: 1. Add-1 smoothing 2. Add-k smoothing 设m=1/V,则有 从而每一项可以跟词汇表的大小相关 3. Unigram prior smoothing 将上 ...
- 【NLP_Stanford课堂】语言模型3
一.产生句子 方法:Shannon Visualization Method 过程:根据概率,每次随机选择一个bigram,从而来产生一个句子 比如: 从句子开始标志的bigram开始,我们先有一个( ...
- 【NLP_Stanford课堂】语言模型2
一.如何评价语言模型的好坏 标准:比起语法不通的.不太可能出现的句子,是否为“真实”或"比较可能出现的”句子分配更高的概率 过程:先在训练数据集上训练模型的参数,然后在测试数据集上测试模型的 ...
- 【NLP_Stanford课堂】语言模型1
一.语言模型 旨在:给一个句子或一组词计算一个联合概率 作用: 机器翻译:用以区分翻译结果的好坏 拼写校正:某一个拼错的单词是这个单词的概率更大,所以校正 语音识别:语音识别出来是这个句子的概率更大 ...
- 【NLP_Stanford课堂】最小编辑距离
一.什么是最小编辑距离 最小编辑距离:是用以衡量两个字符串之间的相似度,是两个字符串之间的最小操作数,即从一个字符转换成另一个字符所需要的操作数,包括插入.删除和置换. 每个操作数的cost: 每个操 ...
随机推荐
- SQL 随手记
SQL 学习片段: 建立一个简单的联系数据表, mobile_number char(11).mobile_province nvarchar(50).mobile_area nvarchar(200 ...
- POJ 2182 Lost Cows (求序列第k大)
题解 二分+树状数组 显然最和一个数的值就是rank 那么其它数有什么规律? 从后往前匹配rank,我们可以发现第i个数的rank为还没有匹配的rank第(a[i]+1)大的数 这可以用 树状数组+二 ...
- HDU-6341 Problem J. Let Sudoku Rotate(dfs 剪枝)
题目:有一个4*4*4*4的数独,每一横每一竖每一个小方块中都无重复的字母,即都为0-9,A-F..有一个已经填好的数独,若干个4*4的方块被逆时针拧转了若干次,问拧转回来至少需要多少次. 分析:很明 ...
- C. Molly's Chemicals
题目链接:http://codeforces.com/problemset/problem/776/C C. Molly's Chemicals time limit per test 2.5 sec ...
- QT跟VC++结合来进行插件的验证机制
由于最近公司要开发一个以C++插件机制为主的,主要有一个问题就是C++的二进制兼容性的问题.一旦类使用虚函数,只要随便改动下增删查改下头文件的虚函数,就会导致程序在跑的时候进行乱跳,因为这个时候exe ...
- linux_api之进程环境(二)
本篇索引: 1.引言 2.终端登录 3.进程组 4.会话期 1.引言 通过上一篇的学习,我们已经知道了如何控制一个进程,fork函数从父进程中复制出子进程,我们可以通过exec函数让子进程运行新的 ...
- 突破Http协议
突破Http协议 我到不先说什么Http什么的,对于HTTP的彻底理解是http是应用层的一个程序,就像我们写的诸多客户端和服务器模型,我们可能为了可靠,为了方便数据的解析,我们在数据包中其实就是结构 ...
- 《springcloud 四》服务保护机制
服务保护机制SpringCloud Hystrix 微服务高可用技术 大型复杂的分布式系统中,高可用相关的技术架构非常重要. 高可用架构非常重要的一个环节,就是如何将分布式系统中的各个服务打造成高可用 ...
- java多线程lock的使用
看代码: package com.ming.thread.reentrantlock; import java.util.concurrent.locks.Lock; import java.util ...
- 上下文(Context)和作用域(Scope)
函数的每次调用都有与之紧密相关的作用域和上下文.从根本上来说,作用域是基于函数的,而上下文是基于对象的. 换句话说,作用域涉及到所被调用函数中的变量访问,并且不同的调用场景是不一样的.上下文始终是th ...