
爬虫实践二--豆瓣top250电影
import requests

def get_movies():

    headers={

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.82 Safari/537.36',

    'Host': 'movie.douban.com'

    }

    for i in range(0,10):

        link = 'https://movie.douban.com/top250?start=' + str(i * 25)

        r = requests.get(link, headers=headers, timeout= 10)

        print (str(i+1),"页响应状态码:", r.status_code)

        print (r.text)

get_movies()
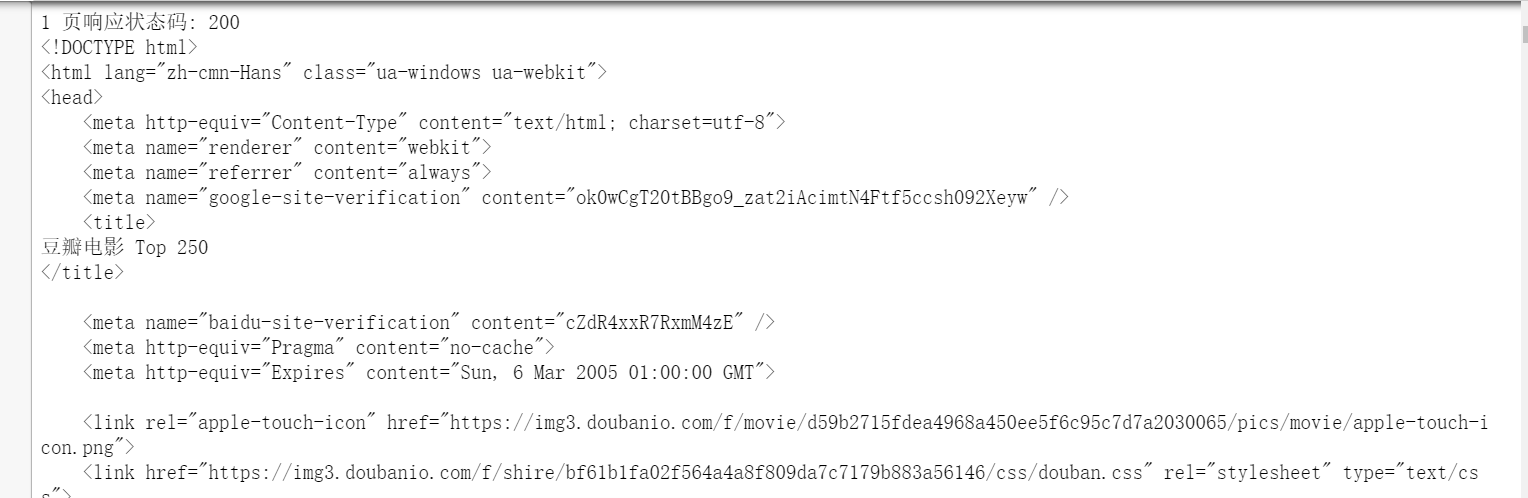
import requests

from bs4 import BeautifulSoup

def get_movies():

    headers={

        'user-agent':'Mozilla/5.0 (Windows NT 6.1;Win64;x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.82 Safari/537.36',

    'Host': 'movie.douban.com'

    }

    movie_list = []

    for i in range(0,10):

        link='https://movie.douban.com/top250?start='+str(i*25)

        r=requests.get(link,headers=headers,timeout=10)

        print(str(i+1),"页响应状态码:",r.status_code)

        soup=BeautifulSoup(r.text,"lxml")

        div_list=soup.find_all('div',class_='hd')

        for each in div_list:

            movie=each.a.span.text.strip()

            movie_list.append(movie)

    return movie_list

movies=get_movies()

print(movies)
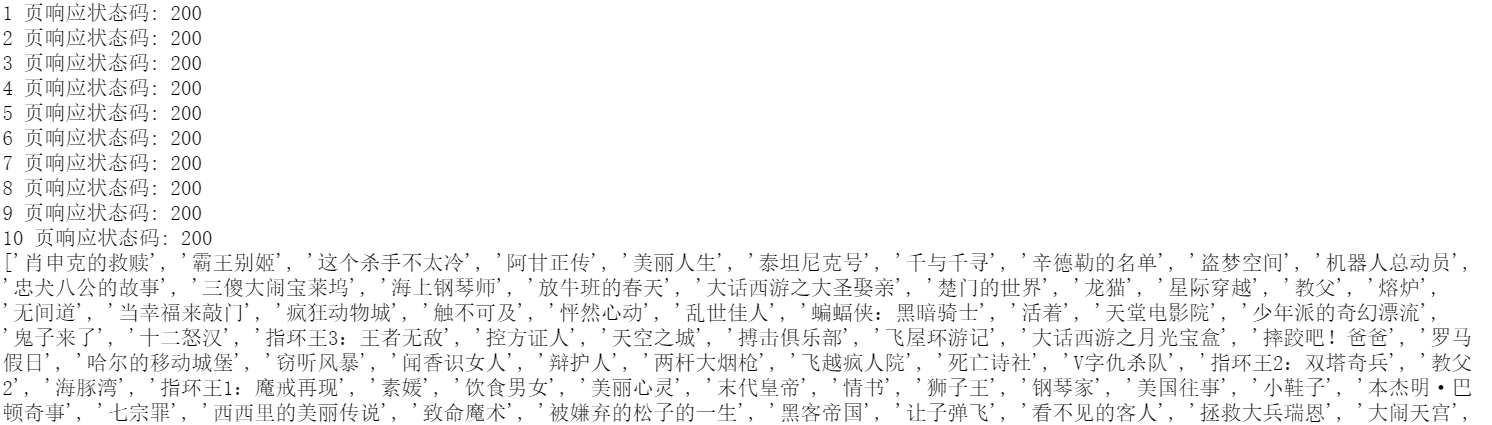
照着书打了一遍。不熟悉没印象,明天继续。
爬虫实践二--豆瓣top250电影的更多相关文章
- Python爬虫之多线程下载豆瓣Top250电影图片
爬虫项目介绍 本次爬虫项目将爬取豆瓣Top250电影的图片,其网址为:https://movie.douban.com/top250, 具体页面如下图所示: 本次爬虫项目将分别不使用多线程和使 ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- 爬取豆瓣TOP250电影
自己跟着视频学习的第一个爬虫小程序,里面有许多不太清楚的地方,不如怎么找到具体的电影名字的,那么多级关系,怎么以下就找到的是那个div呢? 诸如此类的,有许多,不过先做起来再说吧,后续再取去弄懂. i ...
- requests爬取豆瓣top250电影信息
''' 1.爬取豆瓣top250电影信息 - 第一页: https://movie.douban.com/top250?start=0&filter= - 第二页: https://movie ...
- Scrapy爬虫入门系列4抓取豆瓣Top250电影数据
豆瓣有些电影页面需要登录才能查看. 目录 [隐藏] 1 创建工程 2 定义Item 3 编写爬虫(Spider) 4 存储数据 5 配置文件 6 艺搜参考 创建工程 scrapy startproj ...
- 14、使用csv和excel存储豆瓣top250电影信息
记得我们第三关的时候爬取了豆瓣TOP250的电影名/评分/推荐语/链接,现在呢,我们要把它们存储下来,记得用今天课上学的csv和excel,分别存储下来哦- URL htt ...
- Scrapy项目 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
通过使Scrapy框架,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,进行数据挖掘和对web站点页面提取结构化数据,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 数据简析 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
一.数据分析截图(weka数据分析截图 ) 本例实验,使用Weka 3.7对豆瓣电影网页上所罗列的上映电影信息,如:标题.主要信息(年份.国家.类型)和评分等的信息进行数据分析,Weka 3.7数据分 ...
- Scrapy项目 - 源码工程 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
一.项目目录结构 spiders文件夹内包含doubanSpider.py文件,对于项目的构建以及结构逻辑,详见环境搭建篇. 二.项目源码 1.doubanSpider.py # -*- coding ...
随机推荐
- SonarQube集成Gitlab
SonarQube配置gitlab Gitlab创建访问Token 拷贝此Token至Sonarqube进行配置 检查配置配置成功 可以看到权限内的项目
- log4j和log4j2的配置部分
log4j和log4j2的功能及形式对比 http://blog.csdn.net/fangaohua200/article/details/53561718 log4j2的proptise配置 ht ...
- Android Binder 进程间通讯机制梳理
什么是 Binder ? Binder是Android系统中进程间通讯(IPC)的一种方式,也是Android系统中最重要的特性之一.Binder的设计采用了面向对象的思想,在Binder通信模型的四 ...
- 26. Remove Duplicates from Sorted Array*(快慢指针)
description: Given a sorted array nums, remove the duplicates in-place such that each element appear ...
- U149791 正多边形变换
原博客网页--洛谷博客 题目地址 如果您对群论有所了解,那么本题就是对二面体群 \(D_{2n}\) 的简单实现,您可以直接跳到代码部分.下面的解题思路只是对二面体群 \(D_{2n}\) 的构造思路 ...
- Spring Boot中的那些生命周期和其中的可扩展点(转)
前言可扩展点的种类Spring Boot启动过程 1.SpringApplication的启动过程 2.ApplicationContext的启动过程 3.一般的非懒加载单例Bean在Spring B ...
- HCNA Routing&Switching之动态路由协议OSPF基础(一)
前文我们了解了基于路径矢量算法的动态路由协议RIP防环以及度量值的修改相关话题,回顾请参考https://www.cnblogs.com/qiuhom-1874/p/15012895.html:今天我 ...
- python 分析文本文件
def count_words(filename):#统计指定文件单词的数量 """Count the approximate number of words in a ...
- c语言函数的嵌套使用和矩阵运算
这段时间,听刚刚学习c的同学说函数嵌套运用不太熟练,想做一个简单的程序进行练习,我也就当练练手了,哈哈.虽然说是比较简单,但是其中的思维也是值得思考的. 一.函数的嵌套使用 简单说明题目:对于等式 y ...
- SpringBoot 整合 MybatisPlus 3.0
CRUD是指在做计算处理时的增加(Create).读取查询(Retrieve).更新(Update)和删除(Delete)几个单词的首字母简写.主要被用在描述软件系统中DataBase或者持久层的 ...