
数据算法 --hadoop/spark数据处理技巧 --(9.基于内容的电影推荐 10. 使用马尔科夫模型的智能邮件营销)
九。基于内容的电影推荐
在基于内容的推荐系统中,我们得到的关于内容的信息越多,算法就会越复杂(设计的变量更多),不过推荐也会更准确,更合理。
本次基于评分,提供一个3阶段的MR解决方案来实现电影推荐。
1.找出各个电影的评分人总数
2.对于每个电影对A和B,找出所有同时对A和B评分的人。
3.找出每两个相关电影之间的关联。在这个阶段,我使用3个不同的关联度算法(pearson,cosine,jaccard)一般要根据具体的数据需求来选择关联度算法。
数据的输入格式:
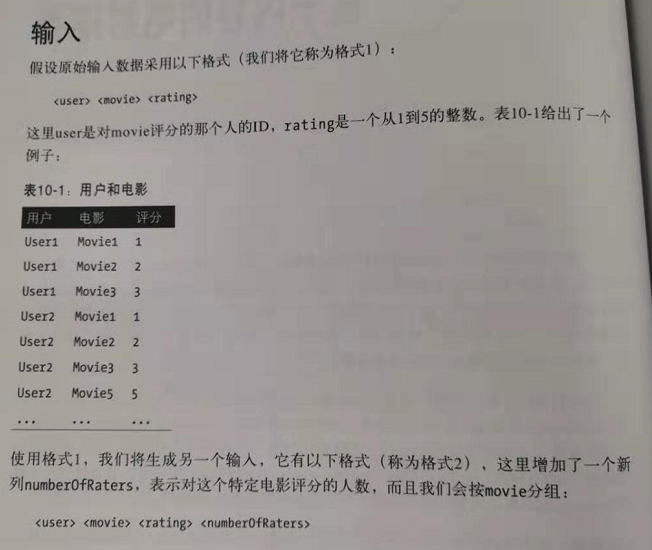
第一阶段转化完之后:
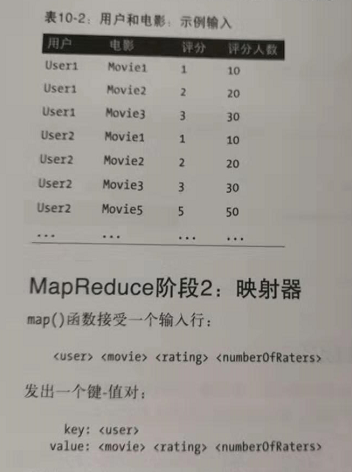
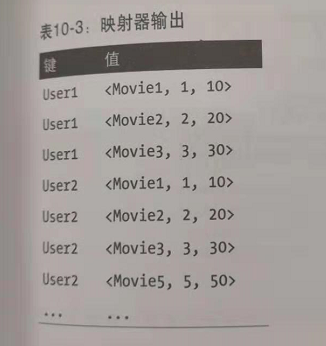
经过MR阶段2的map阶段后:
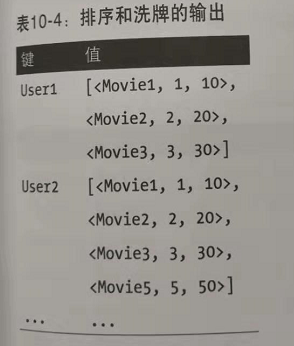
经过排序和洗牌之后的输出:
在经过MR阶段2的reduce()后:
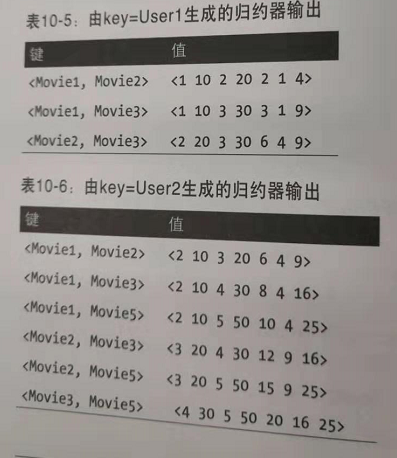
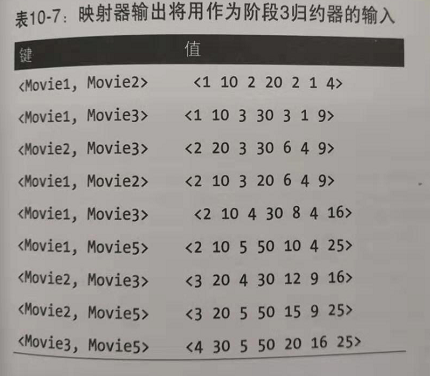
第三阶段MR的map阶段的输出:
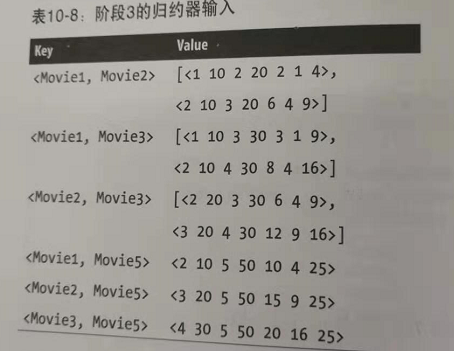
第三阶段MR的reduce的输入:
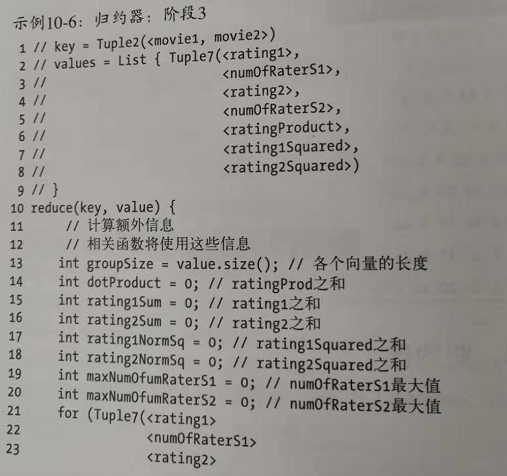
reduce代码:
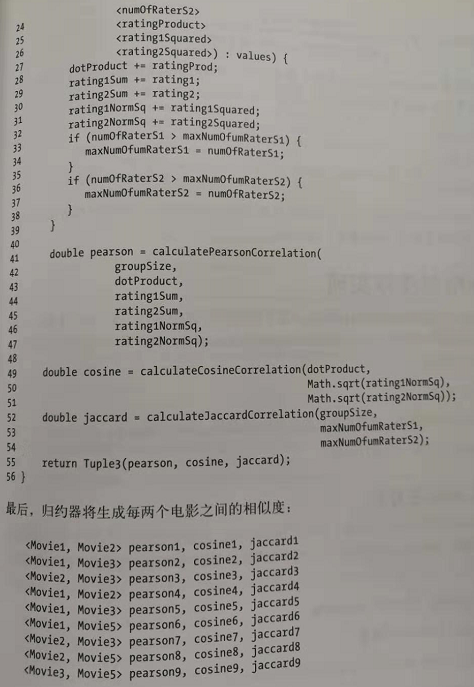
spark的基本步骤:
1.导入所需要的类和接口;
2.处理输入参数;
3.创建一个spark上下文对象;
4.读取hdfs文件并创建第一个RDD;
5.找出谁曾对这个电影评分;
6.按movie对moviesRDD分组;
7.找出每个电影的评分人数,然后创建(K,V)为usersRDD = <K=user,V=<movie,rating,numberofRaters>>
8.将usersRDD与自身连接,找出所有(movie1,movie2)对 joinedRDD = userRDD.join(userRDD) joinedRDD= (user,T2((m1,r1,n1),(m2,r2,n2)))
9.删除重复的(movie1,movie2)对;
10生成所有的(movie1,movie2)组合。
11.按键(movie1,movie2)对moviePairs分组
12计算每个(movie1,movie2)对的关联度
十。使用马尔科夫模型的智能营销
先说说马尔科夫:
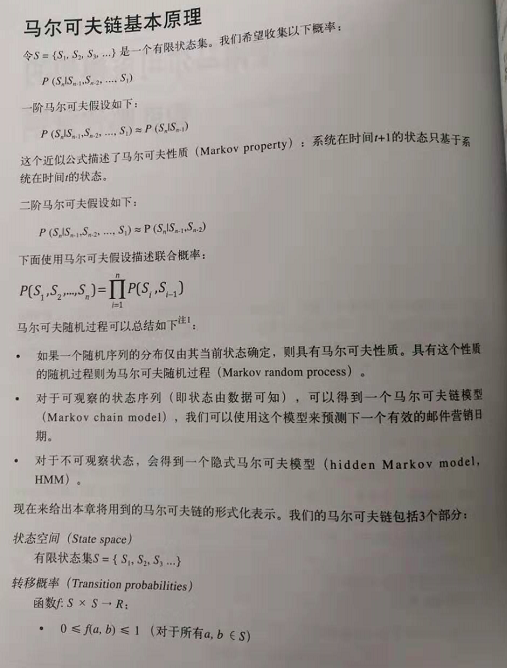

使用马尔科夫的智能营销的大致流程:
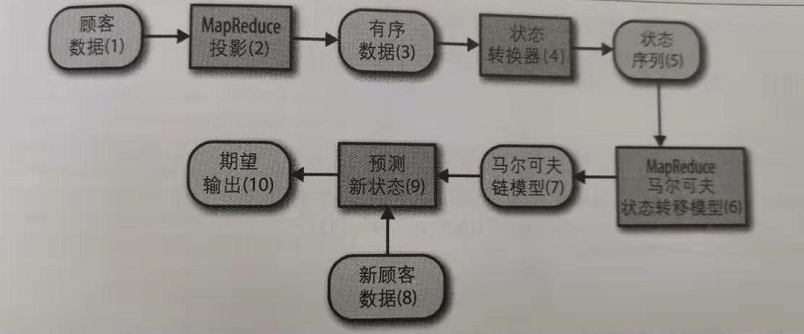
其中使用MR生成有序数据:可以采用之前说的二次排序的方式。
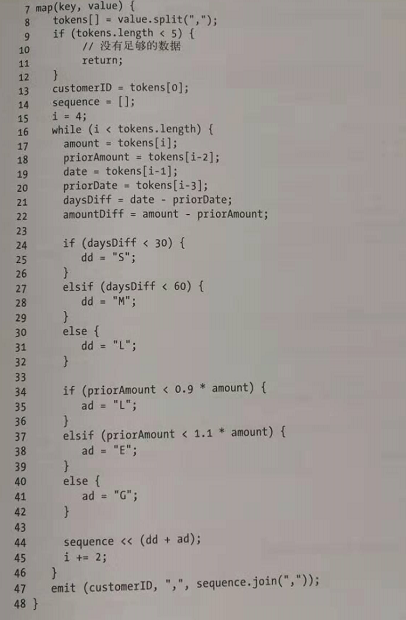
状态序列的生成:
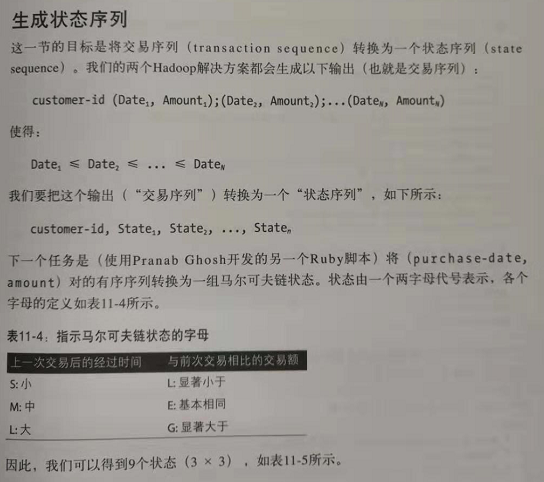
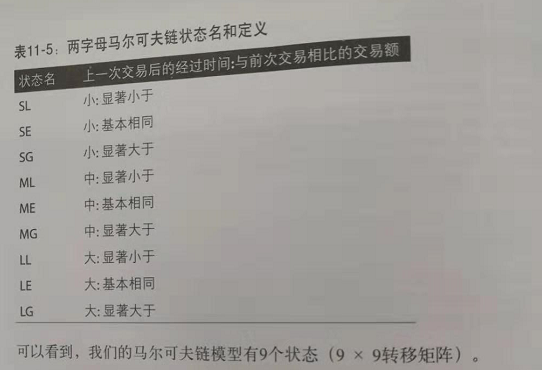
采用的策略:
数据算法 --hadoop/spark数据处理技巧 --(9.基于内容的电影推荐 10. 使用马尔科夫模型的智能邮件营销)的更多相关文章
- 数据算法 --hadoop/spark数据处理技巧 --(5.移动平均 6. 数据挖掘之购物篮分析MBA)
五.移动平均 多个连续周期的时间序列数据平均值(按相同时间间隔得到的观察值,如每小时一次或每天一次)称为移动平均.之所以称之为移动,是因为随着新的时间序列数据的到来,要不断重新计算这个平均值,由于会删 ...
- 数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)
一.二次排序问题. MR/hadoop两种方案: 1.让reducer读取和缓存给个定键的所有值(例如,缓存到一个数组数据结构中,)然后对这些值完成一个reducer中排序.这种方法不具有可伸缩性,因 ...
- 数据算法 --hadoop/spark数据处理技巧 --(3.左外连接 4.反转排序)
三. 左外连接 考虑一家公司,比如亚马逊,它拥有超过2亿的用户,每天要完成数亿次交易.假设我们有两类数据,用户和交易: users(user_id,location_id) transactions( ...
- 数据算法 --hadoop/spark数据处理技巧 --(17.小文件问题 18.MapReuce的大容量缓存)
十七.小文件问题 十八.MR的大容量缓存 在MR中使用和读取大容量缓存,(也就是说,可能包括数十亿键值对,而无法放在一个商用服务器的内存中).本次提出的算法通用,可以在任何MR范式中使用.(eg:MR ...
- 数据算法 --hadoop/spark数据处理技巧 --(11.K-均值聚类 12. k-近邻)
十一.k-均值聚类 这个需要MR迭代多次. 开始时,会选择K个点作为簇中心,这些点成为簇质心.可以选择很多方法啦初始化质心,其中一种方法是从n个点的样本中随机选择K个点.一旦选择了K个初始的簇质心,下 ...
- 数据算法 --hadoop/spark数据处理技巧 --(13.朴素贝叶斯 14.情感分析)
十三.朴素贝叶斯 朴素贝叶斯是一个线性分类器.处理数值数据时,最好使用聚类技术(eg:K均值)和k-近邻方法,不过对于名字.符号.电子邮件和文本的分类,则最好使用概率方法,朴素贝叶斯就可以.在某些情况 ...
- 数据算法 --hadoop/spark数据处理技巧 --(15.查找、统计和列出大图中的所有三角形 16.k-mer计数)
十五.查找.统计和列出大图中的所有三角形 第一步骤的mr: 第二部mr: 找出三角形 第三部:去重 spark: 十六: k-mer计数 spark:
- 数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)
七,共同好友. 在所有用户对中找出“共同好友”. eg: a b,c,d,g b a,c,d,e map()-> <a,b>,<b,c,d,g> ;< ...
- 基于隐马尔科夫模型(HMM)的地图匹配(Map-Matching)算法
文章目录 1. 1. 摘要 2. 2. Map-Matching(MM)问题 3. 3. 隐马尔科夫模型(HMM) 3.1. 3.1. HMM简述 3.2. 3.2. 基于HMM的Map-Matchi ...
随机推荐
- 怎么将文件夹上传到GitHub上
1. 在GitHub上新建一个仓库地址: http://github.com/......git 2. 在需要上传的文件夹目录下,运行 git init 初始化git: 3. 运行git ad ...
- Spring学习记录6——ThreadLocal简介
Spring通过各种模板类降低了开发者使用各种数据持久化技术的难度.这些模板类是线程安全的,所以 多个DAO可以复用同一个模板实例而不会发生冲突.在使用模板类访问底层数据时,模板类需要绑定数据连接或者 ...
- 出现An App ID with Identifier 'com.XXX.XXX’ is not available. Please enter a different string.
解决方法: 1.移除钥匙串中的开发证书,重新导入, 完全关闭Xcode; 2.再次打开Xcode,通过 Preferences - View Details - download 新的证书: 3.选择 ...
- MongoDB数据库备份和恢复
1.数据库备份 mogodbdump -h dbhost -d dbname -o dbdirectory -h: 服务器地址,也可以指定端口号 -d: 需要备份的数据库的名称 -o: 备份的数据库存 ...
- Qt Installer Framework翻译(3-0)
终端用户使用流程 离线安装和在线安装对终端用户来说是相似的.安装程序将你的应用程序和维护工具一起打包,该工具由包管理器,更新程序和卸载程序组成.用户可以使用维护工具来添加,更新和删除组件.维护工具连接 ...
- moco响应中文乱码
moco版本为:moco-runner-standalone-0.11.1.jar 在一次使用moco框架的时候,浏览器查看响应时,发现返回来的中文是乱码. 按照网上的操作,在响应结果中加上heade ...
- Docker windows nanoserver/mysql镜像root用户密码错误
由于需要在Windows server上的Docker中部署mysql服务,为了方便起见所以在Docker hub找到了nanoserver/mysql (https://hub.docker.com ...
- Markdown 标记 粘贴到 小书 匠 才知道 哦
# 一级标题## 这是二级标题### 三级标题##### 五级 高阶== 低阶-- [TOC] > 这是一级引用>>这是二级引用>>> 这是三级引用 ```java ...
- 发现 一个业务管理系统 解决了 orm 和 前端框架 剩下的 是 业务逻辑 了 。 哈
解决了 orm 和 前端框架 剩下的 是 业务逻辑 了 . 哈 还有 各种 aop 组件 呢 . 大家 high 来 准备 用 fluent data 和 mysql 写一个 wcf 的 接口呢. ...
- centos MySQL安装与卸载
1.配置YUM源 在MySQL官网中下载YUM源rpm安装包:https://dev.mysql.com/downloads/repo/yum/ wget http://dev.mysql.com/g ...