
数据算法 --hadoop/spark数据处理技巧 --(15.查找、统计和列出大图中的所有三角形 16.k-mer计数)
十五、查找、统计和列出大图中的所有三角形

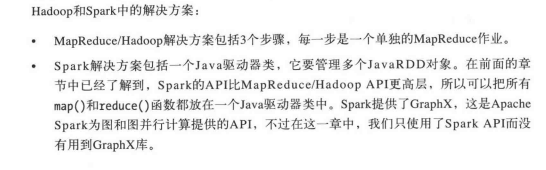

第一步骤的mr:


第二部mr: 找出三角形

第三部:去重
spark:

十六: k-mer计数


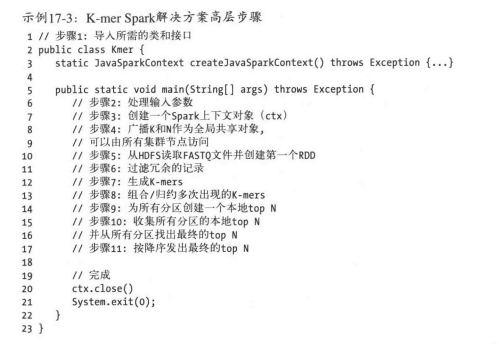
spark:

数据算法 --hadoop/spark数据处理技巧 --(15.查找、统计和列出大图中的所有三角形 16.k-mer计数)的更多相关文章
- 数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)
一.二次排序问题. MR/hadoop两种方案: 1.让reducer读取和缓存给个定键的所有值(例如,缓存到一个数组数据结构中,)然后对这些值完成一个reducer中排序.这种方法不具有可伸缩性,因 ...
- 数据算法 --hadoop/spark数据处理技巧 --(5.移动平均 6. 数据挖掘之购物篮分析MBA)
五.移动平均 多个连续周期的时间序列数据平均值(按相同时间间隔得到的观察值,如每小时一次或每天一次)称为移动平均.之所以称之为移动,是因为随着新的时间序列数据的到来,要不断重新计算这个平均值,由于会删 ...
- 数据算法 --hadoop/spark数据处理技巧 --(9.基于内容的电影推荐 10. 使用马尔科夫模型的智能邮件营销)
九.基于内容的电影推荐 在基于内容的推荐系统中,我们得到的关于内容的信息越多,算法就会越复杂(设计的变量更多),不过推荐也会更准确,更合理. 本次基于评分,提供一个3阶段的MR解决方案来实现电影推荐. ...
- 数据算法 --hadoop/spark数据处理技巧 --(3.左外连接 4.反转排序)
三. 左外连接 考虑一家公司,比如亚马逊,它拥有超过2亿的用户,每天要完成数亿次交易.假设我们有两类数据,用户和交易: users(user_id,location_id) transactions( ...
- 数据算法 --hadoop/spark数据处理技巧 --(17.小文件问题 18.MapReuce的大容量缓存)
十七.小文件问题 十八.MR的大容量缓存 在MR中使用和读取大容量缓存,(也就是说,可能包括数十亿键值对,而无法放在一个商用服务器的内存中).本次提出的算法通用,可以在任何MR范式中使用.(eg:MR ...
- 数据算法 --hadoop/spark数据处理技巧 --(11.K-均值聚类 12. k-近邻)
十一.k-均值聚类 这个需要MR迭代多次. 开始时,会选择K个点作为簇中心,这些点成为簇质心.可以选择很多方法啦初始化质心,其中一种方法是从n个点的样本中随机选择K个点.一旦选择了K个初始的簇质心,下 ...
- 数据算法 --hadoop/spark数据处理技巧 --(13.朴素贝叶斯 14.情感分析)
十三.朴素贝叶斯 朴素贝叶斯是一个线性分类器.处理数值数据时,最好使用聚类技术(eg:K均值)和k-近邻方法,不过对于名字.符号.电子邮件和文本的分类,则最好使用概率方法,朴素贝叶斯就可以.在某些情况 ...
- 数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)
七,共同好友. 在所有用户对中找出“共同好友”. eg: a b,c,d,g b a,c,d,e map()-> <a,b>,<b,c,d,g> ;< ...
- 哈,我自己翻译的小书,马上就完成了,是讲用python处理大数据框架hadoop,spark的
花了一些时间, 但感觉很值得. Big Data, MapReduce, Hadoop, and Spark with Python Master Big Data Analytics and Dat ...
随机推荐
- 用来更新服务的bat 脚本
net stop XK.Service echo "已停止服务,开始更新!" set /a t = echo %t% :loop 127.1 >nul set /a t = ...
- python隐藏类中的属性
方法一: 效果图一: 代码一: # 定义一个矩形的类 class Rectangle: # 定义初始化方法 def __init__(self,width,height): self.hidden_w ...
- leetcode 最大水池
leetcode 11题 水池最大容积 题目描述 给定 n 个非负整数 a1,a2,...,an,每个数代表坐标中的一个点 (i, ai) .在坐标内画 n 条垂直线,垂直线 i 的两个端点分别为 ( ...
- numpy 其它常用方法
一.创建特殊的数组 1.ones() 语法 np.ones(shape, dtype=None) # shape 创建数组的shape # dtype 指定数组的数据类型 例子 import nump ...
- Scala 学习(4)之「类——基本概念2」
目录 内部类 extends override和super override field isInstanceOf和asInstanceOf getClass和classOf 内部类 import s ...
- mongdb角色的授权
开启cmd窗口切换到cd D:\programs\mongoDB\bin D:\programs\mongoDB\bin>mongo MongoDB shell version v3.4.6 c ...
- python __init__()类构造方法
构造方法用于创建对象时使用,每当创建一个类的实例对象时,python解释器都会自动调用它. class Person: def __init__(self): print("调用构造方法&q ...
- [bzoj4569] [loj#2014] [Scoi2016] 萌萌哒
Description 一个长度为 \(n\) 的大数,用 \(S1S2S3...Sn\) 表示,其中 \(Si\) 表示数的第 \(i\) 位, \(S1\) 是数的最高位,告诉你一些限制条件,每个 ...
- MySQL军规升级版(转)
一.基础规范 表存储引擎必须使用InnoDB 表字符集默认使用utf8,必要时候使用utf8mb4 解读:(1)通用,无乱码风险,汉字3字节,英文1字节(2)utf8mb4是utf8的超集,有存储4字 ...
- 动态规划-Dynamic Programming(DP)
动态规划 动态规划方法心得 动态规划是一般的面试.笔试中的高频算法题,熟练掌握必要的.动态规划的中心思想是在解决当前问题时,可以由之前已经计算所得的结果并结合现在的限制条件递推出结果.由于此前的计 ...