
PPI | protein-protein interaction | 蛋白互作分析
前言
做RNA-seq基因表达数据分析挖掘,我们感兴趣的其实是“基因互作”,哪些基因影响了我们这个基因G,我们的基因G又会去影响哪些基因,从而得到基因调控的机制。
直觉确实是很明确的,但是细节处却有很多问题。
我们讨论的到底是基因表达的互作,还是基因产物的互作?
------------
对于蛋白编码基因,它翻译产生蛋白,如果此蛋白不参与转录过程,理论上不可能会影响另一个基因的表达,那也就不存在基因表达的互作的,它们的基因表达被很好的隔离起来了,相互独立,互不影响。
但现在鉴定出了很多调控基因或其他在基因组上的调控序列,比如miRNA、lncRNA等,它们也都需要从基因组上转录出来,然后转录产物会去影响其他基因的表达(影响转录)。这才是基因表达互作,虽然MiRNA、lncRNA不能被称作基因。
------------
基因产物的互作就普遍了,那就是蛋白互作,也就是STRING等数据库里收集的信息。
蛋白互作也容易直观理解些,复杂的多细胞生命体,几乎所有的功能都是靠蛋白来实现的,所以有很多蛋白要互相结合(空间上)在一起来行使自己的功能。
------------
还有一个就是遗传学领域的基因互作,这与生物学的基因互作完全不同,遗传学考虑的是宏观的基因互作,站在表型的基础上。 Novel phenotypes often result from the interactions of two genes。
遗传学的基因互作是生物学基因产物互作的结果。
STRING database的挖掘
这个数据库绝对是做实验人的宝藏,里面包含了各种蛋白互作关系,不用做实验就有一大堆证据。
IPA了解一下,收费的高端分析软件,大部分就是整合的这个数据库,很多大佬喜欢用IPA来找明星基因,再来讲故事,实例请看之前解读的CSC paper。
首先了解一下STRING里面有哪些文件可以下载:
https://string-db.org/cgi/download.pl?sessionId=yMNmD7s36wS8
选你的物种,减少文件大小,常用的就是互作数据:
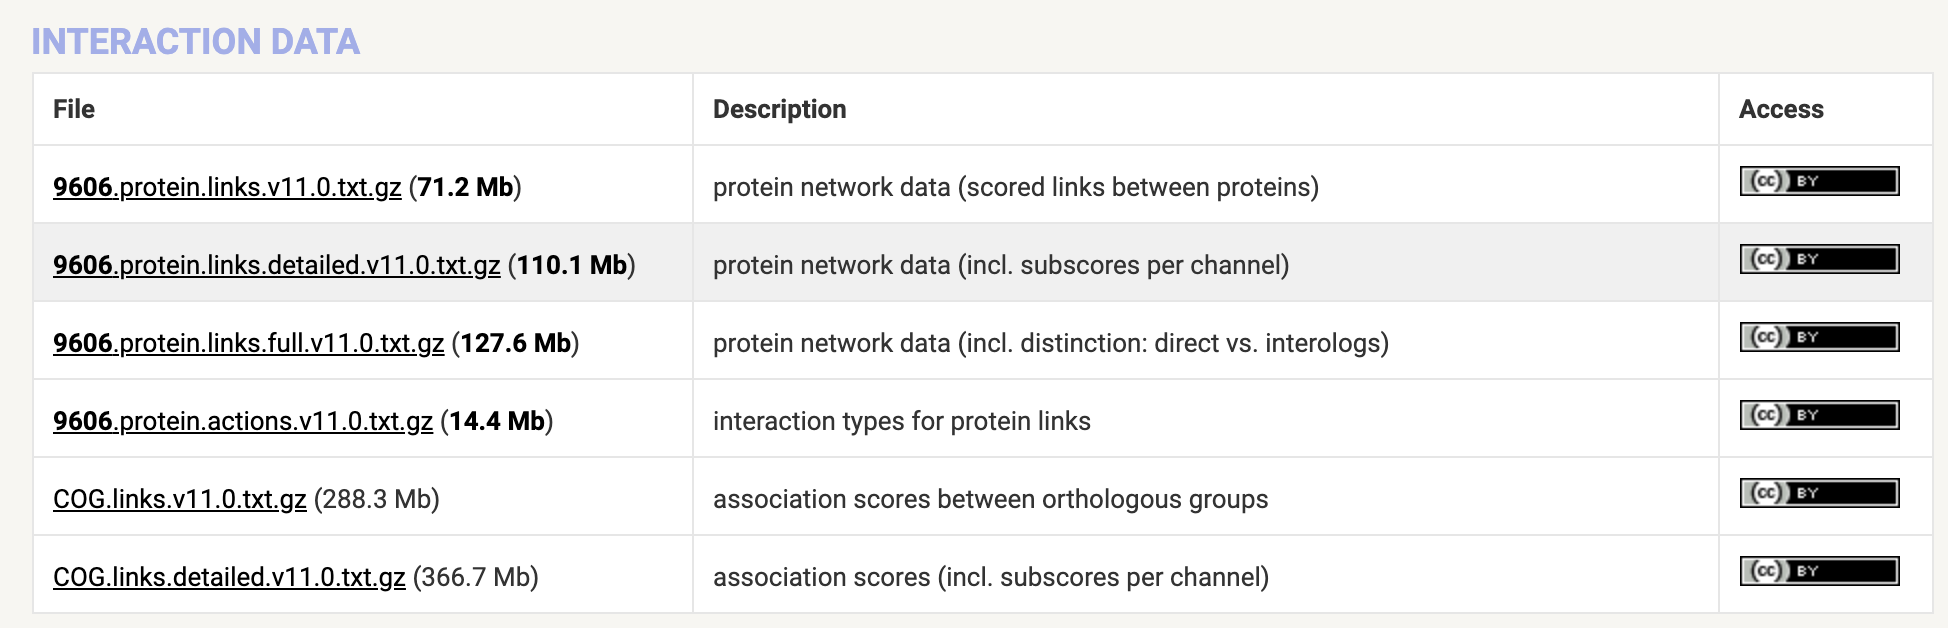
一般我们想知道某个蛋白会与哪些其他蛋白互作,以及互作的类型,然后做下游分析,信息都在这几个文件里了。
注:有哪些互作关系需要好好搞清楚,移步help,https://string-db.org/cgi/help.pl?sessionId=yMNmD7s36wS8
Docs » User documentation » Getting started » Evidence
Conserved Neighborhood
Co-occurrence
Fusion
Co-expression
Experiments
Databases
Text mining
每一个PPI关系的证据来源是不同的,选择你需要的证据。我觉得里面最可靠的就是Experiments, Databases和Text mining了。
当然,我们是高手,能用更简单的方法绝不用复杂的,那么STRING的API了解一下。
用任意脚本语言读以下格式化地址:
https://string-db.org/api/[output-format]/interaction_partners?identifiers=[your_identifiers]&[optional_parameters]
就能得到一个dataframe结果,不用下载,不用筛选,速度更快,随调随用。
实例,我想知道HDAC4的互作蛋白,可以这么抓:
老鼠:Mus%20musculus
url <- "https://string-db.org/api/tsv/interaction_partners?identifiers=HDAC4&species=Homo%20sapiens"

webDf <- read.table(url, header=T)

head(webDf)

       stringId_A      stringId_B preferredName_A preferredName_B ncbiTaxonId score

1 ENSP00000264606 ENSP00000080059           HDAC4           HDAC7        9606 0.934

2 ENSP00000264606 ENSP00000202967           HDAC4           SIRT4        9606 0.809

3 ENSP00000264606 ENSP00000209873           HDAC4            AAAS        9606 0.901

4 ENSP00000264606 ENSP00000209875           HDAC4            CBX5        9606 0.779

5 ENSP00000264606 ENSP00000212015           HDAC4           SIRT1        9606 0.988

6 ENSP00000264606 ENSP00000215832           HDAC4           MAPK1        9606 0.572

  nscore fscore pscore ascore escore dscore   tscore

1      0      0      0  0.061  0.320   0.90 0.061985

2      0      0      0  0.052  0.166   0.00 0.778000

3      0      0      0  0.058  0.000   0.90 0.000000

4      0      0      0  0.062  0.463   0.54 0.159000

5      0      0      0  0.052  0.415   0.90 0.812000

6      0      0      0  0.000  0.433   0.00 0.276000
结果解读:
Output fields (TSV and JSON formats):
| Field | Description |
|---|---|
| stringId_A | STRING identifier (protein A) |
| stringId_B | STRING identifier (protein B) |
| preferredName_A | common protein name (protein A) |
| preferredName_B | common protein name (protein B) |
| ncbiTaxonId | NCBI taxon identifier |
| score | combined score |
| nscore | gene neighborhood score |
| fscore | gene fusion score |
| pscore | phylogenetic profile score |
| ascore | coexpression score |
| escore | experimental score |
| dscore | database score |
| tscore | textmining score |
抓其他信息改下API就行了
还有很多工具是基于STRING做富集分析的,也可以了解一下,主要看自己需求。
待续~
PPI | protein-protein interaction | 蛋白互作分析的更多相关文章
- BioGRID 互作数据库
01 — BioGRID BioGRID 是 Biological General Repository for Interactionh Datasets 的缩写(网址为 https://thebi ...
- 下载STRING数据库检索互作关系结果为空,但是在STRING网站却能检索出互作关系,为什么呢???关键词用的是蛋白ID(ENSP开头)
首先介绍下两种方法: 一.本地分析 1.在STRING数据库下载人的互作文件,如下图,第一个文件 https://string-db.org/cgi/download.pl?sessionId=HGr ...
- 汇编语言(学习笔记----寄存器CPU互作原理)
一.段寄存器 1.段寄存器就是提供段地址的,8086CPU有4个段寄存器:CS(代码段寄存器),DS(数据段寄存器),SS(堆栈段寄存器),ES(附加段寄存器) 2.当8086CPU要访问内存时,由这 ...
- 解读人:谭亦凡,Macrophage phosphoproteome analysis reveals MINCLE-dependent and -independent mycobacterial cord factor signaling(巨噬细胞磷酸化蛋白组学分析揭示MINCLE依赖和非依赖的分支杆菌索状因子信号通路)(MCP换)
发表时间:2019年4月 IF:5.232 一. 概述: 分支杆菌索状因子TDM(trehalose-6,6’-dimycolate)能够与巨噬细胞C-型凝集素受体(CLR)MINCLE结合引起下游通 ...
- 蛋白组DIA分析:Spectronaut软件使用指南
官方文档: https://biognosys.com/media.ashx/spectronautmanual.pdf 0. 准备 Spectronaut软件是蛋白组DIA分析最常用的谱图解析软件之 ...
- 用R的igraph包来画蛋白质互作网络图 | PPI | protein protein interaction network | Cytoscape
igraph语法简单,画图快速. Cytoscape专业,个性定制. 最终效果图: 当然也可以用Cytoscape来画. 参考:Network visualization with R Cytosca ...
- Quantitative proteomics of Uukuniemi virus-host cell interactions reveals GBF1 as proviral host factor for phleboviruses(乌库涅米病毒-宿主细胞互作的定量蛋白质组学揭示了GBF1是个白蛉病毒的前病毒宿主因子)-解读人:谭亦凡
期刊名:Molecular & Cellular Proteomics 发表时间:(2019年12月) IF:4.828 单位:1德国海德堡大学附属医院2德国汉诺威医科大学3德国亥姆霍茲感染研 ...
- Mol Cell Proteomics. |王欣然| 基于微粒的蛋白聚合物捕获技术让能满足多种不同需求的蛋白质组学样品制备方法成为可能
大家好,本周分享的是发表在Molecular & Cellular Proteomics. 上的一篇关于蛋白质组学样本质谱分析前处理方法改进的文章,题目是Protein aggregation ...
- Journal of Proteome Research | SAAVpedia: identification, functional annotation, and retrieval of single amino acid variants for proteogenomic interpretation | SAAV的识别、功能注释和检索 | (解读人:徐洪凯)
文献名:SAAVpedia: identification, functional annotation, and retrieval of single amino acid variants fo ...
随机推荐
- 检测U盘插入、拨出状态
头文件 #include <Dbt.h> 关键代码: LRESULT CALLBACK WndProc(HWND hWnd, UINT message, WPARAM wParam, LP ...
- github仓库的初步使用
github是被戏称为男人们的朋友圈,在github里可以很方便的和同伴合作.以下是github初步建立的步骤.(由于我已经安装好了,所有没有插入图片,如果有未降到的问题先自行百度,如果我后续碰到有关 ...
- css 快捷修改 checkbox 及 radio的背景图
在CSS内选择要修改的input input[type=checkbox]:disabled{ //input类型等于复选框并且是disabled状态的所有(根据情况自由指定) -webkit-app ...
- if语句&switch&Scanner
if流程控制语句: if 语句的用语法如下: if(boolean表达式){ //如果条件为true那么执行 } 只有条件为true时才会执行,否则执行if语句后面的代码. 实例代码: public ...
- java多线程探究
本文主要是一些线程理论性的知识,随后将贴出研究的源码,包含线程池,锁,线程组等简单的demo,欢迎大家下载1.进程:每个进程都有独立的代码和数据空间(进程上下文),进程间的切换会有较大的开销,一个进程 ...
- Centos7 安装tomcat
- js 常用代码
//获取url中的参数 function getUrlParam(name) { var reg = new RegExp("(^|&)" + name + "= ...
- Python strip()与lstrip()、rstrip()
.strip()方法可以根据条件遍历字符串中的字符并一一去除 默认去除字符串中的头尾空格 “ Alins ”.“ AA BB CC ”用了之后就是 “Alins”.“AA BB CC” ...
- php读取文件使用redis的pipeline(管道)导入大批量数据
需求:需要做一个后台上传TXT文件,读取其中的内容,然后导入redis库中.要求速度快,并且支持至少10W以上的数据,而内容也就一个字段存类似openid和QQ 传统做法:我一开始做的时候就老套路,遍 ...
- centos6.5 MySQL数据库的安装
<div id="home"><div id="header"> <div id="blogTitle"> ...