
【python实现卷积神经网络】优化器的实现(SGD、Nesterov、Adagrad、Adadelta、RMSprop、Adam)
代码来源:https://github.com/eriklindernoren/ML-From-Scratch
卷积神经网络中卷积层Conv2D(带stride、padding)的具体实现:https://www.cnblogs.com/xiximayou/p/12706576.html
激活函数的实现(sigmoid、softmax、tanh、relu、leakyrelu、elu、selu、softplus):https://www.cnblogs.com/xiximayou/p/12713081.html
损失函数定义(均方误差、交叉熵损失):https://www.cnblogs.com/xiximayou/p/12713198.html
先看下优化器实现的代码:
import numpy as np

from mlfromscratch.utils import make_diagonal, normalize

# Optimizers for models that use gradient based methods for finding the

# weights that minimizes the loss.

# A great resource for understanding these methods:

# http://sebastianruder.com/optimizing-gradient-descent/index.html

class StochasticGradientDescent():

    def __init__(self, learning_rate=0.01, momentum=0):

        self.learning_rate = learning_rate

        self.momentum = momentum

        self.w_updt = None

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.w_updt is None:

            self.w_updt = np.zeros(np.shape(w))

        # Use momentum if set

        self.w_updt = self.momentum * self.w_updt + (1 - self.momentum) * grad_wrt_w

        # Move against the gradient to minimize loss

        return w - self.learning_rate * self.w_updt

class NesterovAcceleratedGradient():

    def __init__(self, learning_rate=0.001, momentum=0.4):

        self.learning_rate = learning_rate

        self.momentum = momentum

        self.w_updt = np.array([])

    def update(self, w, grad_func):

        # Calculate the gradient of the loss a bit further down the slope from w

        approx_future_grad = np.clip(grad_func(w - self.momentum * self.w_updt), -1, 1)

        # Initialize on first update

        if not self.w_updt.any():

            self.w_updt = np.zeros(np.shape(w))

        self.w_updt = self.momentum * self.w_updt + self.learning_rate * approx_future_grad

        # Move against the gradient to minimize loss

        return w - self.w_updt

class Adagrad():

    def __init__(self, learning_rate=0.01):

        self.learning_rate = learning_rate

        self.G = None # Sum of squares of the gradients

        self.eps = 1e-8

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.G is None:

            self.G = np.zeros(np.shape(w))

        # Add the square of the gradient of the loss function at w

        self.G += np.power(grad_wrt_w, 2)

        # Adaptive gradient with higher learning rate for sparse data

        return w - self.learning_rate * grad_wrt_w / np.sqrt(self.G + self.eps)

class Adadelta():

    def __init__(self, rho=0.95, eps=1e-6):

        self.E_w_updt = None # Running average of squared parameter updates

        self.E_grad = None   # Running average of the squared gradient of w

        self.w_updt = None   # Parameter update

        self.eps = eps

        self.rho = rho

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.w_updt is None:

            self.w_updt = np.zeros(np.shape(w))

            self.E_w_updt = np.zeros(np.shape(w))

            self.E_grad = np.zeros(np.shape(grad_wrt_w))

        # Update average of gradients at w

        self.E_grad = self.rho * self.E_grad + (1 - self.rho) * np.power(grad_wrt_w, 2)

        RMS_delta_w = np.sqrt(self.E_w_updt + self.eps)

        RMS_grad = np.sqrt(self.E_grad + self.eps)

        # Adaptive learning rate

        adaptive_lr = RMS_delta_w / RMS_grad

        # Calculate the update

        self.w_updt = adaptive_lr * grad_wrt_w

        # Update the running average of w updates

        self.E_w_updt = self.rho * self.E_w_updt + (1 - self.rho) * np.power(self.w_updt, 2)

        return w - self.w_updt

class RMSprop():

    def __init__(self, learning_rate=0.01, rho=0.9):

        self.learning_rate = learning_rate

        self.Eg = None # Running average of the square gradients at w

        self.eps = 1e-8

        self.rho = rho

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.Eg is None:

            self.Eg = np.zeros(np.shape(grad_wrt_w))

        self.Eg = self.rho * self.Eg + (1 - self.rho) * np.power(grad_wrt_w, 2)

        # Divide the learning rate for a weight by a running average of the magnitudes of recent

        # gradients for that weight

        return w - self.learning_rate *  grad_wrt_w / np.sqrt(self.Eg + self.eps)

class Adam():

    def __init__(self, learning_rate=0.001, b1=0.9, b2=0.999):

        self.learning_rate = learning_rate

        self.eps = 1e-8

        self.m = None

        self.v = None

        # Decay rates

        self.b1 = b1

        self.b2 = b2

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.m is None:

            self.m = np.zeros(np.shape(grad_wrt_w))

            self.v = np.zeros(np.shape(grad_wrt_w))

        self.m = self.b1 * self.m + (1 - self.b1) * grad_wrt_w

        self.v = self.b2 * self.v + (1 - self.b2) * np.power(grad_wrt_w, 2)

        m_hat = self.m / (1 - self.b1)

        v_hat = self.v / (1 - self.b2)

        self.w_updt = self.learning_rate * m_hat / (np.sqrt(v_hat) + self.eps)

        return w - self.w_updt
这里导入了了mlfromscratch.utils中的make_diagonal, normalize函数,它们在data_manipulation.py中。但是好像没有用到,还是去看一下这两个函数:
def make_diagonal(x):

    """ Converts a vector into an diagonal matrix """

    m = np.zeros((len(x), len(x)))

    for i in range(len(m[0])):

        m[i, i] = x[i]

    return m
def normalize(X, axis=-1, order=2):

    """ Normalize the dataset X """

    l2 = np.atleast_1d(np.linalg.norm(X, order, axis))

    l2[l2 == 0] = 1

    return X / np.expand_dims(l2, axis)
make_diagonal()的作用是将x中的元素变成对角元素。
normalize()函数的作用是正则化。
补充:
- np.linalg.norm(x, ord=None, axis=None, keepdims=False):需要注意ord的值表示的是范数的类型。
- np.atleast_1d():改变维度,将输入直接视为1维,比如np.atleast_1d([1])的输出就是[1]
- np.expand_dims():用于扩展数组的维度,要深入了解还是得去查一下。
然后再看看优化器的实现,以最常用的随机梯度下降为例:
class StochasticGradientDescent():

    def __init__(self, learning_rate=0.01, momentum=0):

        self.learning_rate = learning_rate

        self.momentum = momentum

        self.w_updt = None

    def update(self, w, grad_wrt_w):

        # If not initialized

        if self.w_updt is None:

            self.w_updt = np.zeros(np.shape(w))

        # Use momentum if set

        self.w_updt = self.momentum * self.w_updt + (1 - self.momentum) * grad_wrt_w

        # Move against the gradient to minimize loss

        return w - self.learning_rate * self.w_updt
直接看带动量的随机梯度下降公式:

这里的β就是动量momentum的值,一般取值是0.9。正好是对应上面的公式,最后更新W和b就是:
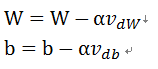
其中 α就表示学习率learning_rate。
至于不同优化器之间的优缺点就不在本文的考虑追之中了,可以自行去查下。
【python实现卷积神经网络】优化器的实现(SGD、Nesterov、Adagrad、Adadelta、RMSprop、Adam)的更多相关文章
- 各种优化器对比--BGD/SGD/MBGD/MSGD/NAG/Adagrad/Adam
指数加权平均 (exponentially weighted averges) 先说一下指数加权平均, 公式如下: \[v_{t}=\beta v_{t-1}+(1-\beta) \theta_{t} ...
- 各种优化方法总结比较(sgd/momentum/Nesterov/adagrad/adadelta)
前言 这里讨论的优化问题指的是,给定目标函数f(x),我们需要找到一组参数x,使得f(x)的值最小. 本文以下内容假设读者已经了解机器学习基本知识,和梯度下降的原理. Batch gradient d ...
- 基于Python的卷积神经网络和特征提取
基于Python的卷积神经网络和特征提取 用户1737318发表于人工智能头条订阅 224 在这篇文章中: Lasagne 和 nolearn 加载MNIST数据集 ConvNet体系结构与训练 预测 ...
- 深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam)
深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam) 深度学习笔记(一):logistic分类 深度学习笔记(二):简单神经网络,后向传播算法及实现 ...
- 【python实现卷积神经网络】开始训练
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
- 【python实现卷积神经网络】卷积层Conv2D反向传播过程
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
- 【python实现卷积神经网络】全连接层实现
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
- 【python实现卷积神经网络】批量归一化层实现
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
- 【python实现卷积神经网络】池化层实现
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
随机推荐
- Linux进程间通信-eventfd
Linux进程间通信-eventfd eventfd是linux 2.6.22后系统提供的一个轻量级的进程间通信的系统调用,eventfd通过一个进程间共享的64位计数器完成进程间通信,这个计数器由在 ...
- 详解POI的使用方法(DOM和SAX的方式)及存在的不足
简介 Apache POI是一套基于 OOXML 标准(Office Open XML)和 OLE2 标准来读写各种格式文件的 Java API,也就是说只要是遵循以上标准的文件,POI 都能够进行读 ...
- 【Weiss】【第03章】练习3.18:检查平衡符号
[练习3.18]用下列语言编写检测平衡符号的程序 a.Pascal ( begin/end, ( ), [ ], { } ). b.C语言( /* */, ( ), [ ], { }). c.解释如何 ...
- linux 执行计划任务crontab
crontab 一些常用的命令 service crond start //启动服务 service crond stop //关闭服务 service crond restart //重启服务 se ...
- asp.net core 3.x 微信小程序登录库(也可用于abp)
视频教程(使用+实现原理):https://share.weiyun.com/57HKopT 建议直接看视频 源码地址:https://github.com/bxjg1987/abpGeneralMo ...
- Swift 4.0 字典(Dictionary)学习
定义字典常量(常量只有读操作) let dictionary1 = ["key1": 888, "key2": 999] let dictionary2: [S ...
- .net core 依赖注入, autofac 简单使用
综述 ASP.NET Core 支持依赖注入, 也推荐使用依赖注入. 主要作用是用来降低代码之间的耦合度. 什么是控制反转? 控制反转(Inversion of Control,缩写为IoC),是面 ...
- GAN的五大有趣应用
引言 你能看出这张照片中面部的共同点吗? 这些人都不是真实存在的!这些面部图像都是由GAN技术生成的. "GAN"这个词是由Ian Goodfellow在2014年提出的,但相关概 ...
- 震惊!程序员的福音!不需要敲代码就能完成复杂的逻辑应用? —— Azure Logic App
(大家看完标题可能以为是营销号,哈哈哈哈哈哈哈哈哈...客官请留步, 正经博主....好吧) 今天我们的主题是Azure Logic Apps Azure Logic Apps 是什么? 官方解释:h ...
- [AI开发]一个例子说明机器学习和深度学习的关系
深度学习现在这么火热,大部分人都会有‘那么它与机器学习有什么关系?’这样的疑问,网上比较它们的文章也比较多,如果有机器学习相关经验,或者做过类似数据分析.挖掘之类的人看完那些文章可能很容易理解,无非就 ...