
bs4爬取笔趣阁小说
参考链接:https://www.cnblogs.com/wt714/p/11963497.html
模块:requests,bs4,queue,sys,time
步骤:给出URL--> 访问URL --> 获取数据 --> 保存数据
第一步:给出URL
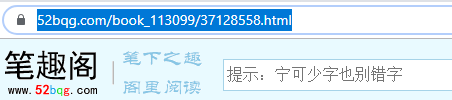
百度搜索笔趣阁,进入相关网页,找到自己想要看的小说,如“天下第九”,打开第一章,获得第一章的URL:https://www.52bqg.com/book_113099/37128558.html
第二步:访问URL
def get_content(url):

    try:

        # 进入主页

        # https://www.52bqg.com/

        # 随便搜索一步小说,找出变化规律

        # https://www.52bqg.com/book_110102/

        headers = {

            'User-Agent': ""

        }

        res = requests.get(url=url, headers=headers)

        res.encoding = "gbk"

        content = res.text

        return content

    except:

        s = sys.exc_info()

        print("Error '%s' happened on line %d" % (s[1], s[2].tb_lineno))

        return "ERROR"
返回的是此页面的内容
第三步:获取数据
def parseContent(first_url, content):

    soup = BeautifulSoup(content, "html.parser")

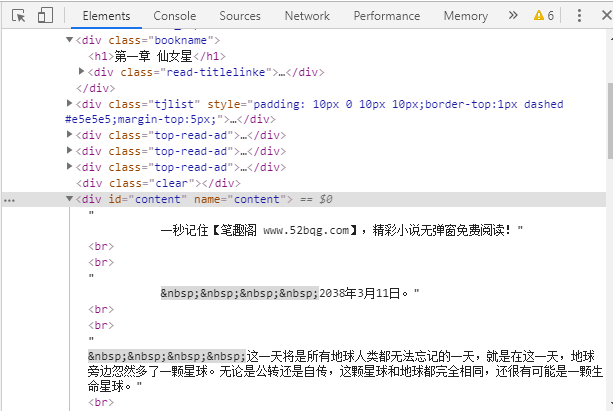
    chapter = soup.find(name='div', class_="bookname").h1.text

    content = soup.find(name="div", id="content").text
chapter获取的就是每一章的名称,例如:第一章 仙女星
content获取的就是每一章的内容,例如:这一天将是所有地球。。。。
第四步:保存数据
def save(chapter, content):

    filename = 文件名字

    f = open(filename, "a+", encoding="utf-8")

    f.write("".join(chapter) + "\n")

    f.write("".join(content.split()[2:]) + "\n")

    f.close()
以上就是爬取数据的一般步骤,介绍了一章是如何爬取下来的,那么一本小说,有很多很多章,全部爬取下来的话,就将上面的步骤一次又一次的进行就好了。
这里采取的方法是队列形式,首先给出第一章的url,存放到一个队列中,然后从队列中提取url进行访问,在访问过程中找到第二章的url,放入队列中,然后提取第二个url访问,依次类推,直到将小说所有章节爬取下来,队列为空为止。文件名字这一块,也是通过访问小说的url获取到小说名字,然后以小说名字命名txt的名字。
完整代码如下:
#!/usr/bin/env python

# _*_ coding: UTF-8 _*_

"""=================================================

@Project -> File    : Operate_system_ModeView_structure -> get_book_exe.py

@IDE     : PyCharm

@Author  : zihan

@Date    : 2020/4/25 10:28

@Desc    :爬取笔趣阁小说: https://www.52bqg.com/

            将url放入一个队列中Queue

            访问第一章的url得到第二章的url,放入队列,依次类推

================================================="""

import requests

from bs4 import BeautifulSoup

import sys

import time

import queue

# 获取内容

def get_content(url):

    try:

        # 进入主页

        # https://www.52bqg.com/

        # 随便搜索一步小说,找出变化规律

        # https://www.52bqg.com/book_110102/

        headers = {

            'User-Agent': "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.87 Safari/537.36"

        }

        res = requests.get(url=url, headers=headers)  # 获取小说目录界面

        res.encoding = "gbk"

        content = res.text

        return content

    except:

        s = sys.exc_info()

        print("Error '%s' happened on line %d" % (s[1], s[2].tb_lineno))

        return "ERROR"

# 解析内容

def parseContent(q, first_url, content):

    base_url_list = first_url.split("/")

    html_order = base_url_list[-1]

    last_number = first_url.find(html_order)

    base_url = first_url[:last_number]

    soup = BeautifulSoup(content, "html.parser")

    chapter = soup.find(name='div', class_="bookname").h1.text

    content = soup.find(name="div", id="content").text

    save(base_url, chapter, content)

    # 如果存在下一个章节的链接,则将链接加入队列

    next1 = soup.find(name='div', class_="bottem").find_all('a')[3].get('href')

    if next1 != base_url:

        q.put(next1)

    # print(next1)

    return q

def save(base_url, chapter, content):

    book_name = get_book_name(base_url)

    filename = book_name + ".txt"

    f = open(filename, "a+", encoding="utf-8")

    f.write("".join(chapter) + "\n")

    f.write("".join(content.split()[2:]) + "\n")

    f.close()

# 获取书名

def get_book_name(base_url):

    content = get_content(base_url)

    soup = BeautifulSoup(content, "html.parser")

    name = soup.find(name='div', class_="box_con").h1.text

    return name

def main():

    first_url = input("请输入小说第一章的链接:")

    start_time = time.time()

    # 进入主页

    # https://www.52bqg.com/

    # 随便搜索一步小说,找出变化规律

    # https://www.52bqg.com/book_110102/

    q = queue.Queue()

    # 小说第一章链接

    # first_url = "https://www.52bqg.com/book_110102/35620490.html"

    q.put(first_url)

    while not q.empty():

        content = get_content(q.get())

        q = parseContent(q, first_url, content)

    end_time = time.time()

    project_time = end_time - start_time

    print("下载用时:", project_time)

if __name__ == '__main__':

    main()
欢迎大家分享一些新发现。
bs4爬取笔趣阁小说的更多相关文章
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- Python爬取笔趣阁小说,有趣又实用
上班想摸鱼?为了摸鱼方便,今天自己写了个爬取笔阁小说的程序.好吧,其实就是找个目的学习python,分享一下. 1. 首先导入相关的模块 import os import requests from ...
- scrapycrawl 爬取笔趣阁小说
前言 第一次发到博客上..不太会排版见谅 最近在看一些爬虫教学的视频,有感而发,大学的时候看盗版小说网站觉得很能赚钱,心想自己也要搞个,正好想爬点小说能不能试试做个网站(网站搭建啥的都不会...) 站 ...
- python应用:爬虫框架Scrapy系统学习第四篇——scrapy爬取笔趣阁小说
使用cmd创建一个scrapy项目: scrapy startproject project_name (project_name 必须以字母开头,只能包含字母.数字以及下划线<undersco ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- HttpClients+Jsoup抓取笔趣阁小说,并保存到本地TXT文件
前言 首先先介绍一下Jsoup:(摘自官网) jsoup is a Java library for working with real-world HTML. It provides a very ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- 爬虫入门实例:利用requests库爬取笔趣小说网
w3cschool上的来练练手,爬取笔趣看小说http://www.biqukan.com/, 爬取<凡人修仙传仙界篇>的所有章节 1.利用requests访问目标网址,使用了get方法 ...
- python入门学习之Python爬取最新笔趣阁小说
Python爬取新笔趣阁小说,并保存到TXT文件中 我写的这篇文章,是利用Python爬取小说编写的程序,这是我学习Python爬虫当中自己独立写的第一个程序,中途也遇到了一些困难,但是最后 ...
随机推荐
- Spring Boot WebFlux-10——WebFlux 实战图书管理系统
前言 本篇内容我们会实现如下图所示的城市管理系统,因为上面案例都用的是 City,所以这里直接使用城市作为对象,写一个简单的城市管理系统,如图所示: 结构 类似上面讲的工程搭建,新建一个工程编写此案例 ...
- 你,确定了解Java的String字符串?
本文将描述JDK6中String.intern()是如何实现的,以及在JDK7和JDK8中对字符串池化技术做了哪些改变. String池化介绍 String池化就是把一些值相同,但是标识符不同的字符串 ...
- LuatOS | 全新在线模拟器,随时随地发挥创意
LuatOS --运行在嵌入式硬件的实时操作系统,开启全新物联网生态. 聚焦嵌入式应用生态,内置功能可支持绝大多数物联网应用场景.深度整合Lua语言,只需少量内存和Flash空间就能运行.不局限于合宙 ...
- 从架构师角度谈谈mybatis-plus可能存在的问题
存在这么一个情况:对于缺营养的人来说,医生更倾向于建议他选择纯牛奶,而不是有机奶(因其有添加剂).然而,大部分人却更加倾向于选择有机奶, 因其口感不错,因此,对于选择纯牛奶还是有机奶,这是个博弈问题. ...
- JDK并发包二
JDK并发包二 线程复用--线程池 在线程池中,总有那么几个活跃的线程,当程序需要线程时可以从池子中随便拿一个控线程,当程序执行完毕,线程不关闭,而是将这个线程退会到池子,等待使用. JDK提供了一套 ...
- electron-ipc通信性能分析
electron-ipc通信性能分析 electron的主进程和渲染进程间通信方案 ipc通信 借助外部存储通信(通过ipc通知其它进程去读取) 方案描述 ipc通信 使用 主进程 ==> 渲染 ...
- .Net EF Core千万级数据实践
.Net 开发中操作数据库EF一直是我的首选,工作和学习也一直在使用.EF一定程度的提高了开发速度,开发人员专注业务,不用编写sql.方便的同时也产生了一直被人诟病的一个问题性能低下. EF Core ...
- 什么是DDoS黑洞路由?
1. 什么是DDoS黑洞路由? DDoS黑洞路由/过滤(有时称为黑孔)是缓解DDoS攻击的一种对策,网络流量将被路由到"黑洞"中并且丢失.如果在没有特定限制条件下实施黑洞过滤,合法 ...
- pip安装setuptools_rust报错
公司项目中有主备CDN存在,由于阿里云以及腾讯云的预热功能不支持自动(一般是云函数),所以就根据云厂商给的脚本稍作更改,手动传入数据来进行预热. 由于之前部署在centos7.7系统python2.7 ...
- SpringBoot缓存管理(一) 默认缓存管理
前言 Spring框架支持透明地向应用程序添加缓存对缓存进行管理,其管理缓存的核心是将缓存应用于操作数据的方法(包括增删查改等),从而减少操作数据的执行次数(主要是查询,直接从缓存中读取数据),同时不 ...