
python入门学习之Python爬取最新笔趣阁小说
Python爬取新笔趣阁小说,并保存到TXT文件中
我写的这篇文章,是利用Python爬取小说编写的程序,这是我学习Python爬虫当中自己独立写的第一个程序,中途也遇到了一些困难,但是最后迎刃而解了。这个程序非常的简单,程序的大概就是先获取网页的源代码,然后在网页的源代码中提取每个章节的url,获取之后,在通过每个url去获取文章的内容,在进行提取内容,然后就是保存到本地,一TXT的文件类型保存。
大概是这样
1:获取网页源代码
2:获取每章的url
3:获取每章的内容
4:下载保存文件中
1、首先就是先安装第三方库requests,这个库,打开cmd,输入pip install requests回车就可以了,等待安装。然后测试
2、然后就可以编写程序了,首先获取网页源代码,也可以在浏览器查看和这个进行对比。
s = requests.Session()

url = 'https://www.xxbiquge.com/2_2634/'  # 这里可以进行更改你想要爬取小说的url

html = s.get(url)

html.encoding = 'utf-8'

print(html.text)    #获取网页源代码
运行后显示网页源代码
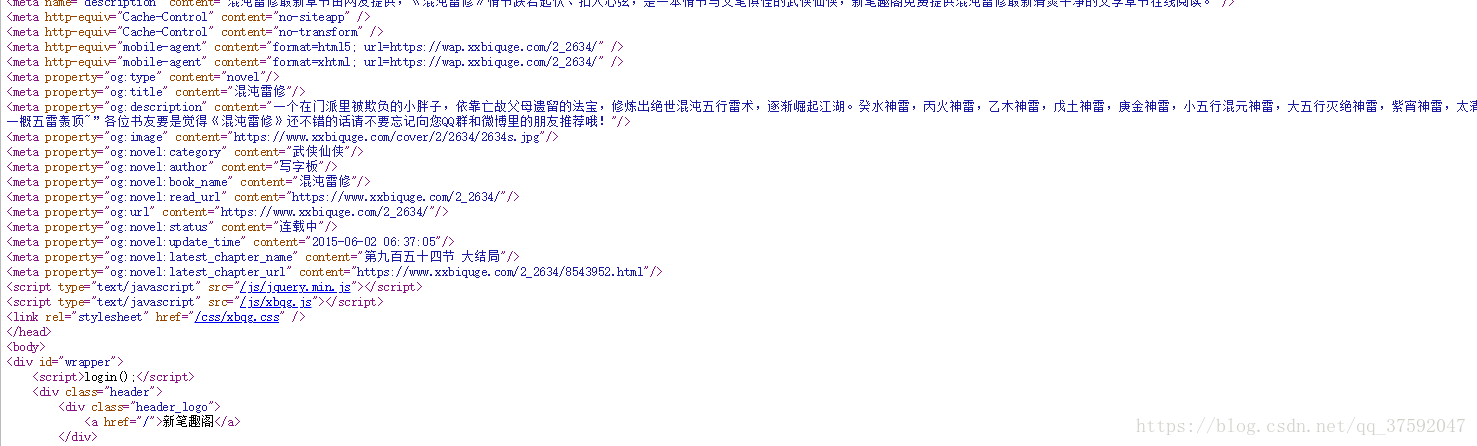
按F12查看
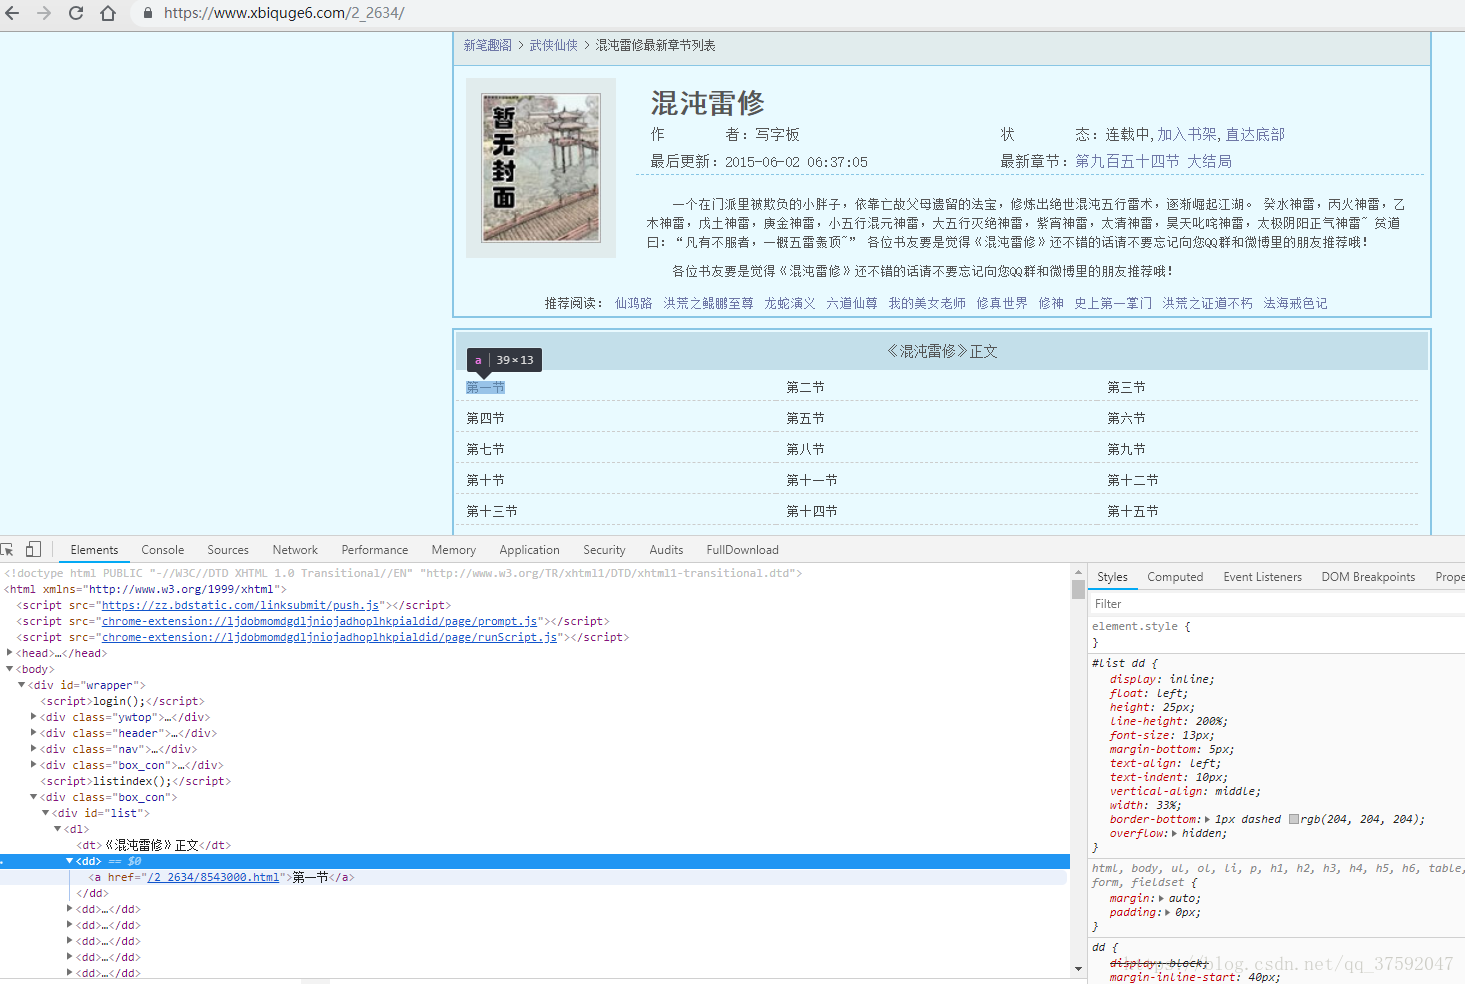
这样就说明这是对的
3、然后进行获取网页源代码中的每章url,进行提取
caption_title_1 = re.findall(r'<a href="(/2_2634/.*?\.html)">.*?</a>',html.text)

print(caption_title_1)

由于过多,就剪切了这些,看到这些URL,你可能想问为什么不是完整的,这是因为网页中的本来就不完整,需要进行拼凑得到完整的url
for i in caption_title_1:

    caption_title_1 = 'https://www.xxbiquge.com'+i
这样就完成了,就可以得到完整的了
4、下面就是获取章节名,和章节内容
   #获取章节名

    name = re.findall(r'<meta name="keywords" content="(.*?)" />',r1.text)[0]         # 提取章节名

    print(name)

    file_name.write(name)

    file_name.write('\n')

    # 获取章节内容

    chapters = re.findall(r'<div id="content">(.*?)</div>',r1.text,re.S)[0]            #提取章节内容

    chapters = chapters.replace(' ', '') # 后面的是进行数据清洗

    chapters = chapters.replace('readx();', '')

    chapters = chapters.replace('& lt;!--go - - & gt;', '')

    chapters = chapters.replace('<!--go-->', '')

    chapters = chapters.replace('()', '')
5、转换字符串和保存文件
 # 转换字符串

    s = str(chapters)

    s_replace = s.replace('<br/>',"\n")

    while True:

        index_begin = s_replace.find("<")

        index_end = s_replace.find(">",index_begin+1)

        if index_begin == -1:

            break

        s_replace = s_replace.replace(s_replace[index_begin:index_end+1],"")

    pattern = re.compile(r' ',re.I)

    fiction = pattern.sub(' ',s_replace)

    file_name.write(fiction)

    file_name.write('\n')
6、完整的代码
import requests

import re

s = requests.Session()

url = 'https://www.xxbiquge.com/2_2634/'

html = s.get(url)

html.encoding = 'utf-8'

# 获取章节

caption_title_1 = re.findall(r'<a href="(/2_2634/.*?\.html)">.*?</a>',html.text)

# 写文件

path = r'C:\Users\Administrator\PycharmProjects\untitled\title.txt'     # 这是我存放的位置,你可以进行更改

file_name = open(path,'a',encoding='utf-8')

# 循环下载每一张

for i in caption_title_1:

   caption_title_1 = 'https://www.xxbiquge.com'+i

   # 网页源代码

   s1 = requests.Session()

   r1 = s1.get(caption_title_1)

   r1.encoding = 'utf-8'

   # 获取章节名

   name = re.findall(r'<meta name="keywords" content="(.*?)" />',r1.text)[0]

   print(name)

   file_name.write(name)

   file_name.write('\n')

   # 获取章节内容

   chapters = re.findall(r'<div id="content">(.*?)</div>',r1.text,re.S)[0]

   chapters = chapters.replace(' ', '')

   chapters = chapters.replace('readx();', '')

   chapters = chapters.replace('& lt;!--go - - & gt;', '')

   chapters = chapters.replace('<!--go-->', '')

   chapters = chapters.replace('()', '')

   # 转换字符串

   s = str(chapters)

   s_replace = s.replace('<br/>',"\n")

   while True:

       index_begin = s_replace.find("<")

       index_end = s_replace.find(">",index_begin+1)

       if index_begin == -1:

           break

       s_replace = s_replace.replace(s_replace[index_begin:index_end+1],"")

   pattern = re.compile(r' ',re.I)

   fiction = pattern.sub(' ',s_replace)

   file_name.write(fiction)

   file_name.write('\n')

file_name.close()
7、修改你想要爬取小说url后再进行运行,如果出现错误,可能是存放位置出错,可以再保存文件地址修改为你要存放的地址,然后就结束了
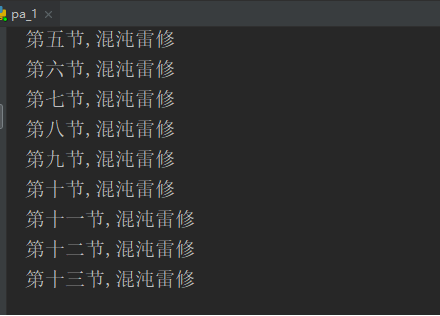
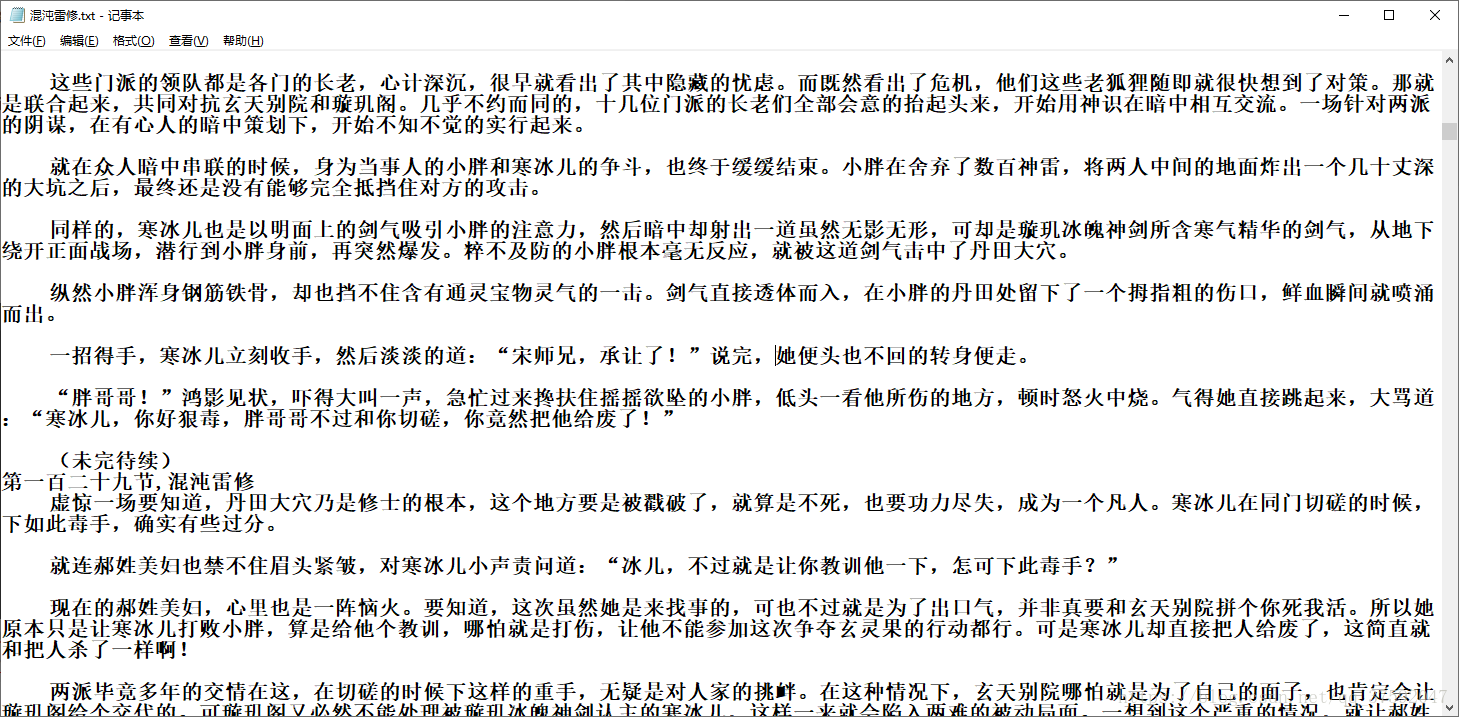
就是爬取的完整的小说,是不是很简单,,希望能对你所帮助
最后送上一点小福利吧
链接:https://pan.baidu.com/s/1sMxwTn7P2lhvzvWRwBjFrQ
提取码:kt2v
链接容易被举报过期,如果失效了就在这里领取吧
python入门学习之Python爬取最新笔趣阁小说的更多相关文章
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- bs4爬取笔趣阁小说
参考链接:https://www.cnblogs.com/wt714/p/11963497.html 模块:requests,bs4,queue,sys,time 步骤:给出URL--> 访问U ...
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- Python爬虫学习之正则表达式爬取个人博客
实例需求:运用python语言爬取http://www.eastmountyxz.com/个人博客的基本信息,包括网页标题,网页所有图片的url,网页文章的url.标题以及摘要. 实例环境:pytho ...
- python应用:爬虫框架Scrapy系统学习第四篇——scrapy爬取笔趣阁小说
使用cmd创建一个scrapy项目: scrapy startproject project_name (project_name 必须以字母开头,只能包含字母.数字以及下划线<undersco ...
- Python入门:全站url爬取
<p>作为一个安全测试人员,面对一个大型网站的时候,手工测试很有可能测试不全,这时候就非常需要一个通用型的网站扫描器.当然能直接扫出漏洞的工具也有很多,但这样你只能算是一个工具使用者,对于 ...
- Python爬取笔趣阁小说,有趣又实用
上班想摸鱼?为了摸鱼方便,今天自己写了个爬取笔阁小说的程序.好吧,其实就是找个目的学习python,分享一下. 1. 首先导入相关的模块 import os import requests from ...
- scrapycrawl 爬取笔趣阁小说
前言 第一次发到博客上..不太会排版见谅 最近在看一些爬虫教学的视频,有感而发,大学的时候看盗版小说网站觉得很能赚钱,心想自己也要搞个,正好想爬点小说能不能试试做个网站(网站搭建啥的都不会...) 站 ...
- HttpClients+Jsoup抓取笔趣阁小说,并保存到本地TXT文件
前言 首先先介绍一下Jsoup:(摘自官网) jsoup is a Java library for working with real-world HTML. It provides a very ...
随机推荐
- API开放平台接口设计-------基于OAuth2.0协议方式
1,简介OAuth http://www.ruanyifeng.com/blog/2019/04/oauth_design.html OAuth 是什么? http://www.ruanyifeng. ...
- C#算法实现获取树的高度
我们知道,树类型作为数据结构中的重要一员,树的很多实现都是来自递归.本文想要实现的就是在桌面客户端项目开发中,经常用到的树结构(.Net平台下有个控件为TreeView).事实上,我们可能因业务需求自 ...
- gold 波浪
- 图解GC流程
GC流程是每一个Java开发人员都应该掌握的内容.你知道什么时候触发Minor GC?什么时候触发 Minor GC 的过程是怎么样的?Full GC 的过程又是怎么样的?这一切都要从「压死骆驼 ...
- 面试中常问的五种IO模型和BIO,NIO,AIO
一,五种IO模型: 一个IO操作可以分为两个步骤:发起IO请求和实际的IO操作例如:1.操作系统的一次写操作分为两步:第一步,将数据从用户空间拷贝到系统空间:第二步,从系统空间往网卡写.2.一次读操作 ...
- javascript入门 之 zTree(十四 增删查改)(二)
<!DOCTYPE html> <HTML> <HEAD> <TITLE> ZTREE DEMO - addNodes / editName / rem ...
- coding++:漫画版-了解什么是分布式事务?
————— 第二天 ————— ———————————— 假如没有分布式事务: 在一系列微服务系统当中,假如不存在分布式事务,会发生什么呢?让我们以互联网中常用的交易业务为例子: 上图中包含了库存 ...
- tf.train.MomentumOptimizer 优化器
tf.train.MomentumOptimizer( learning_rate, momentum, use_locking=False, use_nesterov=False, name='Mo ...
- std::string::append函数
string& append (const string& str); string& append (const string& str, size_t subpos ...
- JAVA开发中相对路径,绝对路径全面总结
JAVA开发中相对路径,绝对路径全面总结 博客分类: Java综合 JavaJSP应用服务器Servlet网络应用 1.基本概念的理解 绝对路径:绝对路径就是你的主页上的文件或目录在硬盘上真正的路径, ...