
scrapycrawl 爬取笔趣阁小说
前言
第一次发到博客上..不太会排版见谅
最近在看一些爬虫教学的视频,有感而发,大学的时候看盗版小说网站觉得很能赚钱,心想自己也要搞个,正好想爬点小说能不能试试做个网站(网站搭建啥的都不会...)
站点拥有的全部小说不全,只能使用crawl爬全站
不过写完之后发现用scrapy爬的也没requests多线程爬的快多少,保存也不好一本保存,由于scrapy是异步爬取,不好保存本地为txt文件,只好存mongodb 捂脸
下面是主代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy.linkextractors import LinkExtractor

from scrapy.spiders import CrawlSpider, Rule

from biquge5200.items import Biquge5200Item

class BqgSpider(CrawlSpider):

    name = 'bqg'

    allowed_domains = ['bqg5200.com']

    start_urls = ['https://www.bqg5200.com/']

    rules = (

        Rule(LinkExtractor(allow=r'https://www.bqg5200.com/book/\d+/'),

            follow=True),

        Rule(LinkExtractor(allow=r'https://www.bqg5200.com/xiaoshuo/\d+/\d+/'),

             follow=False),

        Rule(LinkExtractor(allow=r'https://www.bqg5200.com/xiaoshuo/\d+/\d+/\d+/'),

             callback='parse_item', follow=False),

    )

    def parse_item(self, response):

        name = response.xpath('//div[@id="smallcons"][1]/h1/text()').get()

        zuozhe = response.xpath('//div[@id="smallcons"][1]/span[1]/text()').get()

        fenlei = response.xpath('//div[@id="smallcons"][1]/span[2]/a/text()').get()

        content_list = response.xpath('//div[@id="readerlist"]/ul/li')

        for li in content_list:

            book_list_url = li.xpath('./a/@href').get()

            book_list_url = response.urljoin(book_list_url)

            yield scrapy.Request(book_list_url,

                                 callback=self.book_content,

                                 meta={'info':(name,zuozhe,fenlei)})

    def book_content(self,response):

        name, zuozhe, fenlei,= response.meta.get('info')

        item = Biquge5200Item(name=name,zuozhe=zuozhe,fenlei=fenlei)

        item['title'] = response.xpath('//div[@class="title"]/h1/text()').get()

        content = response.xpath('//div[@id="content"]//text()').getall()

        # 试试可不可以把 列表前两个值不要 取[2:]

        content = list(map(lambda x:x.replace('\r\n',''),content))

        content = list(map(lambda x: x.replace('ads_yuedu_txt();', ''), content))

        item['content'] = list(map(lambda x: x.replace('\xa0', ''), content))

        item['url'] = response.url

        yield item
items.py
import scrapy

class Biquge5200Item(scrapy.Item):

    name = scrapy.Field()

    zuozhe = scrapy.Field()

    fenlei = scrapy.Field()

    title = scrapy.Field()

    content = scrapy.Field()

    url = scrapy.Field()
middlewares.py
import user_agent

class Biquge5200DownloaderMiddleware(object):

    def process_request(self, request, spider):

        request.headers['user-agent'] = user_agent.generate_user_agent()
这是当初看视频学到随机useragent库,但是忘记到底是怎么导入的了....
由于网站没有反爬,我只习惯性谢了个user-agent, 有需要你们到时候自己写一个ua和ip的把..
Pipeline.py
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: https://doc.scrapy.org/en/latest/topics/item-pipeline.html

import pymongo

class Biquge5200Pipeline(object):

    def open_spider(self,spider):

        self.client = pymongo.MongoClient()

        self.db = self.client.bqg

    def process_item(self, item, spider):

        name = item['name']

        zuozhe = item['zuozhe']

        fenlei = item['fenlei']

        coll = ' '.join([name,zuozhe,fenlei])

        self.db[coll].insert({"_id":item['url'],

                              "title":item['title'],

                              "content":item['content']})

        return item

    def close_spider(self, spider):

        self.client.close()
将获取到的item中书名,作者,分类作为数据库的集合名,将_id替换为item['url'],之后可以用find().sort("_id":1)排序,默认存储在本地的mongodb中,
windows端开启mongodb,开启方式--->>net start mongodb
linux端不太清楚,请百度
settings.py
BOT_NAME = 'biquge5200'

SPIDER_MODULES = ['biquge5200.spiders']

NEWSPIDER_MODULE = 'biquge5200.spiders'

DEFAULT_REQUEST_HEADERS = {

  'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

  'Accept-Language': 'en',

}

DOWNLOADER_MIDDLEWARES = {

   'biquge5200.middlewares.Biquge5200DownloaderMiddleware': 543,

}
ITEM_PIPELINES = {
   'biquge5200.pipelines.Biquge5200Pipeline': 300,
}
完成...
如果嫌弃爬的慢,使用scrapy_redis分布式,在本机布置几个分布式,适用于只有一台电脑,我默认你安装了scrapy_redis
现在settings.py中 添加几个参数
#使用Scrapy-Redis的调度器

SCHEDULER = "scrapy_redis.scheduler.Scheduler"

#利用Redis的集合实现去重

DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

#允许继续爬取

SCHEDULER_PERSIST = True

#设置优先级

SCHEDULER_QUEUE_CLASS = 'scrapy_redis.queue.SpiderPriorityQueue'

REDIS_HOST = 'localhost'      # ---------> 本机ip

REDIS_PORT = 6379
在主程序中将以下代码
class BqgSpider(CrawlSpider):

    name = 'bqg'

    allowed_domains = ['bqg5200.com']

    start_urls = ['https://www.bqg5200.com/']
改为
from scrapy_redis.spiders import RedisCrawlSpider    # -----> 导入

class BqgSpider(RedisCrawlSpider):            # ------> 改变爬虫父类

    name = 'bqg'

    allowed_domains = ['bqg5200.com']

    # start_urls = ['https://www.bqg5200.com/']

    redis_key = 'bqg:start_urls'          # ------> 记住这个redis终端有用,格式 一般写爬虫名:start_urls
开启mongodb
开启redis服务 ---->>> 进入redis安装目录 redis-server.exe redis.windows.conf
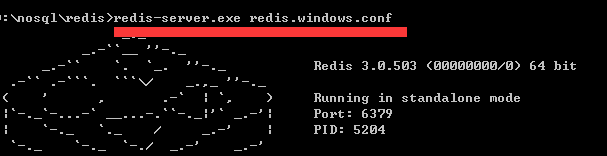
多开几个cmd窗口进入爬虫文件主程序文件中执行 scrapy runspider 爬虫名 ,爬虫进入监听状态
开启reids终端 --->>> redis-cli.exe

输入启动启动名称和url,是你需要开始爬取的页面
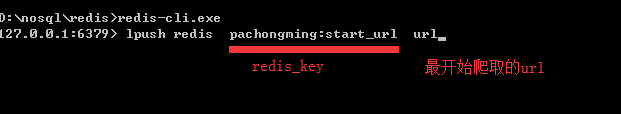
调试完成可以等待爬虫爬取了
多台主机爬取,需要看将那一台主机作为主机端,将settings.py中REDIS_HOST改为主机端的ip
保存的数据存储在哪也要考虑,如果直接保存在每台爬虫端,不需要要改动,如果想要汇总到一台机器上,
在Pipeline.py中修改
mongoclient(host="汇总数据的ip",post="monodb默认端口")
将修改好的文件复制每台爬虫端开启,汇总数据的电脑开启mongodb ,主机端开启redis服务,进入终端 输入 lpush 爬虫名:start_urls url
scrapycrawl 爬取笔趣阁小说的更多相关文章
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- bs4爬取笔趣阁小说
参考链接:https://www.cnblogs.com/wt714/p/11963497.html 模块:requests,bs4,queue,sys,time 步骤:给出URL--> 访问U ...
- Python爬取笔趣阁小说,有趣又实用
上班想摸鱼?为了摸鱼方便,今天自己写了个爬取笔阁小说的程序.好吧,其实就是找个目的学习python,分享一下. 1. 首先导入相关的模块 import os import requests from ...
- python应用:爬虫框架Scrapy系统学习第四篇——scrapy爬取笔趣阁小说
使用cmd创建一个scrapy项目: scrapy startproject project_name (project_name 必须以字母开头,只能包含字母.数字以及下划线<undersco ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- HttpClients+Jsoup抓取笔趣阁小说,并保存到本地TXT文件
前言 首先先介绍一下Jsoup:(摘自官网) jsoup is a Java library for working with real-world HTML. It provides a very ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- 爬虫入门实例:利用requests库爬取笔趣小说网
w3cschool上的来练练手,爬取笔趣看小说http://www.biqukan.com/, 爬取<凡人修仙传仙界篇>的所有章节 1.利用requests访问目标网址,使用了get方法 ...
- python入门学习之Python爬取最新笔趣阁小说
Python爬取新笔趣阁小说,并保存到TXT文件中 我写的这篇文章,是利用Python爬取小说编写的程序,这是我学习Python爬虫当中自己独立写的第一个程序,中途也遇到了一些困难,但是最后 ...
随机推荐
- [LC] 112. Path Sum
Given a binary tree and a sum, determine if the tree has a root-to-leaf path such that adding up all ...
- XGBoost使用篇(未完成)
1.截止到本文(20191104)sklearn没有集成xgboost算法,需要单独安装xgboost库,然后导入使用 xgboost官网安装说明 Pre-built binary wheel for ...
- Tomcat远程调试模式及利用Eclipse远程链接调试
1.启动tomcat到调试模式 进入到tomcat的bin目录下,执行命令./catalina.sh jpda run 启动日记会提示打开调试端口默认为8000 2.调试Eclipse远程连接tomc ...
- Mysql分区,分库和分表
作者说的非常清楚了,感谢.地址为:http://haitian299.github.io/2016/05/26/mysql-partitioning/. 本人项目实践,使用sharding-jdbc进 ...
- mac android sdk manager 无法更新(被墙)
http://www.androiddevtools.cn/ 一句话,相见恨晚!! 想把以前的旧安卓项目拿到MAC上 环境就卡住了,以前的包是4.4的,想试试5.0的,更新不动 Android Too ...
- [洛谷P4782] [模板] 2-SAT 问题
NOIp后第一篇题解. NOIp我考的很凉啊...... 题目传送门 之前讲过怎么判断2-SAT是否存在解. 至于如何构造一组解: 我们想到对tarjan缩点后的图进行拓扑排序. 那么对于代表0状态的 ...
- Thymeleaf模板笔记
1.常用标签: 使用thymeleaf模板,首要在html中引入: <html xmlns:th="http://www.thymeleaf.org"> 引入css.j ...
- js 实现数据结构 -- 散列(HashTable)
原文: 在Javascript 中学习数据结构与算法. 概念: HashTable 类, 也叫 HashMap 类,是 Dictionary 类的一种散列表实现方式. 散列算法的作用是尽可能快地在数据 ...
- virtualenv 个人指南
virtualenv是解决一个机器上多个应用需要的Python版本不一致的问题,virtualenv就是用来为一个应用创建一套"隔离"的Python运行环境,解决了解决了不同应用间 ...
- MyEclipse下Spring+Hibernate整合
目前,SSH(Struts+Spring+Hibernate)是Web开发的一种常用框架组合,Struts实现了MVC,Hibernate实现了关系对象映射,Spring实现了基于Bean的配置管理. ...