
利用python爬取全国水雨情信息
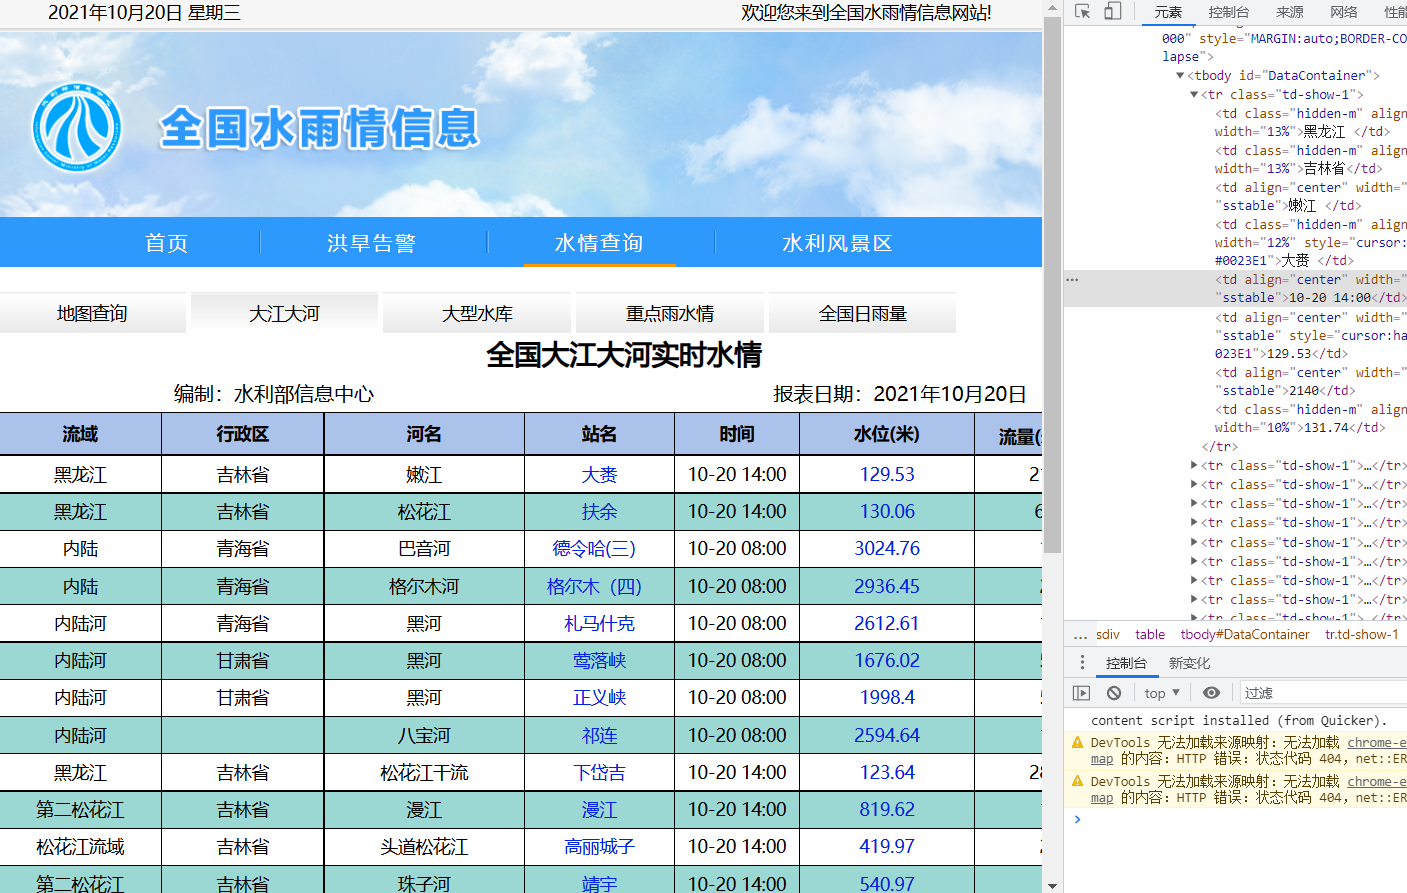
分析
我们没有找到接口,所以打算利用selenium来爬取。
代码
import datetime

import pandas as pd

from bs4 import BeautifulSoup

from selenium import webdriver

from selenium.webdriver.support.ui import WebDriverWait

from selenium.webdriver.common.by import By

from selenium.webdriver.support import expected_conditions as EC

from selenium.webdriver.chrome.options import Options #建议使用谷歌浏览器

import time

chrome_options = Options()

chrome_options.add_argument('--headless')

driver = webdriver.Chrome()

# 存储中英文对应的变量的中文名

word_dict = {"poiBsnm": "流域",

             "poiAddv": "行政区",

             "rvnm": "河名",

             "stnm": "站名",

             "tm": "时间",

             "zl": "水位(米)",

             "ql": "流量(立方米/秒)",

             "wrz": "警戒水位(米)"}

# 空df接收结果

rain_total = pd.DataFrame([])

url = 'http://xxfb.mwr.cn/sq_dxsk.html'

driver.get(url)

time.sleep(5)

infos = driver.find_elements_by_xpath("/html/body//tbody[@id='DataContainer']/tr")

# pd.set_option('display.max_columns', None)#所有列

# pd.set_option('display.max_rows', None)#所有行

# 列表提取

for info in infos:

    poiBsnm = info.find_element_by_xpath("./td[1]").text

    poiAddv = info.find_element_by_xpath("./td[2]").text

    rvnm = info.find_element_by_xpath("./td[3]").text

    stnm = info.find_element_by_xpath("./td[4]").text

    tm = info.find_element_by_xpath("./td[5]").text

    zl = info.find_element_by_xpath("./td[6]").text

    ql = info.find_element_by_xpath("./td[7]").text

    wrz = info.find_element_by_xpath("./td[8]").text

# 组成pandas对象

    rain_data = [[poiBsnm,poiAddv,rvnm,stnm,tm,zl,ql,wrz]]

    rain_df = pd.DataFrame(data=rain_data,columns=list(word_dict.values()))

    rain_total = pd.concat([rain_total,rain_df])

    print(rain_total)

# 关闭浏览器

driver.close()

# 保存数据

data_str = datetime.datetime.now().strftime('%Y_%m_%d')

rain_total.to_csv("%s_全国水雨情信息.csv" % (data_str),index=None, encoding="GB18030")
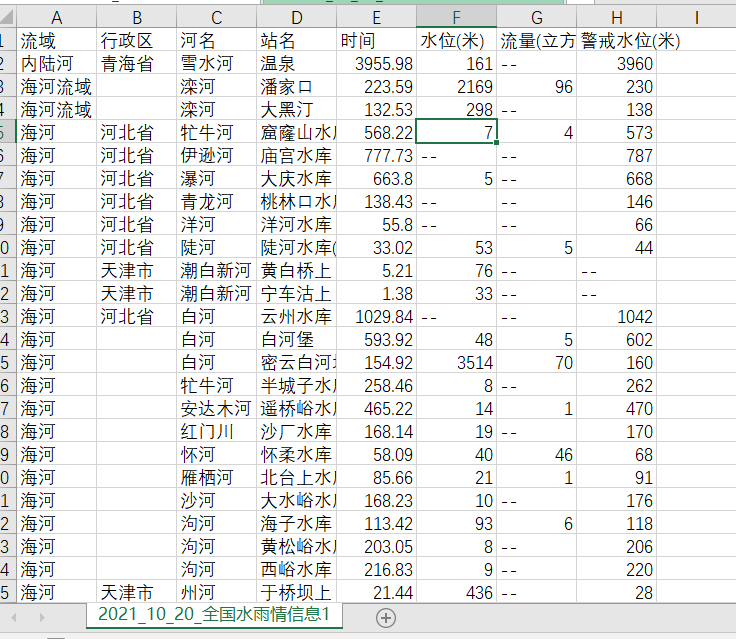
结果
反思
时间爬取出现了一点问题,我也很不理解,其次,循环哪里应该可以简洁代码,写的不是很好,第三,没有形成模块化的代码。还有就是谢谢崔工的支持。
利用python爬取全国水雨情信息的更多相关文章
- 利用python爬取贝壳网租房信息
最近准备换房子,在网站上寻找各种房源信息,看得眼花缭乱,于是想着能否将基本信息汇总起来便于查找,便用python将基本信息爬下来放到excel,这样一来就容易搜索了. 1. 利用lxml中的xpath ...
- 利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍 Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样.由于这个性质,Selenium也是一 ...
- 利用python爬取58同城简历数据
利用python爬取58同城简历数据 利用python爬取58同城简历数据 最近接到一个工作,需要获取58同城上面的简历信息(http://gz.58.com/qzyewu/).最开始想到是用pyth ...
- 利用python爬取城市公交站点
利用python爬取城市公交站点 页面分析 https://guiyang.8684.cn/line1 爬虫 我们利用requests请求,利用BeautifulSoup来解析,获取我们的站点数据.得 ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- python爬取 “得到” App 电子书信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 静觅 崔庆才 PS:如有需要Python学习资料的小伙伴可以加点击下 ...
- 用Python爬取智联招聘信息做职业规划
上学期在实验室发表时写了一个爬取智联招牌信息的爬虫. 操作流程大致分为:信息爬取——数据结构化——存入数据库——所需技能等分词统计——数据可视化 1.数据爬取 job = "通信工程师&qu ...
- 利用Python爬取朋友圈数据,爬到你开始怀疑人生
人生最难的事是自我认知,用Python爬取朋友圈数据,让我们重新审视自己,审视我们周围的圈子. 文:朱元禄(@数据分析-jacky) 哲学的两大问题:1.我是谁?2.我们从哪里来? 本文 jacky试 ...
- Python爬取房天下二手房信息
一.相关知识 BeautifulSoup4使用 python将信息写入csv import csv with open("11.csv","w") as csv ...
随机推荐
- vue 微信二维码扫码登录,附加 自定义样式
大概流程: 先安装 微信 的登录, 然后 局部引入,局部注册,方法调用,存 token,跳转路由 npm 安装 npm install vue-wxlogin --save-dev 微信安装 微信 ...
- CountDownLatch能不能在多个线程上添加await?
在CountDownLatch类的使用过程中,发现了一个很奇怪的现象: CountDownLatch countDownLatch = new CountDownLatch(2); Runnable ...
- JUnit5快速入门指南-2
重复测试中容易产生的问题 //结果类 private static int result = 0; public static int count(int x) throws InterruptedE ...
- appnium显式等待机制
强制等待: sleep不推荐全局隐式等待 全局隐式等待: 在服务端等待 driver.manage().timeouts().implicitlyWait(10, TimeUnit.SECONDS); ...
- python库--tensorflow--可视化
方法 返回值类型 参数 说明 tf.summary .FileWrite() 创建事件文件 logdir 文件保存路径(C盘), 通过tensorboard --logdir=文件路径(l ...
- Excel删除重复数据及用公式筛选重复项并标记颜色突出显示
当表格记录比较多时,常常会有重复数据,而重复记录往往只希望保存一条,因此需要把多余的删除:在 Excel 中,删除重复数据有两种方法,一种是用"删除重复数据"删除,另一种是用&qu ...
- ATR吊灯止损策略 (含有tbquant源码)
ATR吊灯止损策略定义: 做多,止损放在最高价之下N个ATR. 做空,止损放在最低价之上N个ATR. 该策略生成的止损点就像是从市场最高价的"天花板"上悬挂下来的吊灯.所以命名为A ...
- mybatis的mapper特殊字符转移以及动态SQL条件查询
前言 我们知道在项目开发中之前使用数据库查询,都是基于jdbc,进行连接查询,然后是高级一点jdbcTemplate进行查询,但是我们发现还是不是很方便,有大量重复sql语句,与代码偶合,效率低下,于 ...
- Xshell和Xftp - 下载安装
简介 Xshell 实际工作运用:连接Linux Xftp 实际工作运用:传输文件到Linux系统 下载安装 三连后评论区留言私发,此贴长期有效!!!
- Java学习之随堂笔记系列——day04
今日内容1.break和continue关键字以及循环嵌套 1.1 break和continue的区别? continue表示跳过当前循环,继续执行下一次循环break表示结束整个 ...