
爬取豆瓣电影影评,生成wordcloud词云,并利用监督学习根据评论自动打星
本文的完整源码在git位置:https://github.com/OceanBBBBbb/douban-ml
- 爬取豆瓣影评
爬豆瓣的影评比较简单,豆瓣没有做限制,甚至你都不用登陆就可以看全部,我这里用的bs4和urllib获取的页面信息:
# 获取页面

def get_html(url):

    head = {}

    head[

        'User-Agent'] = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'

    target_req = request.Request(url=url, headers=head)

    target_response = request.urlopen(target_req)

    target_html = target_response.read().decode('utf-8', 'ignore')

    # 创建BeautifulSoup对象

    listmain_soup = BeautifulSoup(target_html, 'lxml')

    return listmain_soup
获取页面后,解析页面上的评论内容,这里我拿了给出的评分、短评和展示的部分详细评价。
评分在这个页面里不是一个明显的数值,豆瓣用5种不同的class来表示用户的评星。我这里用了个
遍历找评分的办法。
# 解析豆瓣评论并存到文件中

def resolu_soup(soup_page):

    reviews = soup_page.find_all('div', class_='main review-item')

    for each_review in reviews:

        # 评分是1-5星,用class不同来表示的。allstar40 main-title-rating,h2里面是主评,<div class="short-content">是详评

        score = 0 #未知的评分

        for i in range(1, 6):

            class_name='allstar'+str(i*10)+' main-title-rating'

            score_maybe=each_review.find_all('span', class_=class_name)

            if(len(score_maybe)>0):

                score = i

        print("这个人的评分是"+str(score))

        short_review = each_review.find('h2').text.replace(' ','') #短评

        with open("../doc/data_fkwxr.txt", "a",encoding='utf-8') as f: #写到样本库用于--学习可能有没有分的

            f.write(short_review+" "+str(score)+'\n')

        long_review = each_review.find('div', class_='short-content').text.replace(' ','').replace('(展开)','')

        with open("../doc/fkwxr.txt", "a",encoding='utf-8') as f: #写在用于分析电影评价的文本里

            f.write(short_review+" "+long_review+'\n')
打开文本的方式with open("../doc/data_fkwxr.txt", "a",encoding='utf-8')
中的第二个参数,需要提前了解一下:
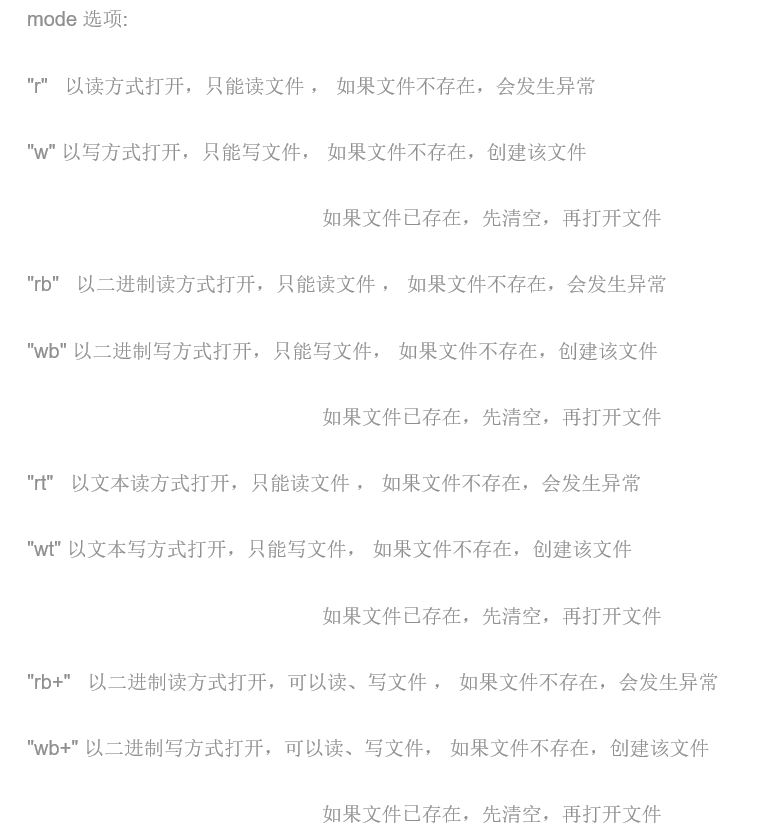
而这里的'a'是以追加的方式进行写入。
- 使用word-cloud直观看影评
因为我们拉取的文本是用户自由输入的,在使用word_cloud分析前,可以先用jieba分词预处理一下:
def build_key_word(path):  # 通过词频产生特征

    d = {}

    with open(path, encoding="utf-8") as fp:

        for line in fp:

            for word in jieba.cut(line.strip()):

                # p = re.compile(r'w', re.L)

                # result = p.sub("", word)

                # if not result or result == ' ':  # 空字符

                #     continue

                if len(word) > 1:  # 避免大量无意义的词语进入统计范围

                    d[word] = d.get(word, 0) + 1

    kw_list = sorted(d, key=lambda x: d[x], reverse=True)

    size = int(len(kw_list) * 0.3)  # 取最前的30%

    mood = set(kw_list[:size])

    mood_without_stop=list(mood)

    temp_list={}

    for ii in mood_without_stop:

        temp_list[ii]=d[ii]

    return temp_list
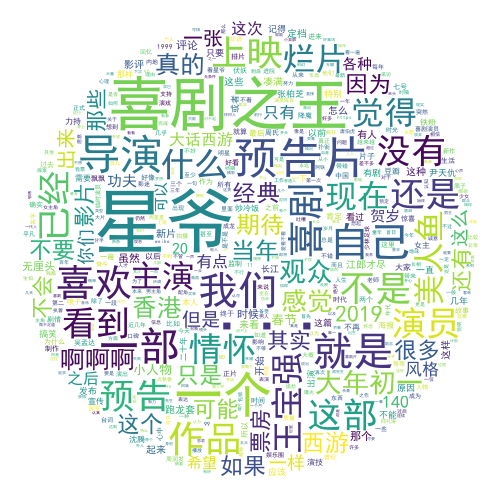
然后使用wordcloud生成图就可以了,这里在wordcloud官网有入门的详细教程,只是要得到一个图的话,还是比较简单的。
这里可以看一下电影《新喜剧之王》的效果图:
使用朴素贝叶斯算法进行分类训练,预测评论标题将给的评星
这里我为了图方便,前面存储这个的时候,存的就是影评的标题加已知的星级,而没有给评星的,就会是0,在训练前,我过滤了一下没有评星的,根据评论自己按常理,
给出了一个评星,不然数据实在是太少了。
# 简单的监督学习例子

# 使用朴素贝叶斯算法进行分类训练。

from nltk.stem import WordNetLemmatizer

from nltk.classify import NaiveBayesClassifier

import pickle

import jieba

def proc_text(text):

    # 分词

    raw_words = jieba.cut(text, cut_all=True)

    # 词形归一化

    wordnet_lematizer = WordNetLemmatizer()

    words = [wordnet_lematizer.lemmatize(raw_word) for raw_word in raw_words]

    # True 表示该词在文本中,为了使用nltk中的分类器

    return {word: True for word in words}

def train_data_from_txt(model_name,txt):

    # 读取文本

    # a = numpy.loadtxt('data_xxjzw.txt',encoding='UTF-8') #这个是读数的。。

    with open(txt, encoding="utf-8") as fp:

        train_data=[]

        for line in fp:

            txt_split=line.split(' ')

            train_data.append([proc_text(txt_split[0]),int(txt_split[1])])

        # 训练模型

        nb_model = NaiveBayesClassifier.train(train_data)

        # 把模型训练集存起来

        f = open(model_name, 'wb')

        pickle.dump(nb_model, f)

        f.close()

if __name__ == '__main__':

    # train_data_from_txt('data_xxjzw_classifier.pickle','../doc/data_xxjzw.txt') #得到心训练模型

    # # 测试模型

    text6 = '看预告片觉得这真是一部好极了的电影,期待正式上映'

    f = open('data_xxjzw_classifier.pickle', 'rb')

    classifier = pickle.load(f) #读取结果集就可以了

    f.close()

    print("预测本评论给出的评分:"+str(classifier.classify(proc_text(text6))))
爬取豆瓣电影影评,生成wordcloud词云,并利用监督学习根据评论自动打星的更多相关文章
- scrapy-redis爬取豆瓣电影短评,使用词云wordcloud展示
1.数据是使用scrapy-redis爬取的,存放在redis里面,爬取的是最近大热电影<海王> 2.使用了jieba中文分词解析库 3.使用了停用词stopwords,过滤掉一些无意义的 ...
- python 爬取豆瓣电影短评并wordcloud生成词云图
最近学到数据可视化到了词云图,正好学到爬虫,各种爬网站 [实验名称] 爬取豆瓣电影<千与千寻>的评论并生成词云 1. 利用爬虫获得电影评论的文本数据 2. 处理文本数据生成词云图 第一步, ...
- python 爬取豆瓣电影评论,并进行词云展示及出现的问题解决办法
本文旨在提供爬取豆瓣电影<我不是药神>评论和词云展示的代码样例 1.分析URL 2.爬取前10页评论 3.进行词云展示 1.分析URL 我不是药神 短评 第一页url https://mo ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- 爬取豆瓣电影排行top250
功能描述V1.0: 爬取豆瓣电影排行top250 功能分析: 使用的库 1.time 2.json 3.requests 4.BuautifulSoup 5.RequestException 上机实验 ...
- 【转】爬取豆瓣电影top250提取电影分类进行数据分析
一.爬取网页,获取需要内容 我们今天要爬取的是豆瓣电影top250页面如下所示: 我们需要的是里面的电影分类,通过查看源代码观察可以分析出我们需要的东西.直接进入主题吧! 知道我们需要的内容在哪里了, ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影
前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大家讲解一个完整爬虫的流程. 工具和环境 语言:python 2 ...
- urllib+BeautifulSoup无登录模式爬取豆瓣电影Top250
对于简单的爬虫任务,尤其对于初学者,urllib+BeautifulSoup足以满足大部分的任务. 1.urllib是Python3自带的库,不需要安装,但是BeautifulSoup却是需要安装的. ...
随机推荐
- ASP.NET Core 3.0预览版体验
目前.NET Core 3.0的版本为.NET Core 3.0 Preview 3,对应ASP.NET Core 3.0 Preview 3. ASP.NET Core 3.0 之后将不再支持.NE ...
- ISP PIPLINE (五) Denoise
what is the Denoise? Denoise就是图像去噪,平滑图像,并保留图像细节. why does Denoise? 图像在采集并转换为数字信号的过程会引入一些噪声,这些噪声会让图片看 ...
- Zepto.js_开始
https://zeptojs.com 轻量级的 JavaScript 库,移动端优先框架 针对移动端,处理了一系列如 click 点击延迟 毫秒 响应执行快 目前 API 完善的框架中体积最小的一个 ...
- Node.js_简介及其 npm 包管理器基本使用_npm_cnpm_yarn_cyarn
Node.js 既是语言也是平台,跳过了 Apache.Nginx 等 HTTP 服务器,直接面向前端开发 JavaScript 是由 ECMAScript.文档对象模型(DOM)和浏览器对象模型(B ...
- [LeetCode] Valid Tic-Tac-Toe State 验证井字棋状态
A Tic-Tac-Toe board is given as a string array board. Return True if and only if it is possible to r ...
- flexible.js 移动端自适应方案
一,flexible.js 的使用方式: github地址:https://github.com/amfe/lib-flexible 官方文档地址:https://github.com/amfe/ar ...
- Linux命令 df du
df: 列出文件系统的整体磁盘使用量 du: 评估文件系统的磁盘使用量 $ df [-ahikHTm] [目录或文件名] 参数: -a: 列出所有的文件系统,包括系统特有的/proc 等文件系统 -k ...
- Python 学习笔记2 变量
Python变量的一些命名规则和指南 每种编程语言都需要变量, 这些变量的命名,我们一般会遵守一些公认的规则. 已达到方便自己,他人阅读的好处. 变量只能包含字母.数字和下划线.变量可以以字母和下划线 ...
- AES加密的S盒和逆S盒的推导代码备份(C实现)
摘取自https://www.cnblogs.com/Junbo20141201/p/9369860.html,感谢原作者的详细解读. #include <stdio.h> ][] = { ...
- Luogu4587 [FJOI2016]神秘数
题目大意:给定一个长度为$n$的正整数序列$a_i$,$m$次询问,每次询问$[l,r]$,求最小的无法表示成$a_l,a_{l+1},\ldots,a_r$的子集之和的正整数. 数据范围:$1\le ...