
【十大经典数据挖掘算法】k
【十大经典数据挖掘算法】系列
1. 引言
k-means与kNN虽然都是以k打头,但却是两类算法——kNN为监督学习中的分类算法,而k-means则是非监督学习中的聚类算法;二者相同之处:均利用近邻信息来标注类别。
聚类是数据挖掘中一种非常重要的学习流派,指将未标注的样本数据中相似的分为同一类,正所谓“物以类聚,人以群分”嘛。k-means是聚类算法中最为简单、高效的,核心思想:由用户指定k个初始质心(initial centroids),以作为聚类的类别(cluster),重复迭代直至算法收敛。
2. 基本算法
在k-means算法中,用质心来表示cluster;且容易证明k-means算法收敛等同于所有质心不再发生变化。基本的k-means算法流程如下:
选取k个初始质心(作为初始cluster);

repeat:

    对每个样本点,计算得到距其最近的质心,将其类别标为该质心所对应的cluster;

    重新计算k个cluser对应的质心;

until 质心不再发生变化
对于欧式空间的样本数据,以平方误差和(sum of the squared error, SSE)作为聚类的目标函数,同时也可以衡量不同聚类结果好坏的指标:
SSE=k∑i=1∑x∈Cidist(x,ci)
表示样本点x到cluster Ci 的质心 ci 距离平方和;最优的聚类结果应使得SSE达到最小值。
下图中给出了一个通过4次迭代聚类3个cluster的例子:
k-means存在缺点:
k-means是局部最优的,容易受到初始质心的影响;比如在下图中,因选择初始质心不恰当而造成次优的聚类结果(SSE较大):
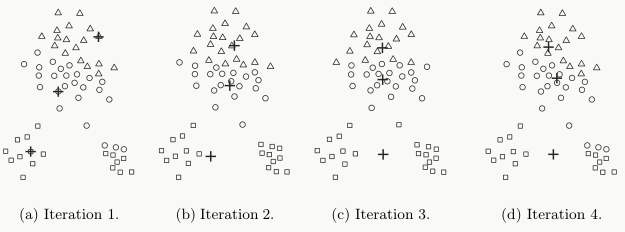
同时,k值的选取也会直接影响聚类结果,最优聚类的k值应与样本数据本身的结构信息相吻合,而这种结构信息是很难去掌握,因此选取最优k值是非常困难的。
3. 优化
为了解决上述存在缺点,在基本k-means的基础上发展而来二分 (bisecting) k-means,其主要思想:一个大cluster进行分裂后可以得到两个小的cluster;为了得到k个cluster,可进行k-1次分裂。算法流程如下:
初始只有一个cluster包含所有样本点;

repeat:

    从待分裂的clusters中选择一个进行二元分裂,所选的cluster应使得SSE最小;

until 有k个cluster
上述算法流程中,为从待分裂的clusters中求得局部最优解,可以采取暴力方法:依次对每个待分裂的cluster进行二元分裂(bisect)以求得最优分裂。二分k-means算法聚类过程如图:
从图中,我们观察到:二分k-means算法对初始质心的选择不太敏感,因为初始时只选择一个质心。
4. 参考资料
[1] Pang-Ning Tan, Michael Steinbach, Vipin Kumar, Introduction to Data Mining.
[2] Xindong Wu, Vipin Kumar, The Top Ten Algorithms in Data Mining.
【十大经典数据挖掘算法】k的更多相关文章
- 【十大经典数据挖掘算法】PageRank
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 我特地把PageRank作为[十大经 ...
- 【十大经典数据挖掘算法】SVM
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART SVM(Support Vector ...
- 【十大经典数据挖掘算法】Naïve Bayes
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 朴素贝叶斯(Naïve Bayes) ...
- 【十大经典数据挖掘算法】C4.5
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 决策树模型与学习 决策树(de ...
- 【十大经典数据挖掘算法】k-means
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 引言 k-means与kNN虽 ...
- 【十大经典数据挖掘算法】Apriori
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 关联分析 关联分析是一类非常有 ...
- 【十大经典数据挖掘算法】kNN
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 引言 顶级数据挖掘会议ICDM ...
- 【十大经典数据挖掘算法】CART
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 前言 分类与回归树(Class ...
- 【十大经典数据挖掘算法】EM
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 极大似然 极大似然(Maxim ...
随机推荐
- SPOJ DQUERY 离线树状数组+离散化
LINK 题意:给出$(n <= 30000)$个数,$q <= 2e5$个查询,每个查询要求给出$[l,r]$内不同元素的个数 思路:这题可用主席树查询历史版本的方法做,感觉这个比较容易 ...
- 使用Docker 快速搭建nuget本地服务器,Hosting private nuget server using docker in seconds!
Server #below line automatically creates the folder, mount the volumes and maps the ports. docker ru ...
- Spring Data JPA笔记
1. Spring Data JPA是什么 Spring Data JPA是Spring Data大家族中的一员,它对对持久层做了简化,用户只需要声明方法的接口,不需要实现该接口,Spring Dat ...
- 强连通图(最多加入几条边使得图仍为非强连通图)G - Strongly connected HDU - 4635
题目链接:https://cn.vjudge.net/contest/67418#problem/G 具体思路:首先用tarjan缩点,这个时候就会有很多个缩点,然后再选取一个含有点数最少,并且当前这 ...
- 项目开发 -- ZFS容量分配
存储池 allocated 池中已实际分配的存储空间量.该属性也可通过其简短列名alloc来引用. capacity 已用的池空间百分比.此属性也可通过其简短列名cap来引用. dedupratio ...
- flask插件系列之flask_restful设计API
前言 flask框架默认的路由和视图函数映射规则是通过在视图函数上直接添加路由装饰器来实现的,这使得路由和视图函数的对应关系变得清晰,但对于统一的API开发就变得不怎么美妙了,尤其是当路由接口足够多的 ...
- 问题解决:The content of the adapter has changed but ListView did not receive a notification
1. 不要在后台线程中直接调用adapter 2. 不要在后台线程中修改adapter绑定的数据 如果对adapter或者adapter绑定的数据是在线程中,加上runOnUiThread就可以了 r ...
- 修改帧大小和socket缓冲区大小(转)
修改帧大小和socket缓冲区大小 MTU (最大传输单元)的缺省值为1500. 通过下面命令将其改为9000(jumbo frame) % ifconfig eth0 mtu 9000 socket ...
- Funny Car Racing(最短路变形)
描述 There is a funny car racing in a city with n junctions and m directed roads. The funny part is: e ...
- C#矩形框沿直线移动
C#中用GDT+的一系列方式,可以绘制各种图形:点,直线,圆形,矩形...... C#中这些图形的绘制,一般教程的demo中给出的代码,是在Form1_Paint(object sender, Pai ...