
爬虫---Beautiful Soup 爬取图片
上一篇简单的介绍Beautiful Soup 的基本用法,这一篇写下如何爬取网站上的图片,并保存下来
爬取图片
1.找到一个福利网站:http://www.xiaohuar.com/list-1-1.html
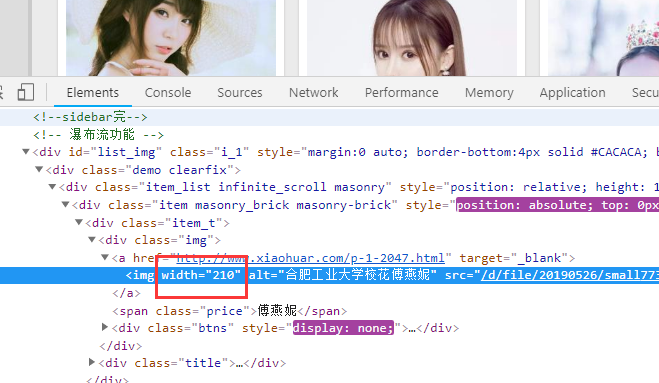
2.通过F12进行定位图片
3.通过下图可以看到标签为img,然后通过width="210"的属性
爬取方法
1.通过find_all()的方法进行查找图片位置
2.筛选出图片的URL和图片名称
3.筛选后会发现其中有一些图片URL不完整
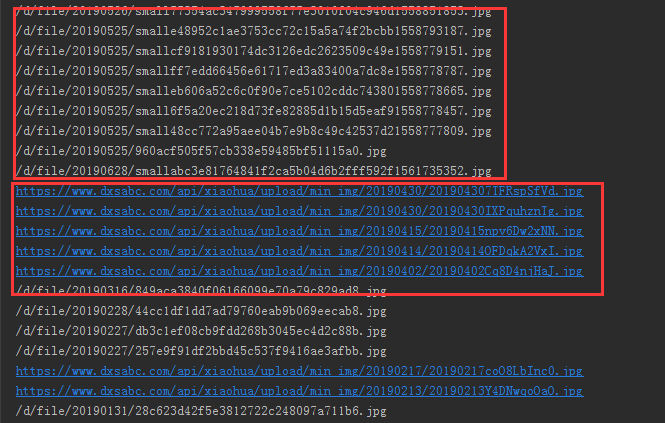
4.这个时候需要在代码中加一个判断,如何URL不完整 我们就给他补充完整
import requests

from bs4 import BeautifulSoup

import os

# 请求地址

url = 'http://www.xiaohuar.com/list-1-1.html'

html = requests.get(url).content

# BeautifulSoup 实例化

soup  = BeautifulSoup(html,'html.parser')

jpg_data = soup.find_all('img',width="")

for i in jpg_data:

    data = i['src']

    name = i['alt']

# 判断URL是否完整

    if "https://www.dxsabc.com/" not in data:

        data = 'http://www.xiaohuar.com'+ data
保存图片
1.判断一个文件夹是否存在,不存在就重新创建
2.request模块请求图片的URL
3.通过content返回图片二进制,进行写入文件夹中
# coding:utf-8

import requests

from bs4 import BeautifulSoup

import os

# 创建一个文件夹名称

FileName = 'tupian'

if not os.path.exists(os.path.join(os.getcwd(), FileName)):     # 新建文件夹

     print(u'建了一个名字叫做', FileName, u'的文件夹!')

     os.mkdir(os.path.join(os.getcwd(),'tupian'))

else:

    print(u'名字叫做', FileName, u'的文件夹已经存在了!')

url = 'http://www.xiaohuar.com/list-1-1.html'

html = requests.get(url).content    # 返回html

soup  = BeautifulSoup(html,'html.parser')   # BeautifulSoup对象

jpg_data = soup.find_all('img',width="") # 找到图片信息

for i in jpg_data:

    data = i['src'] # 图片的URL

    name = i['alt'] # 图片的名称

    if "https://www.dxsabc.com/" not in data:

        data = 'http://www.xiaohuar.com'+data

    r2 = requests.get(data)

    fpath = os.path.join(FileName,name)

    with open(fpath+'.jpg','wb+')as f : # 循环写入图片

        f.write(r2.content)

print('保存成功,快去查看图片吧!!')
图片就不贴了,喜欢的可以自己动手写一写。
爬虫---Beautiful Soup 爬取图片的更多相关文章
- 一起学爬虫——使用Beautiful Soup爬取网页
要想学好爬虫,必须把基础打扎实,之前发布了两篇文章,分别是使用XPATH和requests爬取网页,今天的文章是学习Beautiful Soup并通过一个例子来实现如何使用Beautiful Soup ...
- 使用Beautiful Soup爬取猫眼TOP100的电影信息
使用Beautiful Soup爬取猫眼TOP100的电影信息,将排名.图片.电影名称.演员.时间.评分等信息,提取的结果以文件形式保存下来. import time import json impo ...
- 爬虫---Beautiful Soup 初始
我们在工作中,都会听说过爬虫,那么什么是爬虫呢? 什么是网络爬虫 爬虫基本原理 所谓网络爬虫就是一个自动化数据采集工具,你只要告诉它要采集哪些数据,丢给它一个 URL,就能自动地抓取数据了.其背后的基 ...
- 爬虫---Beautiful Soup 通过添加不同的IP请求
上一篇爬虫写了如何应付反爬的一些策略也简单的举了根据UA的例子,今天写一篇如何根据不同IP进行访问豆瓣网获取排行版 requests添加IP代理 如果使用代理的话可以通过requests中的方法pro ...
- 爬虫---Beautiful Soup 反反爬虫事例
前两章简单的讲了Beautiful Soup的用法,在爬虫的过程中相信都遇到过一些反爬虫,如何跳过这些反爬虫呢?今天通过知乎网写一个简单的反爬中 什么是反爬虫 简单的说就是使用任何技术手段,阻止别人批 ...
- scrapy爬虫系列之三--爬取图片保存到本地
功能点:如何爬取图片,并保存到本地 爬取网站:斗鱼主播 完整代码:https://files.cnblogs.com/files/bookwed/Douyu.zip 主要代码: douyu.py im ...
- 爬虫-Beautiful Soup模块
阅读目录 一 介绍 二 基本使用 三 遍历文档树 四 搜索文档树 五 修改文档树 六 总结 一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通 ...
- python3爬虫-快速入门-爬取图片和标题
直接上代码,先来个爬取豆瓣图片的,大致思路就是发送请求-得到响应数据-储存数据,原理的话可以先看看这个 https://www.cnblogs.com/sss4/p/7809821.html impo ...
- Python爬虫学习 - day1 - 爬取图片
利用Python完成简单的图片爬取 最近学习到了爬虫,瞬时觉得很高大上,想取什么就取什么,感觉要上天.这里分享一个简单的爬取汽车之家文章列表的图片教程,供大家学习. 需要的知识点储备 本次爬虫脚本依赖 ...
随机推荐
- golang数据结构和算法之StackArray数组堆栈
用数组实现的堆栈, 另一种,是用链表实现的堆栈, 在各种不同的编程语言上, 实现都是类似的. StackArray.go package StackArray //基于数组实现的堆栈 const ar ...
- 蓝桥杯dfs搜索专题
2018激光样式 #include<bits/stdc++.h> using namespace std; /* dfs(i) 第i个激光机器 有两种选择:vis[i-1] == 0 时 ...
- layUI学习第一日:myeclipse中使用layUI
第一步:下载layUI,网址:https://www.layui.com/ 第二步:查看layUI解压后的内容,和官网解释各个文件夹的内容 第三部:在myeclipse中新建一个web project ...
- selenium定位元素的八种方法
web driver提供了八种元素定位的方法: id, name, class name, tag name, link text, partial link text, xpath, css sel ...
- 剑指Offer-6.旋转数组的最小数字(C++/Java)
题目: 把一个数组最开始的若干个元素搬到数组的末尾,我们称之为数组的旋转.输入一个非递减排序的数组的一个旋转,输出旋转数组的最小元素.例如数组{3,4,5,1,2}为{1,2,3,4,5}的一个旋转, ...
- vue 使用JavaScript表达式
vue使用JavaScript的运算方式 代码如下: <!doctype html> <html lang="en"> <head> <m ...
- WinCC中通过脚本禁用或启用Windows快捷键
有些项目要求WinCC全屏运行,并禁止通过操作系统快捷键切换到桌面,这时只需要在WinCC的计算机属性中勾选“禁用用于进行操作系统访问的快捷键”.此后当WinCC运行时,按Win键或Ctrl+Alt+ ...
- CF 938G Shortest Path Queries
又到了喜闻乐见的写博客清醒时间了233,今天做的依然是线段树分治 这题算是经典应用了吧,假的动态图(可离线)问题 首先不难想到对于询问的时间进行线段树分治,这样就可以把每一条边出现的时间区间扔进线段树 ...
- 小白专场-堆中的路径-c语言实现
目录 一.题意理解 二.堆的表示及其操作 三.主程序 更新.更全的<数据结构与算法>的更新网站,更有python.go.人工智能教学等着你:https://www.cnblogs.com/ ...
- JAVA基础系列:Object类
1. 万物皆对象 1. JVM在编译源代码时,在遇到没有继承Object的对象的时候,编译器会默认指定一个默认的父类Object 2. Object 和接口的关系,接口是否继承Object?接口没有继 ...