
爬虫---Beautiful Soup 初始
我们在工作中,都会听说过爬虫,那么什么是爬虫呢?
什么是网络爬虫
爬虫基本原理
所谓网络爬虫就是一个自动化数据采集工具,你只要告诉它要采集哪些数据,丢给它一个 URL,就能自动地抓取数据了。其背后的基本原理就是爬虫程序向目标服务器发起 HTTP 请求,然后目标服务器返回响应结果,爬虫客户端收到响应并从中提取数据,再进行数据清洗、数据存储工作。
爬虫基本流程
爬虫流程也是一个 HTTP 请求的过程,以浏览器访问一个网址为例,从用户输入 URL 开始,客户端通过 DNS 解析查询到目标服务器的 IP 地址,然后与之建立 TCP 连接,连接成功后,浏览器构造一个 HTTP 请求发送给服务器,服务器收到请求之后,从数据库查到相应的数据并封装成一个 HTTP 响应,然后将响应结果返回给浏览器,浏览器对响应内容进行数据解析、提取、渲染并最终展示在你面前。
Beautiful Soup简介
Beautiful Soup它通过定位HTML标签来格式化和组织复杂的网络信息,用python对象为我们展现XML结构信息。
Beautiful Soup每个节点都是Python对象,所有对象可以归纳为 4种:
1、Tag:表示一个标签对象;
2、 NavigableString:表示一个字符对象
3、 BeautifulSoup:表示一个HTML对象
4、Comment :表示一个注释对象
官方文档:https://www.crummy.com/software/BeautifulSoup/bs4/doc/index.zh.html
Beautiful Soup安装
打开cmd,通过pip安装
# 安装BeautifulSoup4

pip install BeautifulSoup4

Beautiful Soup使用方法
1.根据request进入到想要爬去的页面
2.导入BeautifulSoup模块
3.创建BeautifulSoup对象
项目实战
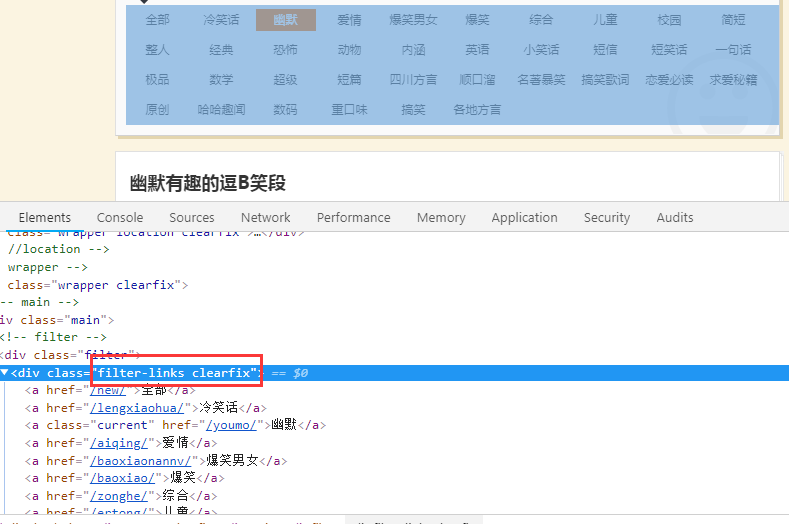
爬取有哪些笑话类型
# coding:utf-8

import requests

from bs4 import BeautifulSoup

# 通过request请求地址

r = requests.get("http://xiaohua.zol.com.cn/youmo/")

# 获取整个页面的html

bsobj = r.text

# BeautifulSoup 实例化

soup = BeautifulSoup(bsobj,'html.parser') # html.parser 是python自带的编辑器,如果不带会一直提示异常

name = soup.find_all(class_='filter-links clearfix')   # 找到全部的class内容

for i in name:

    title=i.select("a") # 查找关于a标签的所有内容

    for j in title:

        print(j.get_text())

执行结果:

全部

冷笑话

幽默

爱情

爆笑男女

爆笑

综合

儿童

校园

简短

整人

经典

恐怖

动物

内涵

英语

小笑话

短信

短笑话

一句话

极品

数学

超级

短篇

四川方言

顺口溜

名著暴笑

搞笑歌词

恋爱必读

求爱秘籍

原创

哈哈趣闻

数码

重口味

搞笑

各地方言
html.parser 是python自带的解析器,如果不带会一直提示异常
UserWarning: No parser was explicitly specified, so I'm using the best available HTML parser for this system ("lxml"). This usually isn't a problem, but if you run this code on another system, or in a different virtual environment, it may use a different parser and behave differently.

The code that caused this warning is on line 7 of the file XXXX. To get rid of this warning, pass the additional argument 'features="lxml"' to the BeautifulSoup constructor.

  blog = BeautifulSoup(r)
Beautiful Soup其他方法
print(soup.title)   # 获取页面的标题

print(soup.title.string)    # 获取页面标题字符串

print(soup.head)    # 获取页面head

print(soup.a)   # 获取页面第一个a标签

print(soup.find(class_='logo')) # 获取单个具体内容

print(soup.find_all(class_='logo')) # 获取页面全部内容

print(soup.get_text())  # 获取页面全部文字
同时tag也可以进行删改查
# 进行查看p标签下class携带的内容

print(soup.p['class'])

print(soup.p.get['class'])

# 可以对属性进行修改

soup.p['class']='NewClass'

# 删除标签

del soup.p['class']
爬虫---Beautiful Soup 初始的更多相关文章
- 爬虫---Beautiful Soup 通过添加不同的IP请求
上一篇爬虫写了如何应付反爬的一些策略也简单的举了根据UA的例子,今天写一篇如何根据不同IP进行访问豆瓣网获取排行版 requests添加IP代理 如果使用代理的话可以通过requests中的方法pro ...
- 爬虫---Beautiful Soup 反反爬虫事例
前两章简单的讲了Beautiful Soup的用法,在爬虫的过程中相信都遇到过一些反爬虫,如何跳过这些反爬虫呢?今天通过知乎网写一个简单的反爬中 什么是反爬虫 简单的说就是使用任何技术手段,阻止别人批 ...
- 爬虫-Beautiful Soup模块
阅读目录 一 介绍 二 基本使用 三 遍历文档树 四 搜索文档树 五 修改文档树 六 总结 一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通 ...
- 爬虫---Beautiful Soup 爬取图片
上一篇简单的介绍Beautiful Soup 的基本用法,这一篇写下如何爬取网站上的图片,并保存下来 爬取图片 1.找到一个福利网站:http://www.xiaohuar.com/list-1-1. ...
- 使用Beautiful Soup编写一个爬虫 系列随笔汇总
这几篇博文只是为了记录学习Beautiful Soup的过程,不仅方便自己以后查看,也许能帮到同样在学习这个技术的朋友.通过学习Beautiful Soup基础知识 完成了一个简单的爬虫服务:从all ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
- [转]python下很帅气的爬虫包 - Beautiful Soup 示例
原文地址http://blog.csdn.net/watsy/article/details/14161201 先发一下官方文档地址.http://www.crummy.com/software/Be ...
- Python爬虫利器:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.使用它来处理HTML页面就像JavaScript代码操作HTML DOM树一样方便.官方中文文档地址 1. 安 ...
- 一起学爬虫——使用Beautiful Soup爬取网页
要想学好爬虫,必须把基础打扎实,之前发布了两篇文章,分别是使用XPATH和requests爬取网页,今天的文章是学习Beautiful Soup并通过一个例子来实现如何使用Beautiful Soup ...
随机推荐
- USB免驱RFID读写器编程解析之一:智能卡篇
随着RFID应用的普及,越来越多的软件工程师需要使用RFID读写器编程来实现自己的需求.为了使软件工程师更快的了解RFID读写器的使 用,本文选择一款市面上常用的USB免驱RFID读写器SDT-HA来 ...
- Nginx之HTTPS
Nginx之HTTPS 1. HTTPS安全证书基本概述 为什么需要使用HTTPS,因为HTTP不安全,当我们使用http网站时,会遭到劫持和篡改,如果采用https协议,那么数据在传输过程中是加密的 ...
- 18-搭建本地 Registry
Docker Hub 虽然非常方便,但还是有些限制,比如: 需要 internet 连接,而且下载和上传速度慢. 上传到 Docker Hub 的镜像任何人都能够访问,虽然可以用私有 reposito ...
- Linux查看文件系统的挂载时间浅析
我们在Linux系统中如何找到文件系统的挂载时间呢,下面实验测试环境为RHEL 6.6,其它Linux版本没有验证测试.这个简单测试了一下常用的ext3/4.xfs.nfs文件系统. ext文件系统 ...
- 关于xshell连接limux界面按退格键不正常的问题
这个问题通过修改xshell终端属性可以解决,步骤如下: "文件" -> "属性" -> "终端" -> "键盘 ...
- 浅谈JS函数节流及应用场景
说完防抖,下面我们讲讲节流,规矩就不说了,先上代码: <!DOCTYPE html> <html lang="en"> <head> <m ...
- cf之kmp匹配稍稍改一改
看样例就知道要干嘛了 http://codeforces.com/contest/1200/problem/E 每次我们用新的串和答案串匹配,答案串的匹配位置是max(0,(int)ans.size( ...
- 【zabbix告警配置】zabbix服务配置邮件告警
一.安装邮件服务 在zabbix_server服务端安装邮件和邮件发送服务,这里可以参考我另一篇邮件服务部署文章:https://www.cnblogs.com/HeiDi-BoKe/p/118833 ...
- MySQL索引知识学习笔记
目录 一.索引的概念 二.索引分类 三.索引用法 四 .索引架构简介 五.索引适用的情况 六.索引不适用的情况 继我的上篇博客:Oracle索引知识学习笔记,再记录一篇MySQL的索引知识学习笔记,本 ...
- GO的执行原理以及GO命令
Go的执行原理以及Go的命令 一.Go的源码文件 Go 的源码文件分类: 如上图,分为三类: 1.命令源码文件: 声明自己属于 main 代码包.包含无参数声明和结果声明的 main 函数. 命令源码 ...